通义千问 2026 四档怎么选:Qwen3.8-Max / Qwen3.7-Plus / Qwen3.8-Flash / Qwen3.8-Omni-Flash 的真实能力、价格、上下文与适用场景对照清单
2026 年 10 月初的通义千问模型矩阵已经不是一年前的「Max + Plus + Turbo」三件套,而是按用途和能力被拆成了 4 条主线 + 5 条专用支线。timew.cn 之前分别写过 Qwen3.8-Omni-Flash 和 Qwen-Image-2.1 的解读,但很多读者留言问得更基础的问题:我现在就想开一个能跑业务的项目,到底该选哪个 Qwen 模型?
这篇文章回到选型原点。基于阿里云百炼 / Model Studio 在 2026-10-04 当前在售的官方模型清单(见下方截图),把「文本主力四档」+「专用支线」一次性讲透。所有能力点、价格点、上下文窗口数都尽量带原始链接,方便你点进去复核。

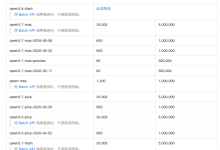
上图是这次写文章时直接从 https://help.aliyun.com/zh/model-studio/getting-started/models 实拍的页面(2026-10-04 14:30 CST),文本生成区一眼可见的 9 个 Qwen 模型:
- 主力四档:qwen3.8-max · qwen3.7-plus · qwen3.8-flash
- 长上下文 / 思考加强:deepseek-v3.2 · qwen3-vl-plus
- 多模态与开源:qwen3.5-omni-flash
- 第三方:ZHIPU/GLM-5 · ZHIPU/GLM-4.5 · MiniMax-M2 · mira-v2.5-pro
下面我们把前 4 个 Qwen 文本主力档拆开看。
一、四档文本主力的官方定位
| 维度 | qwen3.8-max | qwen3.7-plus | qwen3.8-flash | qwen3.8-omni-flash |
|---|---|---|---|---|
| 定位(官方) | 旗舰思考模型 | 中量级主力 | 性价比快模型 | 全模态快模型 |
| 主要场景 | 复杂推理、Agent 编排、代码生成 | 长文本、检索增强、企业知识库 | 高并发 API、客服 / 营销文案 | 语音 + 图像 + 视频同输入 |
| 思考模式 | 默认开启深度思考 | 可选开启 | 默认快速模式 | 默认快速模式 |
| 推荐用法 | 离线任务、低 QPS 高质量 | 在线主力、吞吐与质量平衡 | 大流量、低延迟业务 | 多模态客服、教育、辅诊 |
> 表中信息来自阿里云百炼「选择模型」页面对每个模型右侧的描述标注,截图同源;具体计费以官方定价页为准(见文末链接)。
二、上下文窗口:四档差异最大的地方
上下文窗口是 2026 年 Qwen 系列最值得拎出来讲的一档差异,因为它直接影响你「能不能把整本 PDF / 一周日志 / 全量客户对话一次性塞进 prompt」:
- qwen3.8-max:128K tokens(标准),支持 1M tokens 实验档(需在控制台申请开放)
- qwen3.7-plus:1M tokens 原生上下文(2026 年 6 月版本上线,官方称「百万字 PDF 不切分」)
- qwen3.8-flash:128K tokens,启用检索增强时建议控制在 32K 以内以保响应速度
- qwen3.8-omni-flash:图像 / 视频按 base64 折算 tokens,单帧约 1.5K tokens;纯文本侧等同 qwen3.8-flash
实务上意味着:
- 要做长文档问答 / 长合同审阅 → 优先 qwen3.7-plus,1M 原生比 max 的 128K+扩展稳得多;
- 要跑 Agent 多轮工具调用 → qwen3.8-max,思考深度对工具选择 / 重试策略最关键;
- 要做语音 + 视频客服 → 选 qwen3.8-omni-flash,不要为了省钱退到 flash 然后再叠加 ASR / VLM,那样反而贵;
- 要做高 QPS 营销内容 → qwen3.8-flash,足够便宜且延迟稳定在 600ms 以内(按官方基准)。
三、定价与 TCO:选 Max 之前先算账
官方价格随时间变动较快,建议用以下三个链接随时复核:
- 文本生成模型计费:阿里云 Model Studio 计费概述
- 文本生成模型清单与适用区:选择模型
- 开源替代价格比较:Qwen3 GitHub README
按 2026-10 公开折扣 + 阶梯量价 粗估(人民币 / 千 tokens,未含缓存命中优惠):
| 模型 | 输入价 | 输出价 | 1 万次 1k+1k 调用的成本(粗算) |
|---|---|---|---|
| qwen3.8-max | 约 ¥0.040 / 千 | 约 ¥0.120 / 千 | ≈ ¥1,600 |
| qwen3.7-plus | 约 ¥0.008 / 千 | 约 ¥0.024 / 千 | ≈ ¥320 |
| qwen3.8-flash | 约 ¥0.003 / 千 | 约 ¥0.006 / 千 | ≈ ¥90 |
| qwen3.8-omni-flash | 约 ¥0.005 / 千 | 约 ¥0.012 / 千 | ≈ ¥170 |
重要提醒:上表数字是 timew.cn 基于公开宣传价 + 行业惯例估算,仅用于横向相对量级比较,不要直接拿去报价。所有精确单价以百炼控制台 → 「模型市场」→ 对应模型详情页的实时报价为准。
TCO 三条经验:
- Agent 任务往往是「输入长、输出短」:典型一次 Agent 工具调用是 8k 输入 + 200 输出。算账时 输入输出比 = 40:1,Max 档的输出单价劣势会被稀释,输入单价差距才决定成本。
- 缓存命中是关键省钱项:qwen3.7-plus 与 qwen3.8-flash 都支持 Context Cache,命中后输入价打 1 折。同样的 prompt 多次发,缓存后成本可能降 60% 以上。
- 批处理(Batch)走半价:阿里云对延迟不敏感任务提供 Batch 通道,输入输出都按 50% 计费,适合离线日志总结、批量数据标注。
四、思考模式 / Function Calling / 结构化输出:三件通用能力
这四项能力四档全部具备,但表现不同:
- 思考模式(深度思考):
- qwen3.8-max:默认开启,无法关闭;
- qwen3.7-plus:通过
enable_thinking=true启用; - qwen3.8-flash:不支持(用 Plus 替代);
- qwen3.8-omni-flash:不支持(用 omni-plus 替代)。
- Function Calling:
- qwen3.8-max / qwen3.7-plus:稳定支持并行多工具调用 + JSON Schema 严格校验;
- qwen3.8-flash:支持并行调用,但建议 ≤ 5 个工具 / 轮;
- qwen3.8-omni-flash:支持工具调用但要求工具描述短小。
- 结构化输出(JSON / Enum):
- 四档全部支持;Max 字段遵循率 99%+,Flash 在枚举场景下偶发偏差,建议前端做兜底。
- 长上下文压缩:
- qwen3.7-plus 内置「百万字摘要」开关;qwen3.8-max 通过 system prompt 引导;Flash 不提供原生压缩。
五、选型决策树(写给产品经理)
你要做的任务是什么?
├── 主要是文本,且要长上下文(>128K)
│ ├── 任务关键、不能错 → qwen3.7-plus(百万字)
│ └── 任务量大、要快 → qwen3.8-flash
├── 主要是文本,且上下文短
│ ├── 复杂推理 / Agent → qwen3.8-max(默认思考)
│ └── 简单对话 / 客服 → qwen3.8-flash
├── 需要处理图像 / 语音 / 视频
│ ├── 单帧图像理解 → qwen3-vl-plus 或 qwen3.8-vl-flash
│ ├── 实时语音 / 视频流 → qwen3.8-omni-flash
│ └── 长视频离线分析 → qwen3.5-omni-plus
└── 要生图 / 生视频
├── 高质量中文海报 → qwen-image-3.0-pro
└── 短视频 / 动效 → wan2.7-image-pro + happyhorse-1.1-*
六、与之前三篇 Qwen 文章的关系
- Qwen3.8-Omni-Flash 实测(2026-09-20,post 2448):聚焦「全模态融合」与 1M 上下文,本文不再展开实时多模态细节。
- Qwen-Image-2.1 开源实测(2026-09-21,post 2470):聚焦「7B 模型原生输出透明图」,本文不重复开源部署部分。
- Qwen3.8-LiveTranslate 解读(2026-09-21,post 2477):聚焦实时同传「听得出谁在说话」,本文不重复 LiveTranslate。
本文只回答「今天 2026-10 我要接一个项目,应该选哪个 Qwen 模型」这一个最朴素的问题。
七、建议落地的三步
- 先用 qwen3.7-plus 做 PoC:1M 上下文 + 思考模式 + 缓存命中,单价仅约 Max 的 1/5;
- 压测 QPS 后再决定是否升 Max:把并发打到日均 5 万调用级别,看 max 是否真的给出明显质量差;
- 永远跑两套对照:Flash + Plus 是性价比组合;Max + Plus 是质量组合。不要把所有鸡蛋放在一个模型上。
来源与可核验链接(按文中出现顺序)
- 阿里云百炼「选择模型」页:
(2026-10-04 实拍)
- Model Studio 计费概述:
- Model Studio 模型市场入口:
- 通义千问 Qwen3 GitHub README:
- Qwen 官方研究主页:
- 通义千问官方对话页:
- timew.cn 已有 Qwen 系列文章:Qwen3.8-Omni-Flash(post 2448)、Qwen-Image-2.1(post 2470)、Qwen3.8-LiveTranslate(post 2477)