打开 WorkBuddy 的「模型配置」文档,会看到一张 14 行的内置模型表:Hy4 preview 打头,Deepseek-V4-Pro 收尾,横跨腾讯混元、智谱 GLM、MiniMax、月之暗面 Kimi、DeepSeek 五家厂商。表本身平平无奇,但把它和另外两个官方页面摆在一起看,会得到三个在别处看不到的结论。
第一个结论是:这张表的「可用功能」列只有三种标记,没有第四种。第二句结论是:表里 14 个名字,在更新日志里一次都没出现过。第三个结论最直接——海外站 workbuddy.ai 的同一篇文档,一个模型名字都没有。
一、14 行模型表,实测逐行核对
先把这张表摊开。这是 WorkBuddy 官方《模型配置》文档的「内置模型」一节,2026-10-18 上午实拍(截图见下)。表头三列:模型名称、简介、可用功能。
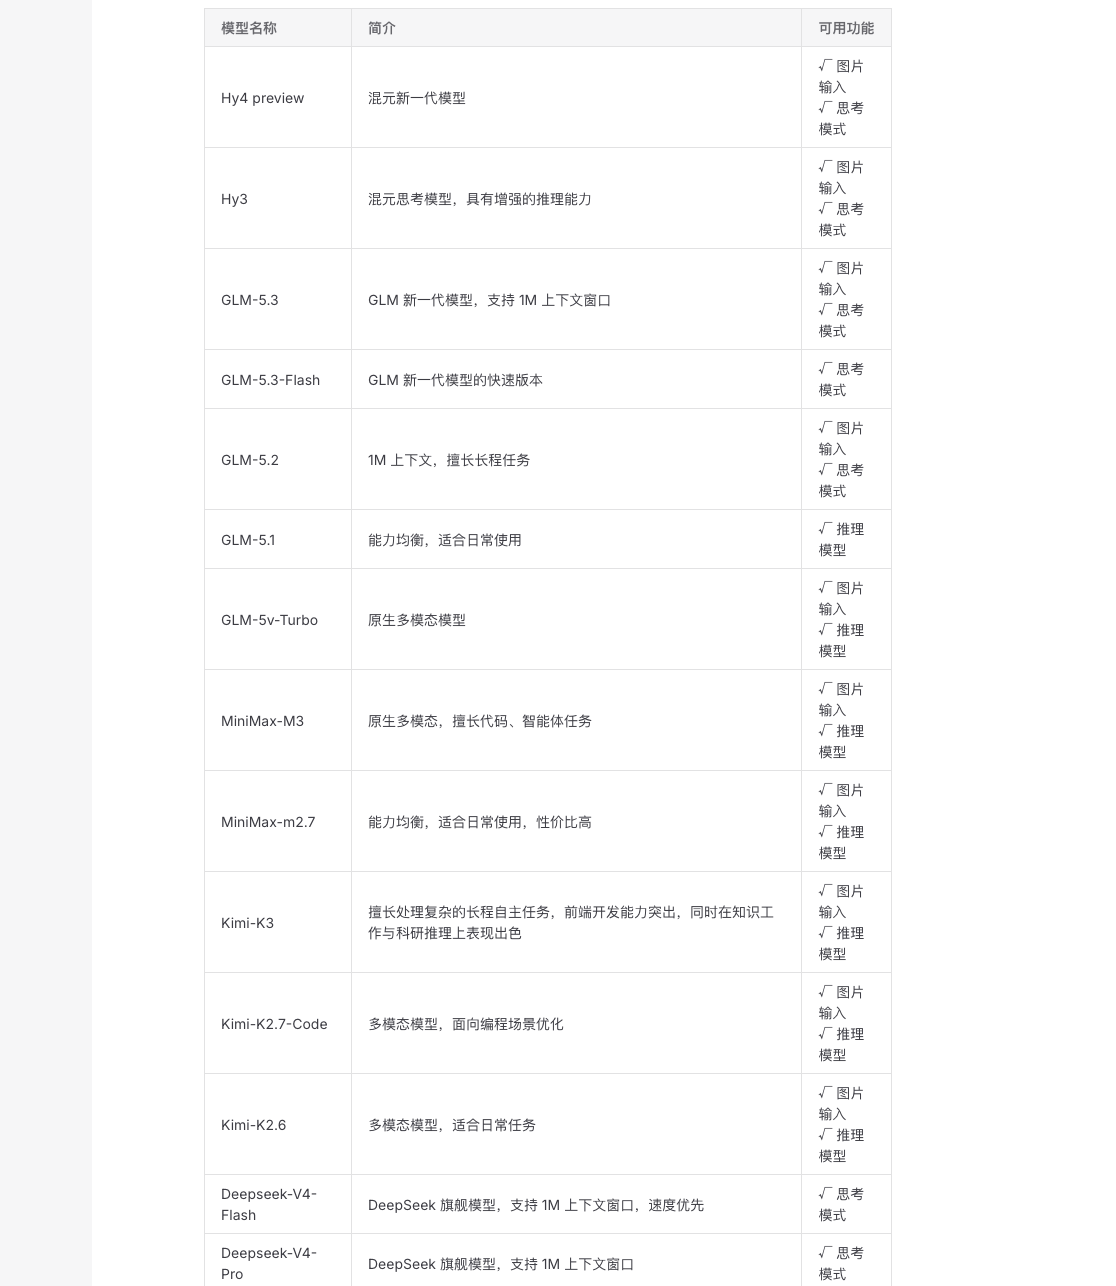
| 模型名称 | 厂商 | 简介(官方原文) | 可用功能标记 |
|---|---|---|---|
| Hy4 preview | 腾讯混元 | 混元新一代模型 | 图片输入 + 思考模式 |
| Hy3 | 腾讯混元 | 混元思考模型,具有增强的推理能力 | 图片输入 + 思考模式 |
| GLM-5.3 | 智谱 GLM | GLM 新一代模型,支持 1M 上下文窗口 | 图片输入 + 思考模式 |
| GLM-5.3-Flash | 智谱 GLM | GLM 新一代模型的快速版本 | 仅思考模式 |
| GLM-5.2 | 智谱 GLM | 1M 上下文,擅长长程任务 | 图片输入 + 思考模式 |
| GLM-5.1 | 智谱 GLM | 能力均衡,适合日常使用 | 仅推理模型 |
| GLM-5v-Turbo | 智谱 GLM | 原生多模态模型 | 图片输入 + 推理模型 |
| MiniMax-M3 | MiniMax | 原生多模态,擅长代码、智能体任务 | 图片输入 + 推理模型 |
| MiniMax-m2.7 | MiniMax | 能力均衡,适合日常使用,性价比高 | 图片输入 + 推理模型 |
| Kimi-K3 | 月之暗面 Kimi | 擅长处理复杂的长程自主任务,前端开发能力突出,同时在知识工作与科研推理上表现出色 | 图片输入 + 推理模型 |
| Kimi-K2.7-Code | 月之暗面 Kimi | 多模态模型,面向编程场景优化 | 图片输入 + 推理模型 |
| Kimi-K2.6 | 月之暗面 Kimi | 多模态模型,适合日常任务 | 图片输入 + 推理模型 |
| Deepseek-V4-Flash | DeepSeek | DeepSeek 旗舰模型,支持 1M 上下文窗口,速度优先 | 仅思考模式 |
| Deepseek-V4-Pro | DeepSeek | DeepSeek 旗舰模型,支持 1M 上下文窗口 | 仅思考模式 |
厂商分布是 5 家:智谱 GLM 5 款最多,Kimi 3 款,混元 / MiniMax / DeepSeek 各 2 款。这个比例本身透露了取舍——一家占掉三分之一强,腾讯自家的旗舰只留了 preview 和上一代两个位置。
二、三个在表格细节里藏着的口径问题
2.1 「可用功能」列只有 3 种标记,没有「工具调用」
逐行统计这一列的标记,全表只出现两种能力、两种叫法:
| 标记 | 出现次数 | 含义 |
|---|---|---|
| √ 图片输入 | 10 / 14 | 可以读取图片 |
| √ 思考模式 | 7 / 14 | 可开启推理过程 |
| √ 推理模型 | 7 / 14 | 可开启推理过程 |
| 工具调用 | 整列不存在 | — |
这里是第一个值得记一笔的地方。「思考模式」和「推理模型」各出现 7 次,加起来正好 14,也就是每行都有且只有一种——但它们显然是同一件事的两种叫法。混元系和 GLM 新一代那几行写「思考模式」,GLM-5.1 往下全部写「推理模型」。一个表格里同一列混用两个术语,读者没法从表本身判断这两者是不是真的等价。
更值得注意的是缺失的那一列。同一篇文档在「自定义模型管理」一节里明确写了:选择标准供应商时,「工具调用、图片输入等能力标记会自动写入」。也就是说工具调用在产品里是一个真实存在的能力标记,由系统自动写入——但内置模型表里根本没有这一列。对一个主打 Agent 的产品来说,内置模型能不能调工具,文档没告诉你。
2.2 四款模型不支持图片输入,而且没有规律
14 款里有 4 款没有图片输入:GLM-5.3-Flash、GLM-5.1、Deepseek-V4-Flash、Deepseek-V4-Pro。这 4 款分属 2 个厂商。
| 厂商 | 有图 / 无图 | 是否有规律 |
|---|---|---|
| 腾讯混元 | 2 / 0 | 全部支持 |
| 智谱 GLM | 3 / 2 | Flash 版与 5.1 不支持,同代 5.3 / 5.2 支持 |
| MiniMax | 2 / 0 | 全部支持 |
| 月之暗面 Kimi | 3 / 0 | 全部支持 |
| DeepSeek | 0 / 2 | 两款全不支持 |
GLM 家还能看出「快速版本砍能力」的产品逻辑:GLM-5.3 支持图片,GLM-5.3-Flash 不支持。但 DeepSeek 两款旗舰一个都不支持——包括 10-18 之前才出现的 V4-Pro,这个代次的旗舰没有任何图片能力。文档对这一点没有任何解释,也没有给出替代方案。
实际影响是:如果你要丢一张截图让 Agent 读,14 款里有 4 款直接出局,而这 4 款恰好包含 DeepSeek 的两个最新旗舰。选型时如果不看这张表,很容易在「先发消息再回一句『这个模型不支持图片』」上踩坑。更新日志 5.3.6 曾经处理过类似问题——所选模型不支持图片时改为 Toast 引导切换模型——但那是客户端拦截,不是文档说明。
2.3 四个模型标 1M 上下文,文档却让你别开
表里明确写了支持 1M 上下文的有 4 款:GLM-5.3、GLM-5.2、Deepseek-V4-Flash、Deepseek-V4-Pro。但同一篇文档的「上下文窗口」一节说:
「默认 200K,适用于绝大多数任务……开到 1M 不会让模型变聪明,只会让每轮消耗成倍增加。建议保持默认 200K,绝大多数场景都够用。」
这是一句罕见地把官方能力说成「不建议使用」的表述。原因文档也讲了,每一轮都会把当前上下文完整发送,上下文越大单轮积分越多。而 《积分说明》里明确「不同模型消耗的积分有所不同,高级模型具备更强的推理能力……其输入和输出 Token 的处理单价更高」。
把两页放一起就出现一个实际的选型矛盾:如果你有理由非用 1M 上下文(比如处理超长文档),你需要同时接受更高的单价;而 《定价详情》只按积分档位区分(体验版 500 / 标准版 4,000 / 高级版 9,000 / 旗舰版 50,000 每月实得),14 款模型之间的倍率关系官方页面没有列出。也就是说,你无法在选型阶段算出「同一个任务换一款模型要贵多少」——这个数在客户端里,文档里没有。
三、第二个结论:14 个模型名,更新日志里一次都没出现
把 14 个模型名放进更新日志里搜索,结果是 0 命中。
具体做法是逐个版本页检查 5.7.5、5.7.6、5.7.7、5.8.0、5.8.1、5.8.2 六个版本页的正文条目,匹配 GLM-、Kimi-、MiniMax-、Deepseek-V、DeepSeek-V、Hy4、Hy3、混元、Qwen 等 17 个模式,命中数为 0。
这不是文档写得含糊,而是两种文档体裁的分工:更新日志记录的是「改了哪个功能」,模型配置记录的是「现在能选哪个」。模型上架往往被归进「增强模型选择」这类概括说法里。5.8.0 是个典型例子,它的两条模型相关改动分别是:
- 「新增模型繁忙度展示,选择模型时可更直观地了解当前负载」(2026-10-09)
- 「新增自定义模型域名风险提醒,使用非官方中转服务前可了解数据安全风险」(2026-10-09)
两条都是体验和安全改进,一条模型名字都没提。对照来看,5.8.2 的 5 条改动写得很具体——从会话打不开、企微文件发不回对话,到产物栏数量跳变、旗舰版侧边栏菜单不按后台配置展示——粒度细到单个问题,唯独没有模型信息。
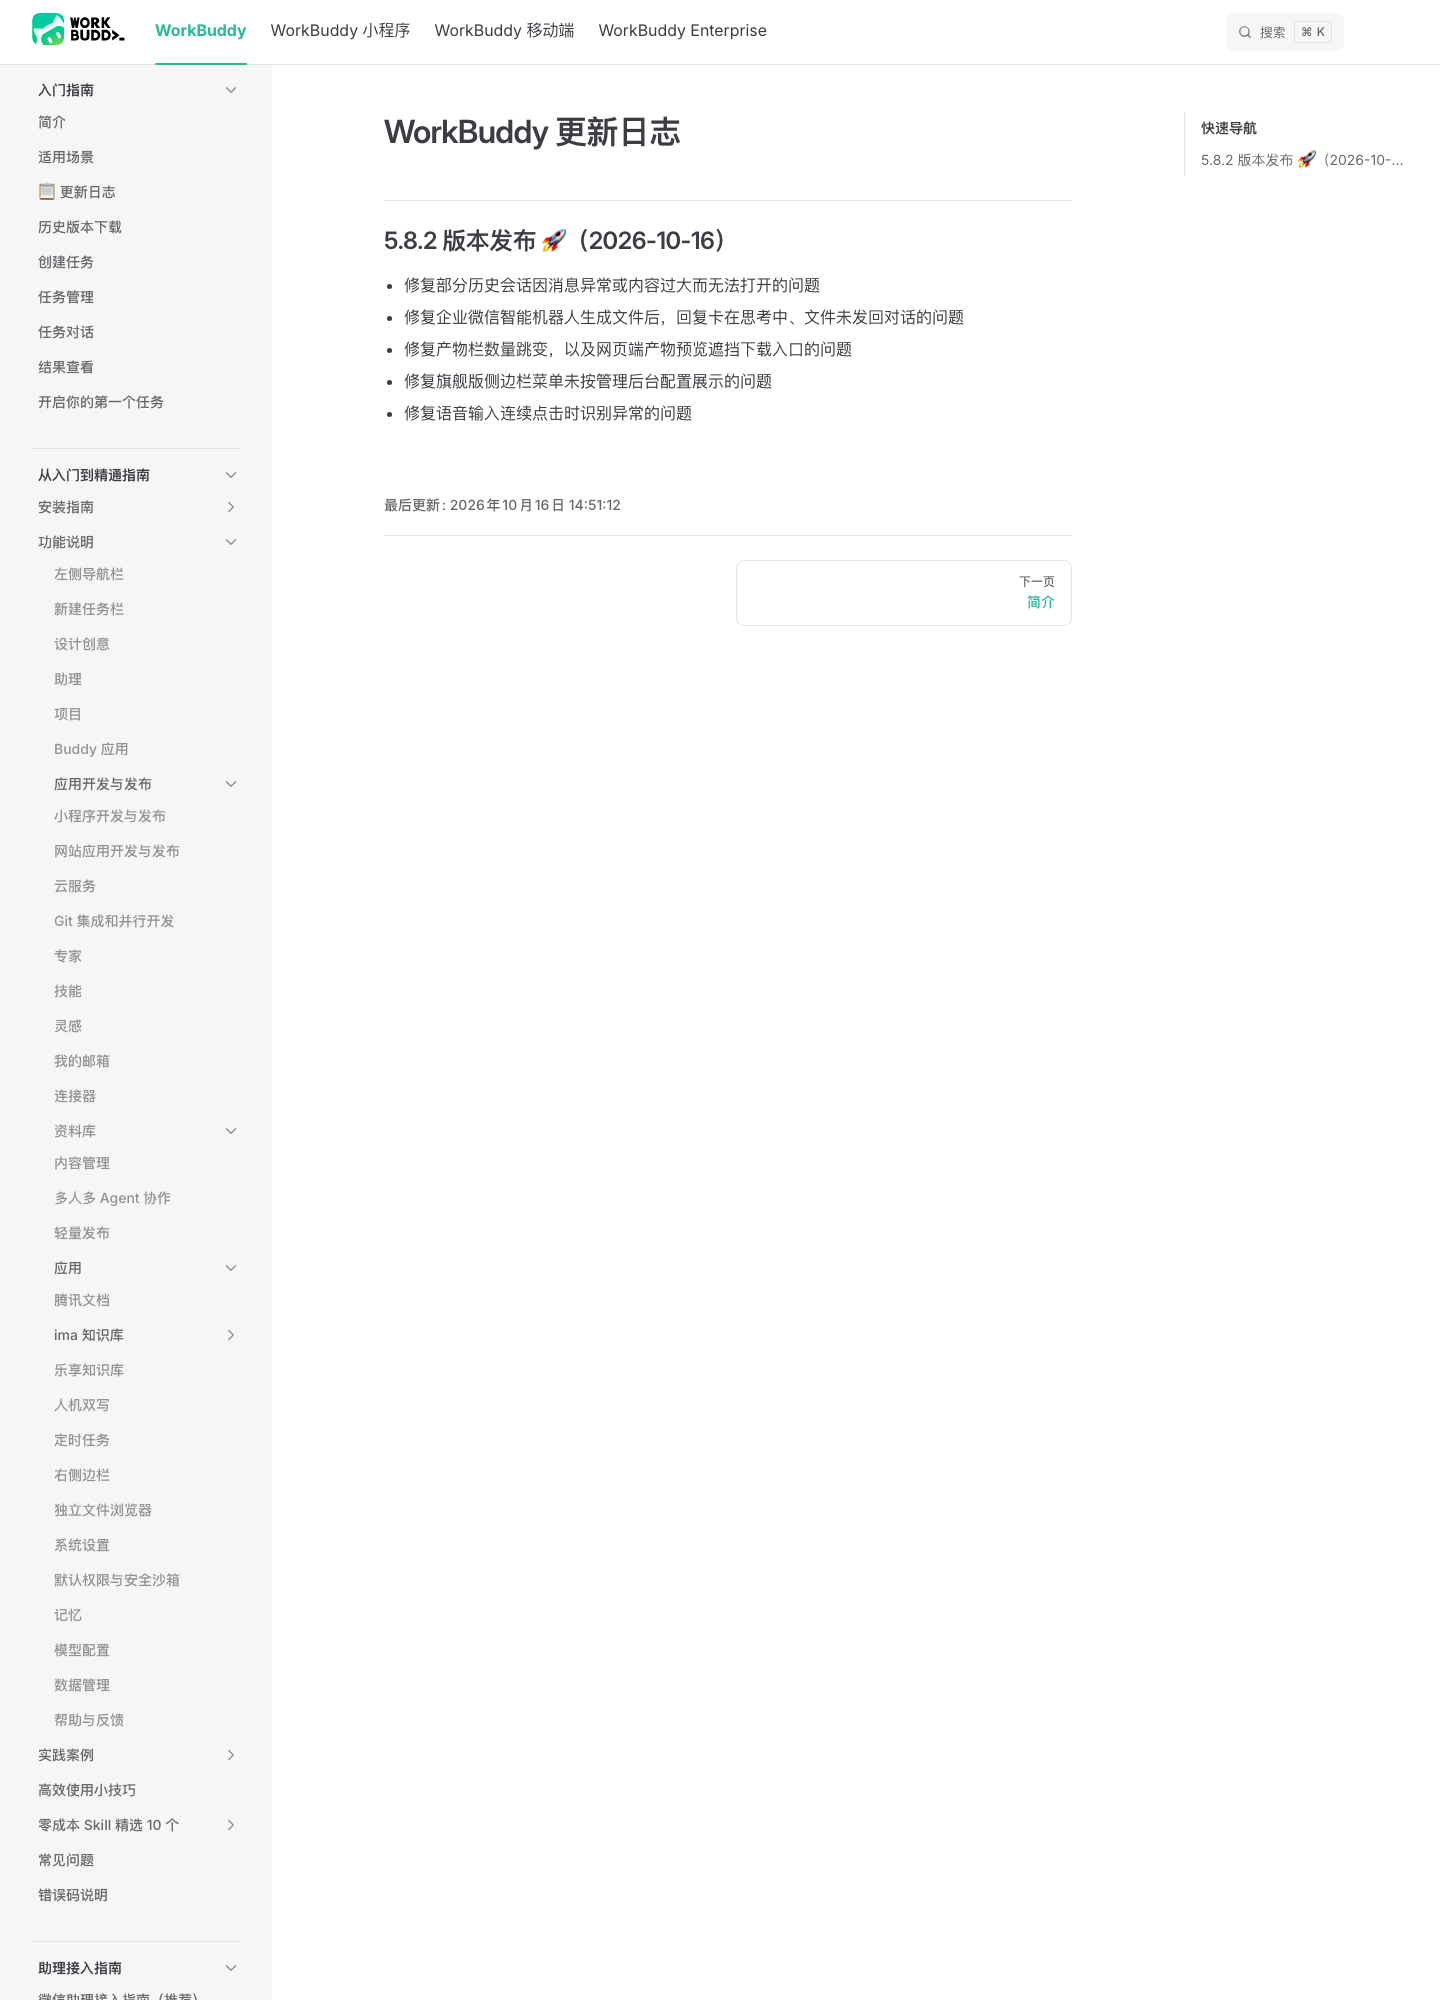
实际影响是:想知道「我上周选的模型还在不在」,查更新日志是没用的,只能直接去模型配置页比对。反过来,模型配置页也查不到「哪款模型是什么时候进来的」——那张表没有上架时间列。timew 在此之前写过 WorkBuddy 更新日志全量台账,统计过 97 个版本、1,309 条改动,其中 57.8% 是修 bug;但那篇文章里没有能力对模型清单的交叉验证,这篇正好补上这一层。
四、第三个结论:海外站一个模型名都不写
这是三个发现里差异最大的一条。
取 workbuddy.ai 的同一篇 《模型配置》文档,它的「内置模型」一节只有两句话:「Tencent WorkBuddy 提供适用于日常任务、推理和多模态场景的内置模型选项。实际可用模型列表可能会随产品版本、账号类型和服务可用性变化。」
没有表格,没有一个模型名。把同样的 14 个名字逐一比对,海外站命中 0 / 14。
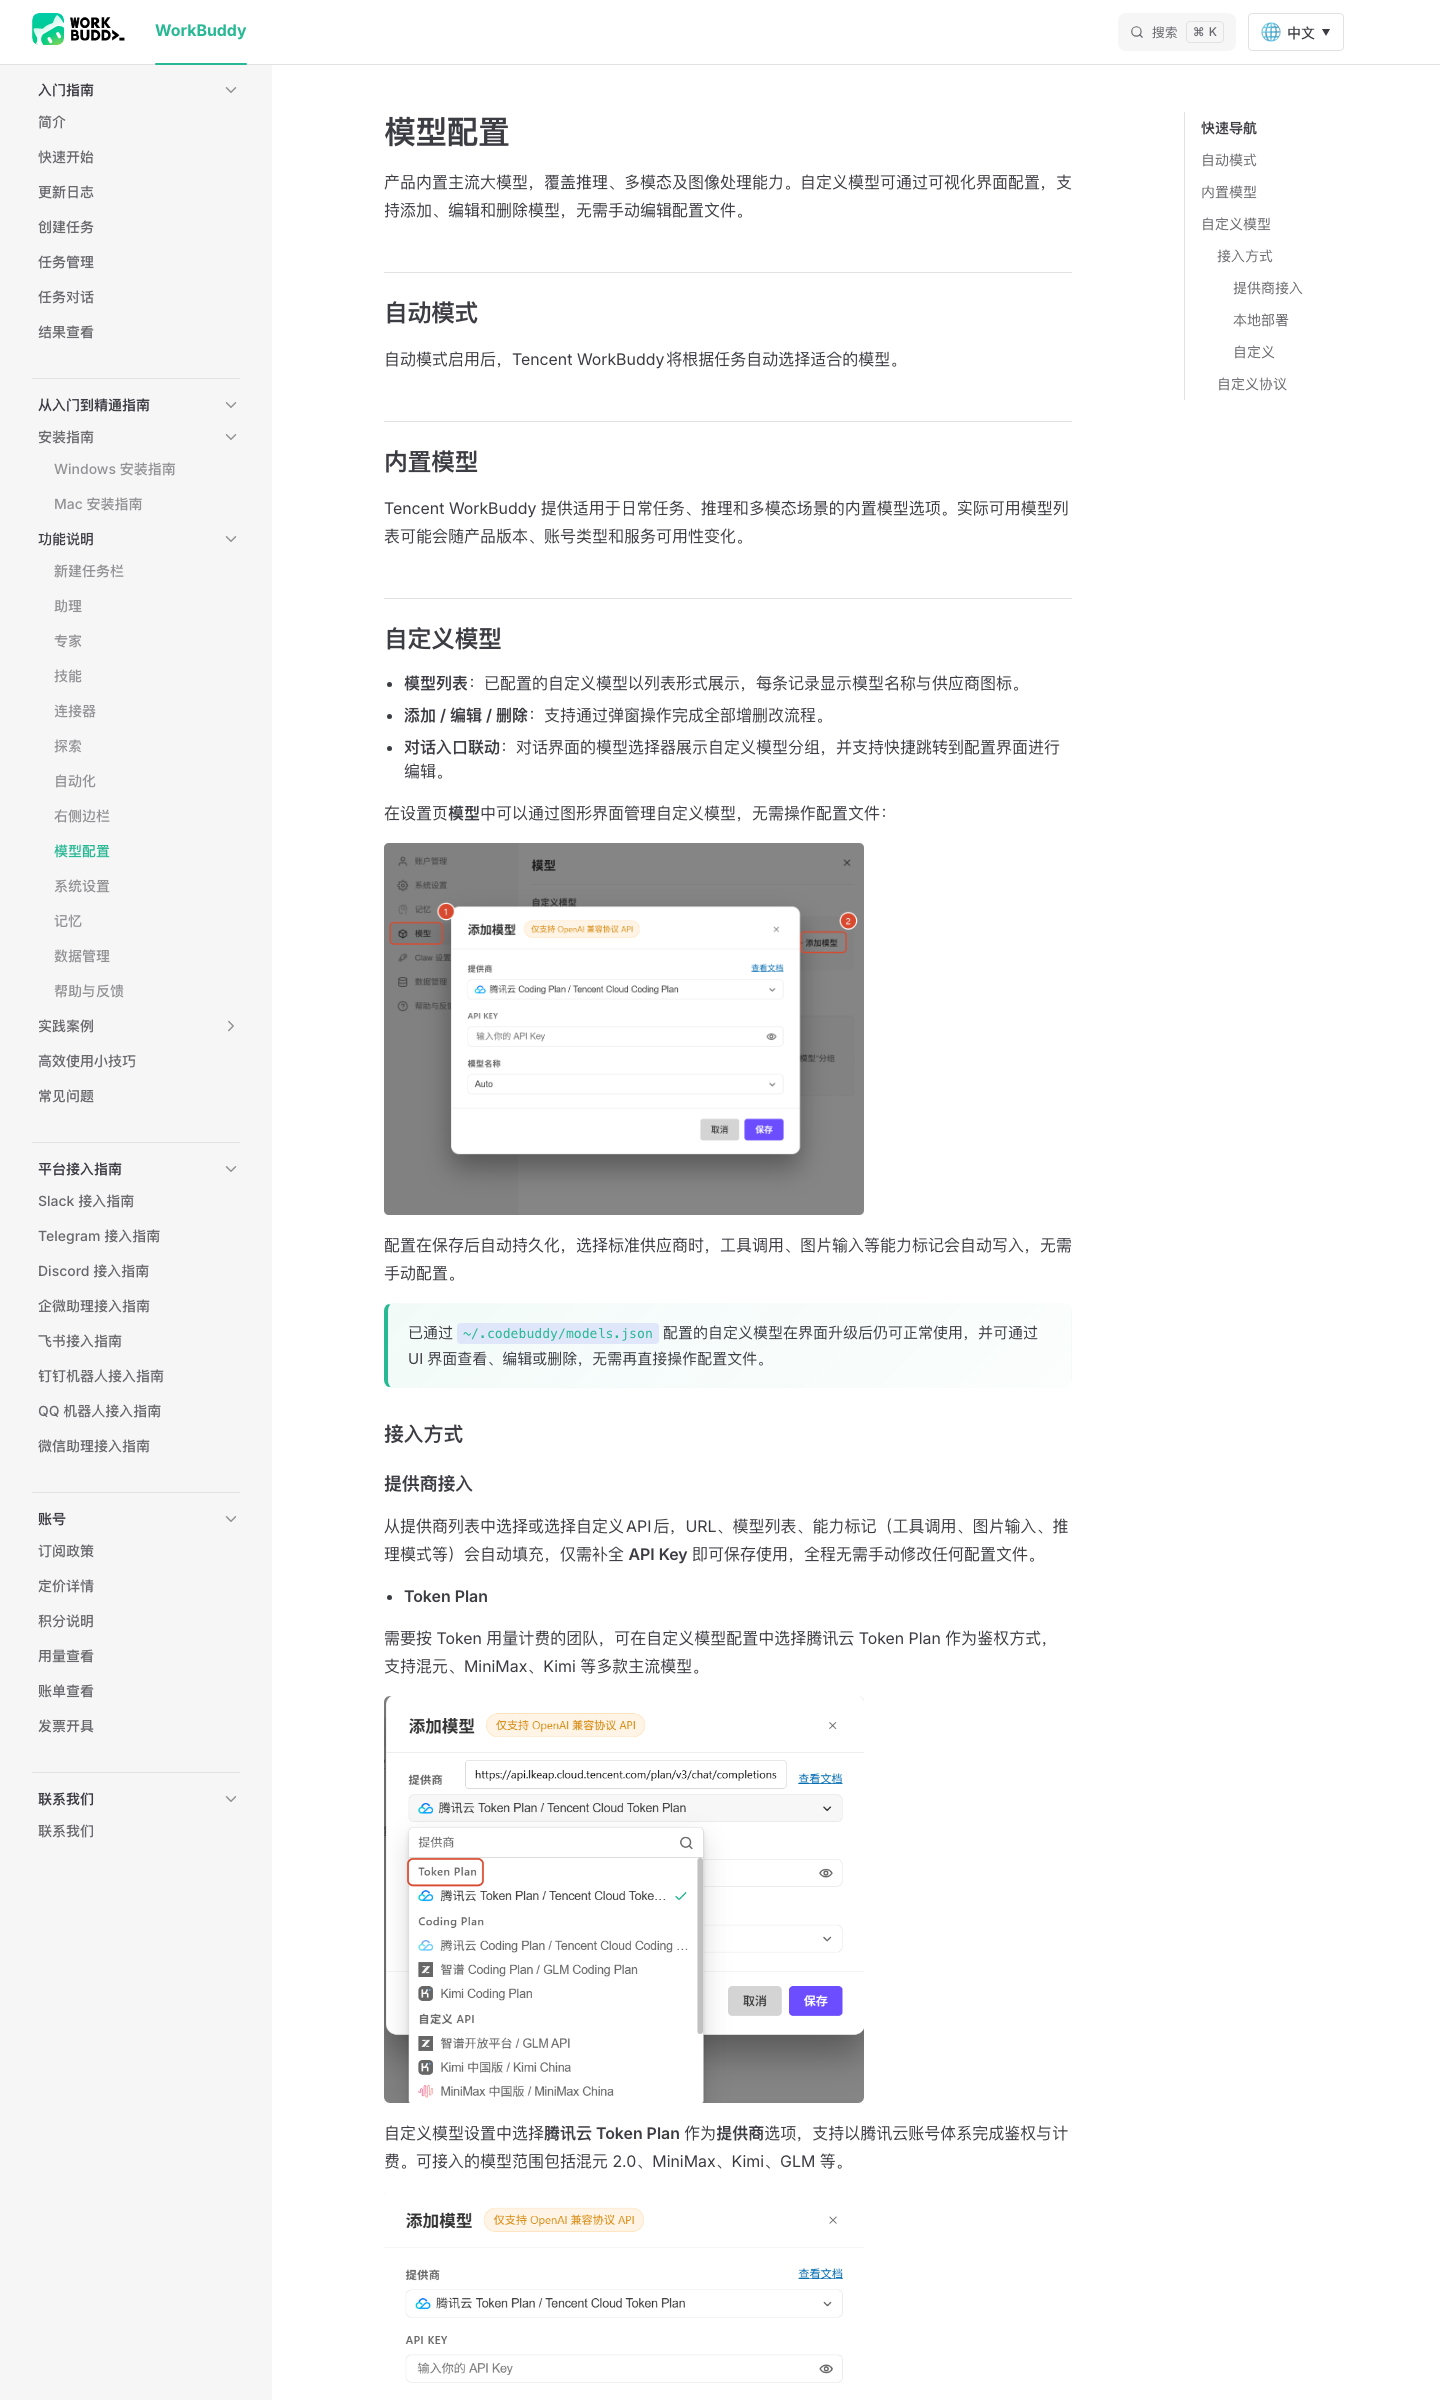
更值得注意的是两站的章节结构也不一样。按标题层级逐个比对,国内站有 33 个标题、海外站 17 个。国内站独有的一批里,包含模型选型的核心几节:模型选择、思考强度、上下文窗口、Max 模式;海外站独有的是「自动模式」一节。
| 章节 | 国内站 | 海外站 |
|---|---|---|
| 模型选择(三档:快速 / 均衡 / 极致) | 有 | 无 |
| 思考强度 | 有 | 无 |
| 上下文窗口(200K 默认 / 1M) | 有 | 无 |
| Max 模式(上下文压缩) | 有 | 无 |
| 自动模式 | 无 | 有 |
| 自定义模型 / 接入方式 | 有 | 有 |
正文体量也差得很远:国内站这一篇正文约 3,989 字符,海外站约 1,431 字符,只有 36%。
还有一个反向差异。两站都写了 Token Plan,但口径不同——国内站列出四种套餐(企业版专业版 / 企业版轻享版 / 通用个人版 / Hy 个人版)并给出各自的 API Key 获取指引,还明确「不同套餐的可用模型不一样」;海外站只有一句话,说可以按 Token 用量计费,可接入范围包括混元 2.0、MiniMax、Kimi、GLM,「如需了解腾讯云账号体系如何完成鉴权与计费,可将支持混元、MiniMax、Kimi 等多款主流模型」。
把三件事合起来看:海外站不是把模型清单「藏起来」,而是把模型选型这件事整个交给自动模式。国内站给的是一张可对照的货架加三档手动选择,海外站给的是一个不解释规则的自动选择。timew 此前写过 WorkBuddy 海外版版本节奏实测,记录过海外版选择性同步、5.7.5 和 5.7.7 没跟着走;这篇补上的是文档层的同步缺口——不是版本没跟,是模型面压根没跟。
五、可以拿来直接用的三条结论
把上面的实测压缩成能落地的判断:
- 要读图就避开 4 款:GLM-5.3-Flash、GLM-5.1、Deepseek-V4-Flash、Deepseek-V4-Pro 都不支持图片输入,其中两款是 DeepSeek 最新旗舰。剩下 10 款安全。
- 上下文保持 200K 默认:文档自己说了开到 1M 不让模型变聪明、只让单轮积分翻倍。四个标 1M 的模型只在确有超长文档时才值得开。
- 要查模型变更只能去模型配置页:更新日志 6 个版本页 0 命中模型名;反查上架时间也不可行,表里没有时间列。这两个问题目前只有人工比对能解决。
六、口径与未知项
本文所有表格数据、章节标题、字符数均来自 2026-10-18 上午对官方文档页的直接抓取与逐行核对:国内站 《模型配置》、海外站 《模型配置》、《更新日志》分版本页 6 个,以及 《积分说明》、《定价详情》。三张配图均为上述页面在 2026-10-18 上午 Chrome 实拍。
以下为本文未能核实、不应据此下结论的部分,如实标注:
- UNKNOWN:14 款模型之间的积分倍率关系。官方定价页只按会员档位列积分,未按模型列单价,实际倍率需在客户端内查看。
- UNKNOWN:「思考模式」与「推理模型」在功能上是否完全等价。文档在同一列混用两种写法,但未作定义,本文只陈述现象,不推断等价性。
- UNKNOWN:内置模型是否支持工具调用。文档在自定义模型部分确认该能力存在并自动写入,但内置模型表无此列,本文不推断其支持情况。
- UNKNOWN:14 款模型各自的上架时间。文档表格无时间列,更新日志 0 命中模型名,无法还原上架顺序。
- UNKNOWN:海外站实际可选的模型集合。文档只写「实际可用模型列表可能会随产品版本、账号类型和服务可用性变化」,未列出任何名称,本文只依据文档层面断言。
本文只做文档层面的核对,不涉及客户端实测,不对模型实际表现作任何评价。