OpenClaw 的 docs 命令不认中文:8 条中文查询全部 0 命中,文档站上却有 721 页中文
数据采集时间:2026-10-27 05:00–05:35(Asia/Shanghai)。更新时间:2026-10-27 05:35。 本文实测本机 OpenClaw 2026.10.7 (157d8c2) 的 openclaw docs 子命令:同一份查询矩阵分别走 CLI 和文档站的搜索接口,记录结果条数、排序、退出码和链接可用性;再对照站点 sitemap 的语言分布,回答一个很具体的问题——中文用户能不能用这条命令查到中文文档。所有数字都能按下文命令复算,没测到的部分标 UNKNOWN。
一、测法与边界
- 客户端:
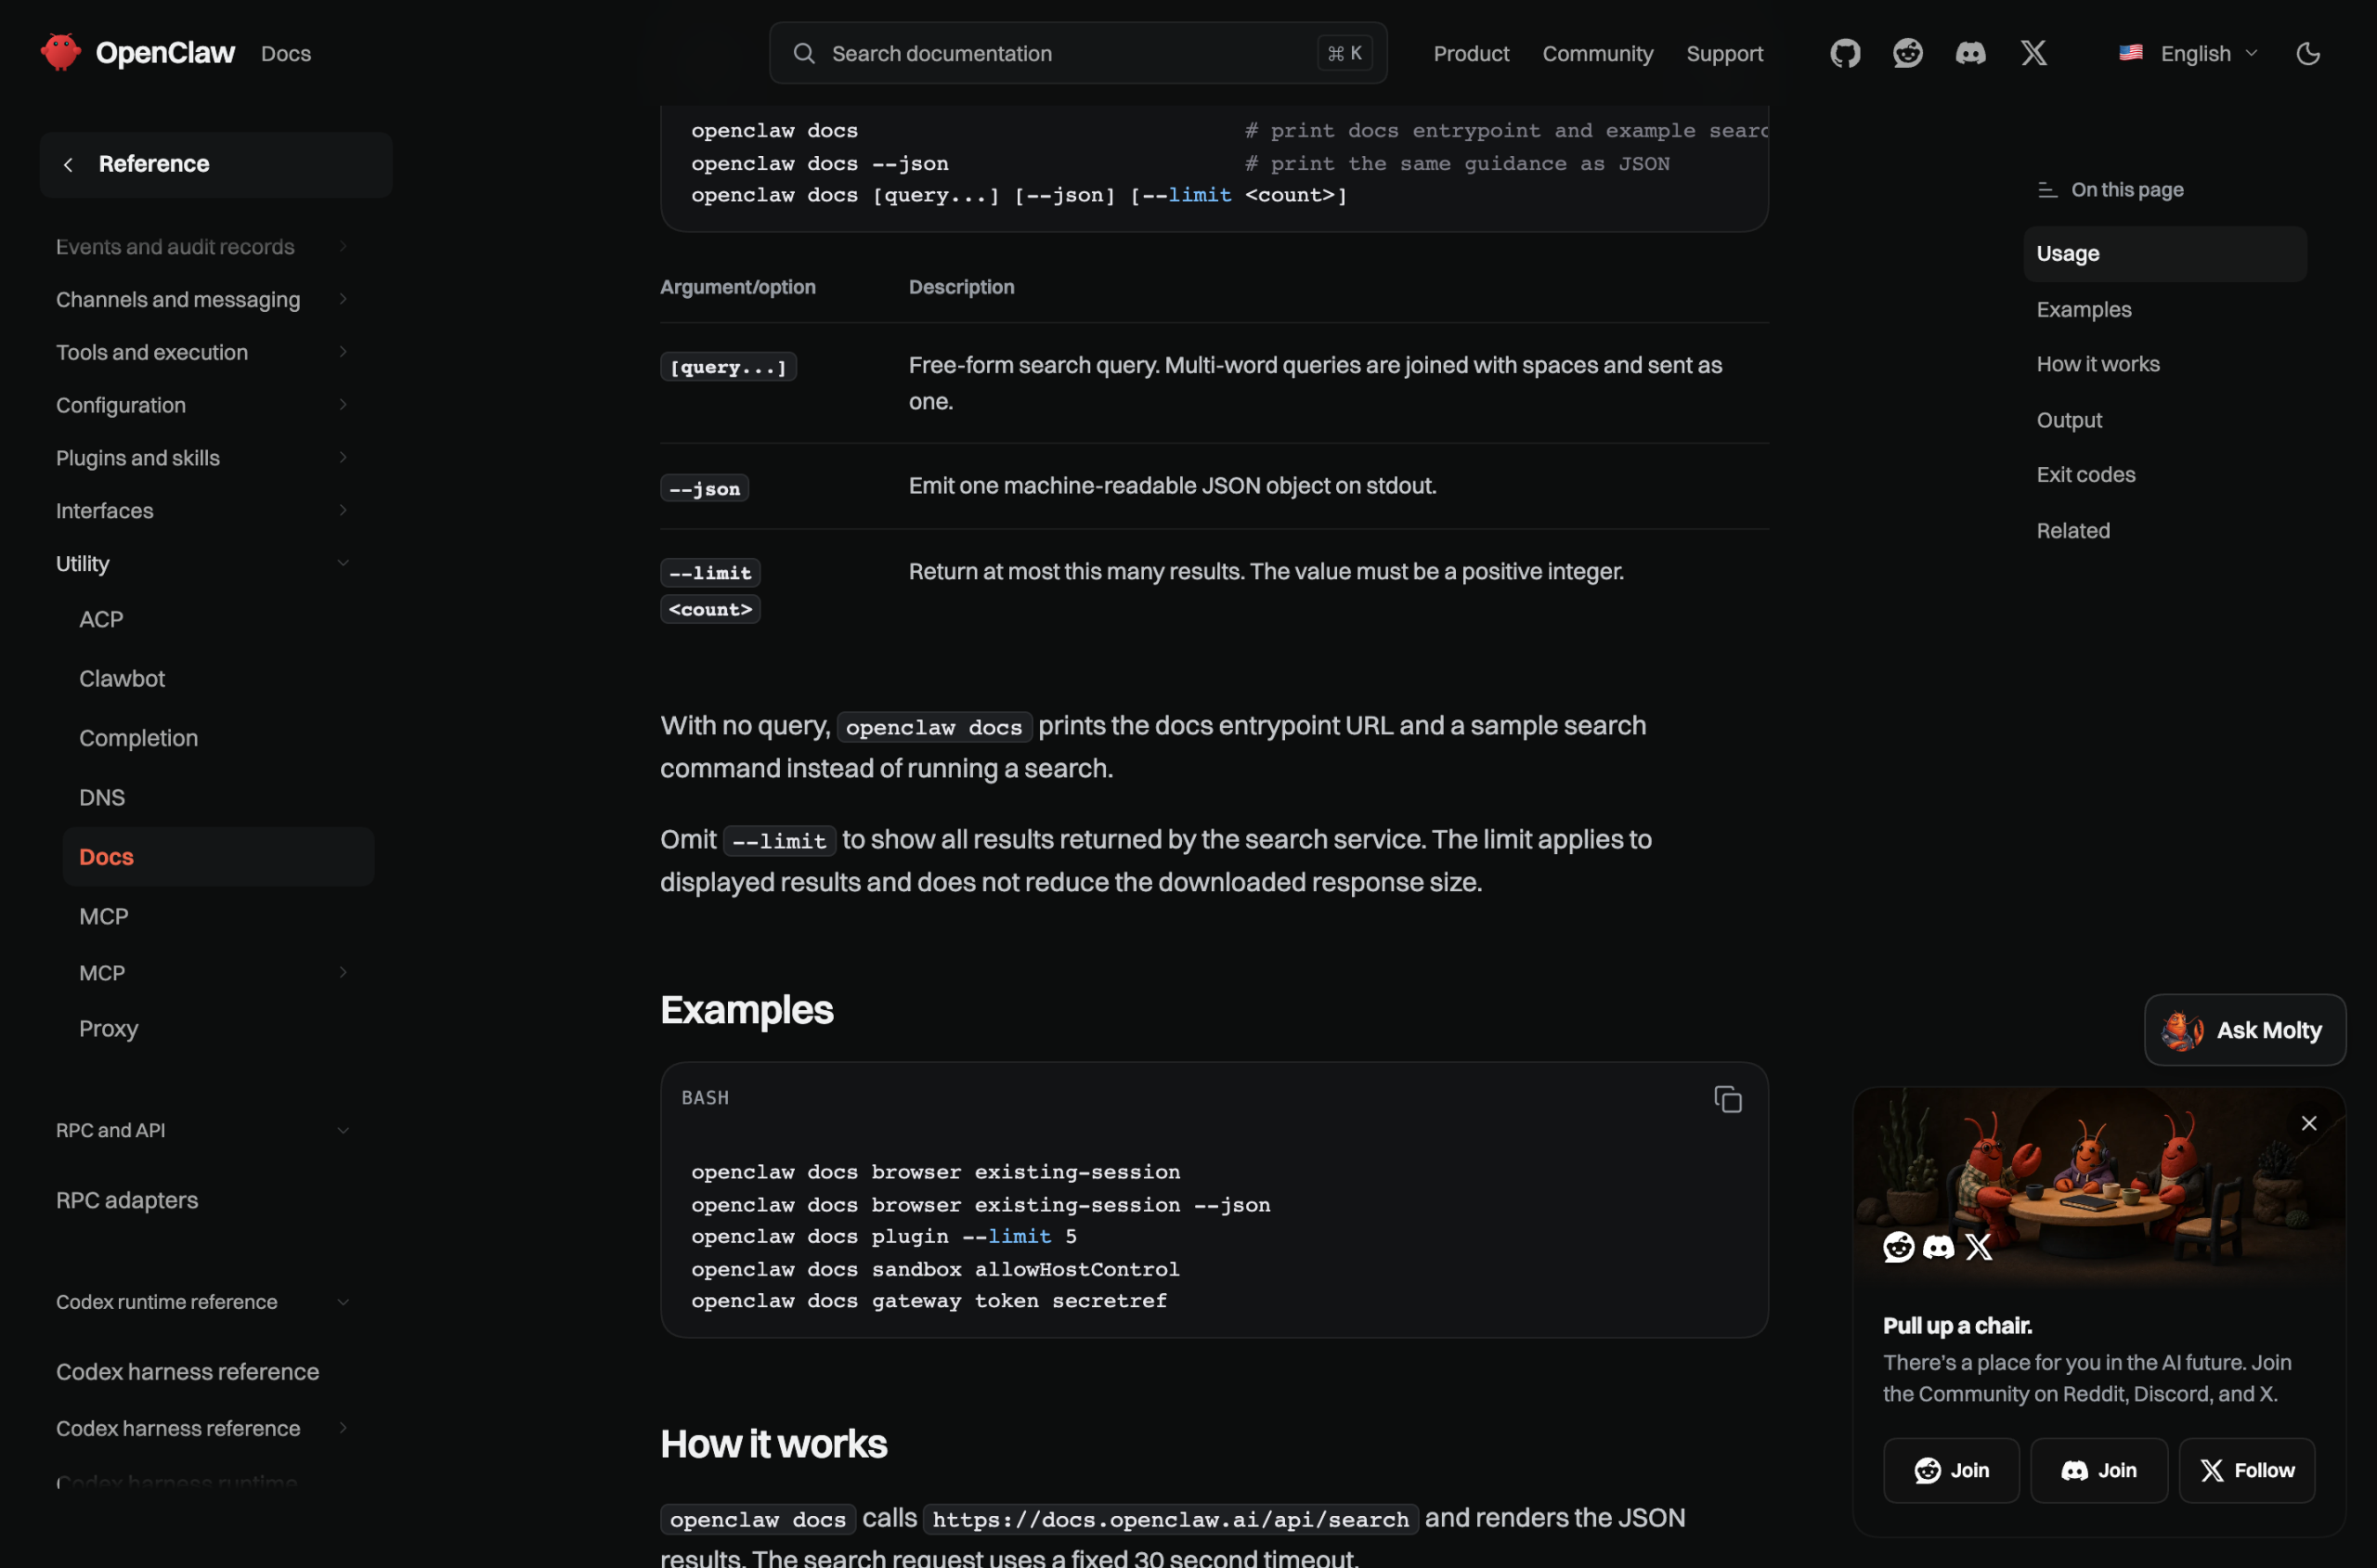
openclaw docs <query> --json,默认输出一个 JSON 对象,含query、results[],每条结果有title、link、snippet。 - 服务端:CLI 文档写明该命令调用
https://docs.openclaw.ai/api/search,固定 30 秒超时;我另外用curl直连同一个接口做对照,确认差异不是 CLI 引入的。 - 查询矩阵:12 条英文关键词、8 条纯中文、3 条中英混合、3 条正文短语;外加
--limit取 1/3/5/12/20/50 六档、无参数调用、空字符串查询和一条乱码查询。 - 链接校验:对所有出现过的唯一结果链接发一次 GET,记录 HTTP 状态;再把这些链接的路径前缀换成
/zh-CN/复测一次,看有没有中文版。 - 不在本文范围:检索算法实现(关键词、向量还是混合)、索引更新频率、其他非拉丁文字(日文、韩文、阿拉伯文)的命中情况。这三项均未测,标 UNKNOWN。
二、英文关键词:12 条查询,每条都刚好 12 条结果
12 条英文查询是:config validate、gateway token、cron jobs、exec approvals、session lifecycle、browser control、plugin sdk、sandbox、voice wake、device pairing、backup restore、mcp tools。
结果是 12 条全部返回 12 条,合计 144 条结果位,去重后 171 个唯一链接(含中英文混合与正文短语组)。这 171 个链接在 2026-10-27 05:12 前后逐个 GET,全部返回 HTTP 200,没有一条 404、没有一条 5xx。也就是说:索引里的链接不是死链,问题不在 URL 失效。
| 查询 | 结果条数 | 第一条结果 |
|---|---|---|
| config validate | 12 | Config(/cli/config) |
| gateway token | 12 | Gateway(/cli/gateway) |
| cron jobs | 12 | Automations (cron)(/cli/cron) |
| exec approvals | 12 | Approvals(/cli/approvals) |
| session lifecycle | 12 | Cloud session lifecycle and durability |
| browser control | 12 | Browser(/tools/browser) |
| plugin sdk | 12 | Plugin SDK defineSetupPluginEntry helper |
| sandbox | 12 | Codex approval and sandbox modes |
| voice wake | 12 | Voice wake(/nodes/voicewake) |
| device pairing | 12 | Pairing(/channels/pairing) |
| backup restore | 12 | Backup(/cli/backup) |
表里只列了 11 行,第 12 条 mcp tools 也返回 12 条,第一条是 MCP(/tools/mcp),为节省版面不重复。可以看到头几条都命中了主题页,但尾部开始漂移:backup restore 的第 4 到第 12 条出现了 PostgreSQL、Cloudflare Containers、Matrix 迁移、存储变更预检这些页面。它们和”备份恢复”只沾一点边,属于 12 条上限被填满后的泛化结果。
三、中文查询:8 条全部 0 命中,接口直连也一样
8 条中文查询:配置校验、网关令牌、定时任务、执行审批、会话生命周期、浏览器控制、插件开发、设备配对。
8 条全部返回 0 条结果,退出码都是 0。 0 结果不是报错,命令正常结束、JSON 可解析、results 是空数组。
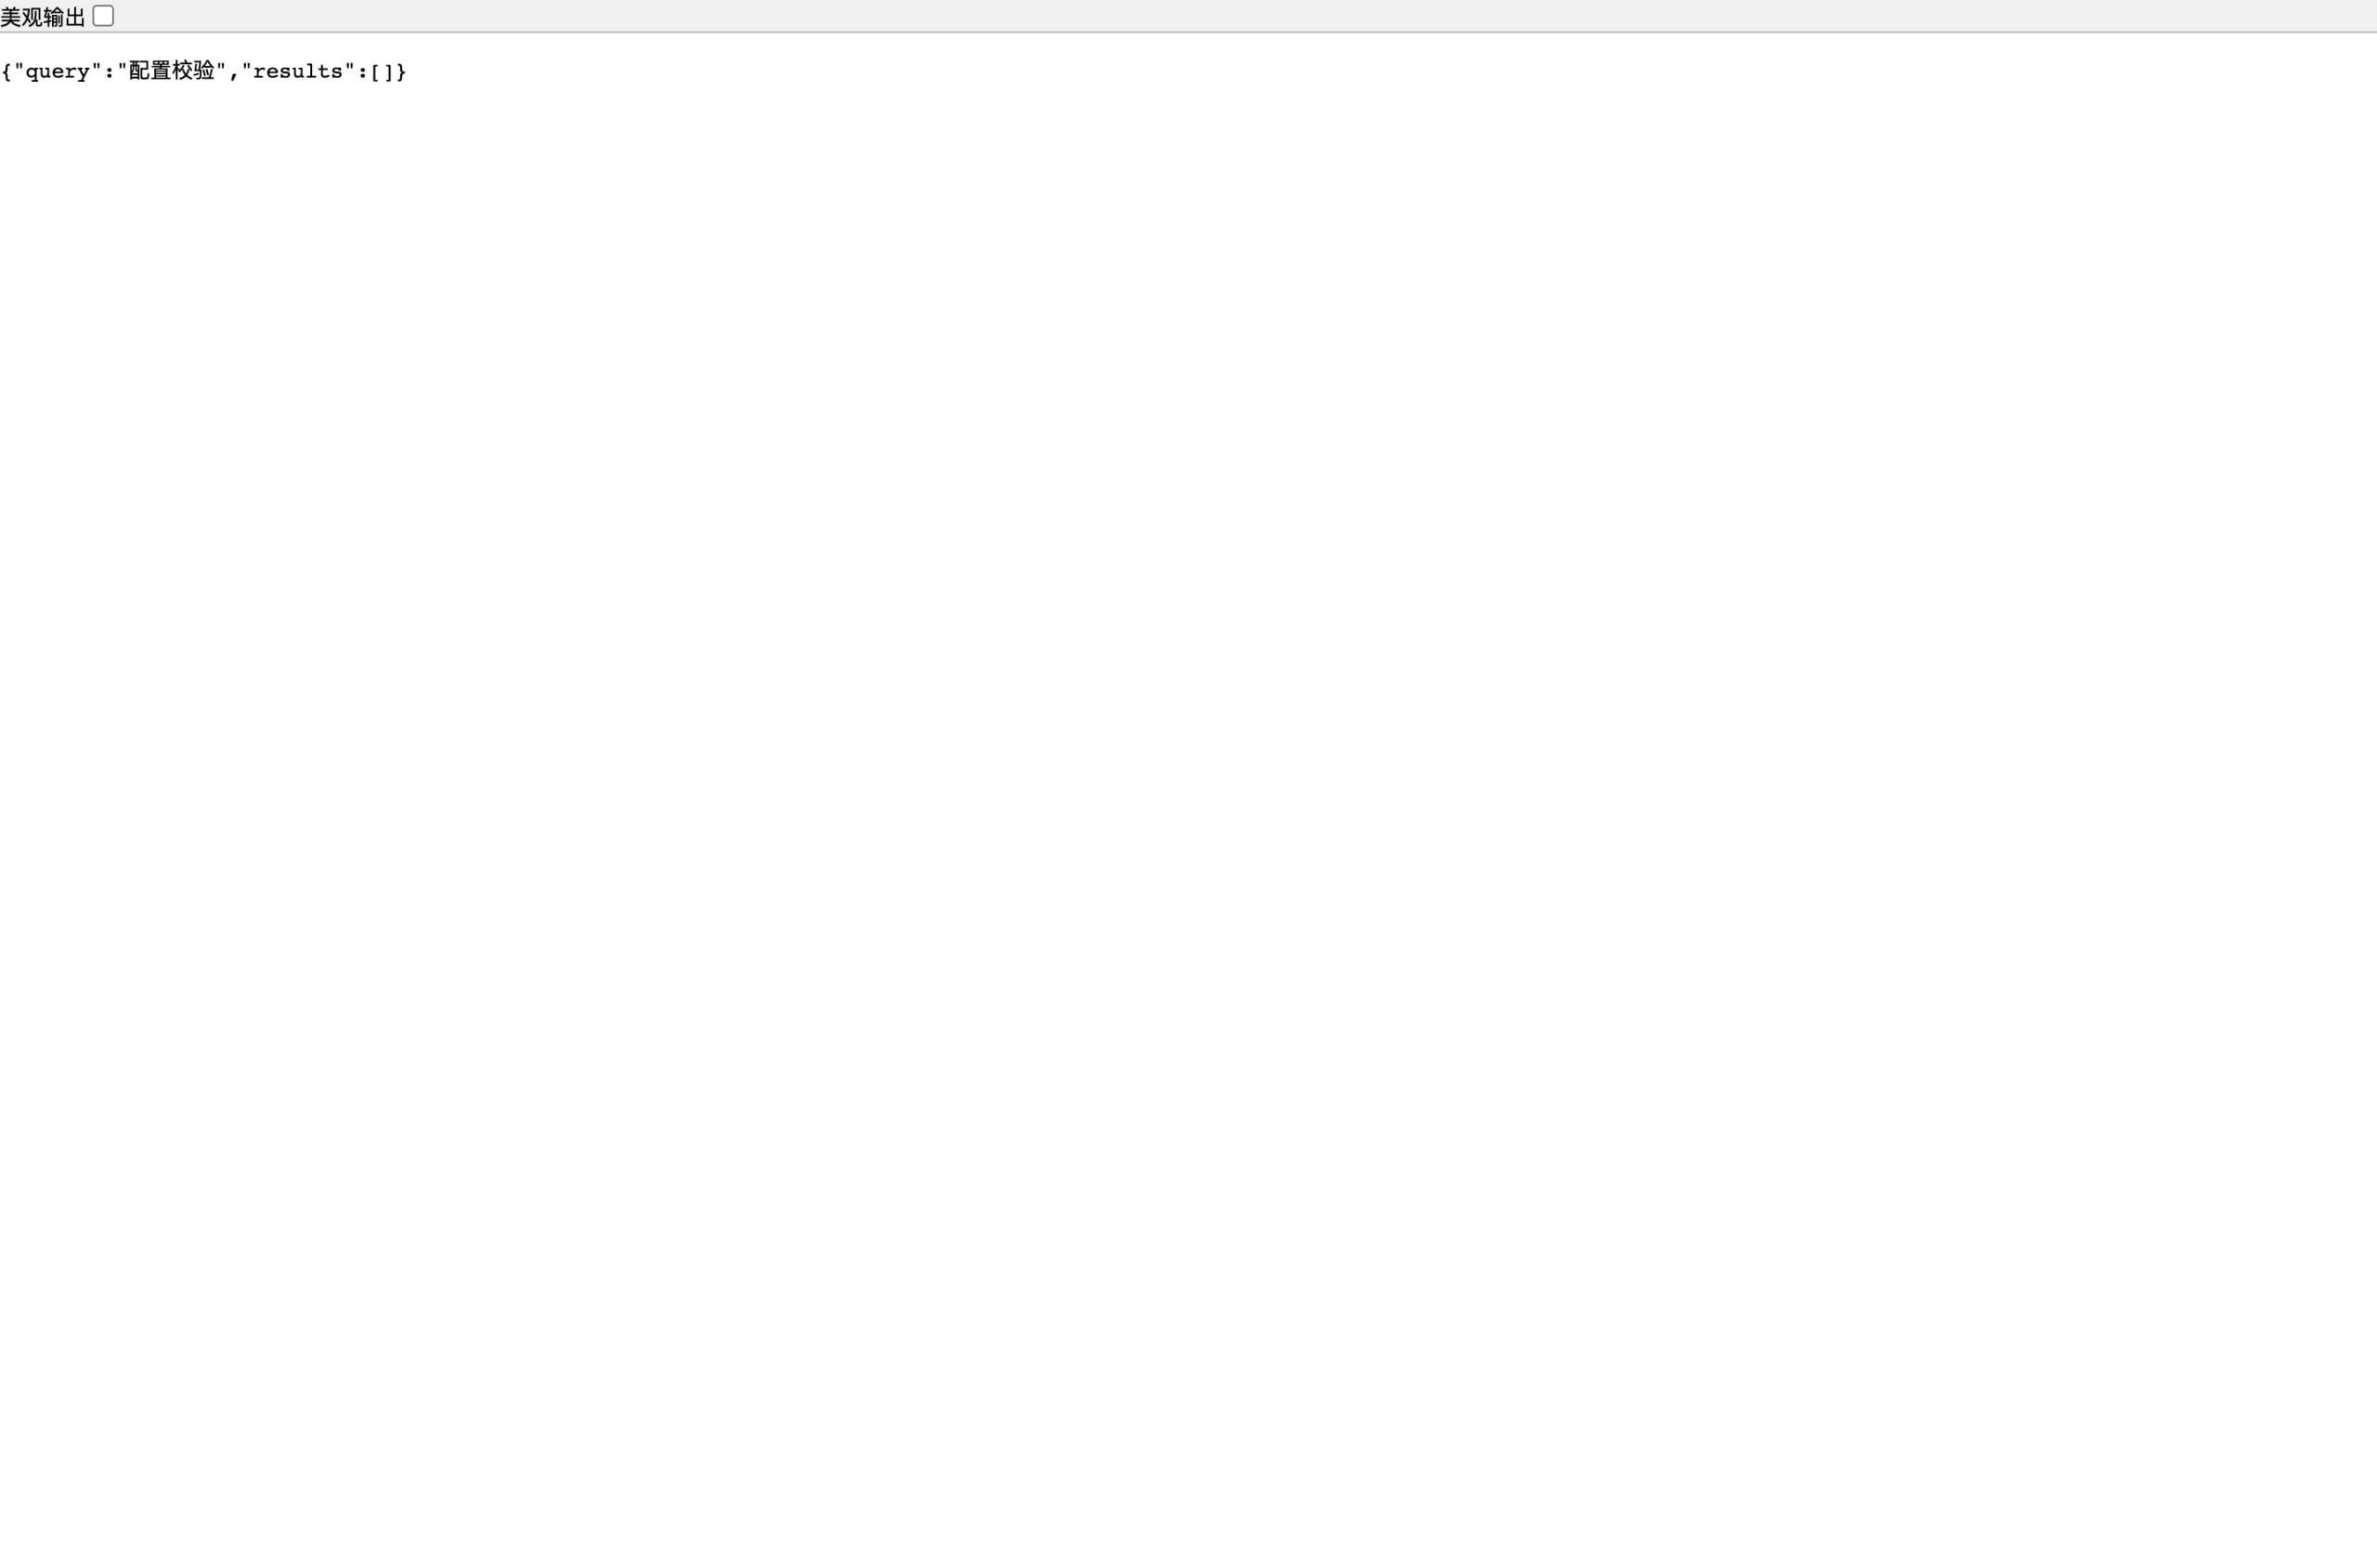
为排除”CLI 把中文参数弄丢了”,我用 curl 直接请求 https://docs.openclaw.ai/api/search?q=配置校验,返回体是:
{"query":"配置校验","results":[]}
同样的空数组。再给接口加 locale 参数(分别取 zh-CN、zh、en),三次都是 0 条;CLI 侧的 openclaw docs --help 里也没有任何语言或 locale 选项。从外部可观测的行为能确定的只有一句话:对纯中文查询,这个搜索服务返回空。至于它是在分词阶段丢掉了非 ASCII 字符,还是索引里根本没有中文语料,外部无法区分,UNKNOWN。
四、中英混合:中文那半完全没有作用
三条混合查询 openclaw 配置、gateway 令牌、session 会话 都返回 12 条。只看条数说明不了什么,于是我做了逐条比对:
gateway单独查询 → 12 条gateway 令牌→ 12 条,12 个链接的顺序与gateway单独查询完全一致gateway zzzqq→ 0 条
这三组放在一起,指向一个清晰的行为差异:拉丁字母的未知词会让结果整体归零,而中文字符被直接忽略、不参与匹配也不触发失败。换句话说,写 gateway 令牌 和写 gateway 得到的是同一份东西——中文只起到了”看起来像限定词”的作用。这一点对使用者有实际影响:混合写法不会让结果更精确,只会让人误以为已经按中文筛过。
五、–limit 的上限被钉在 12,且文档没说上限
文档页对 --limit 的说法是:不传时”显示搜索服务返回的全部结果”,传了就限制显示条数,但”不会减少下载的响应体积”。实测六档:
| –limit | 实际返回条数 | stdout 字节数 |
|---|---|---|
| 1 | 1 | 274 |
| 3 | 3 | 891 |
| 5 | 5 | 1539 |
| 12 | 12 | 3294 |
| 20 | 12 | 3294 |
| 50 | 12 | 3294 |
1、3、5、12 都按预期裁剪,20 和 50 被静默压回 12,字节数与 12 档一模一样。默认不带 --limit 时也是 12 条、3294 字节。结合文档原文”不传 limit 显示服务返回的全部结果”,最合理的解释是:服务端单次最多只给 12 条,CLI 只是如实显示。文档没有写这个 12,用户如果以为能靠 --limit 50 一次拉全,就会拿到一个静默裁剪过的结果集。这一条不需要看源码,用字节数就能确认。
另外两个边界:不带任何参数运行 openclaw docs --json,输出一个含 url 字段的对象(https://docs.openclaw.ai/)和空 results,退出码 0,属于”打印入口”而不是搜索;传空字符串 "" 时也是 0 条、退出码 0。
六、站点上有 721 页中文,搜索结果里 0 条中文链接
我拉了 https://docs.openclaw.ai/sitemap.xml(1,146,090 字节,15,535 个 <loc>),按路径第一段归类:
- 英文页:1,429 个
- 带语言前缀的本地化页:14,106 个,覆盖 21 种语言前缀
- 其中
zh-CN:721 个,zh-TW:721 个
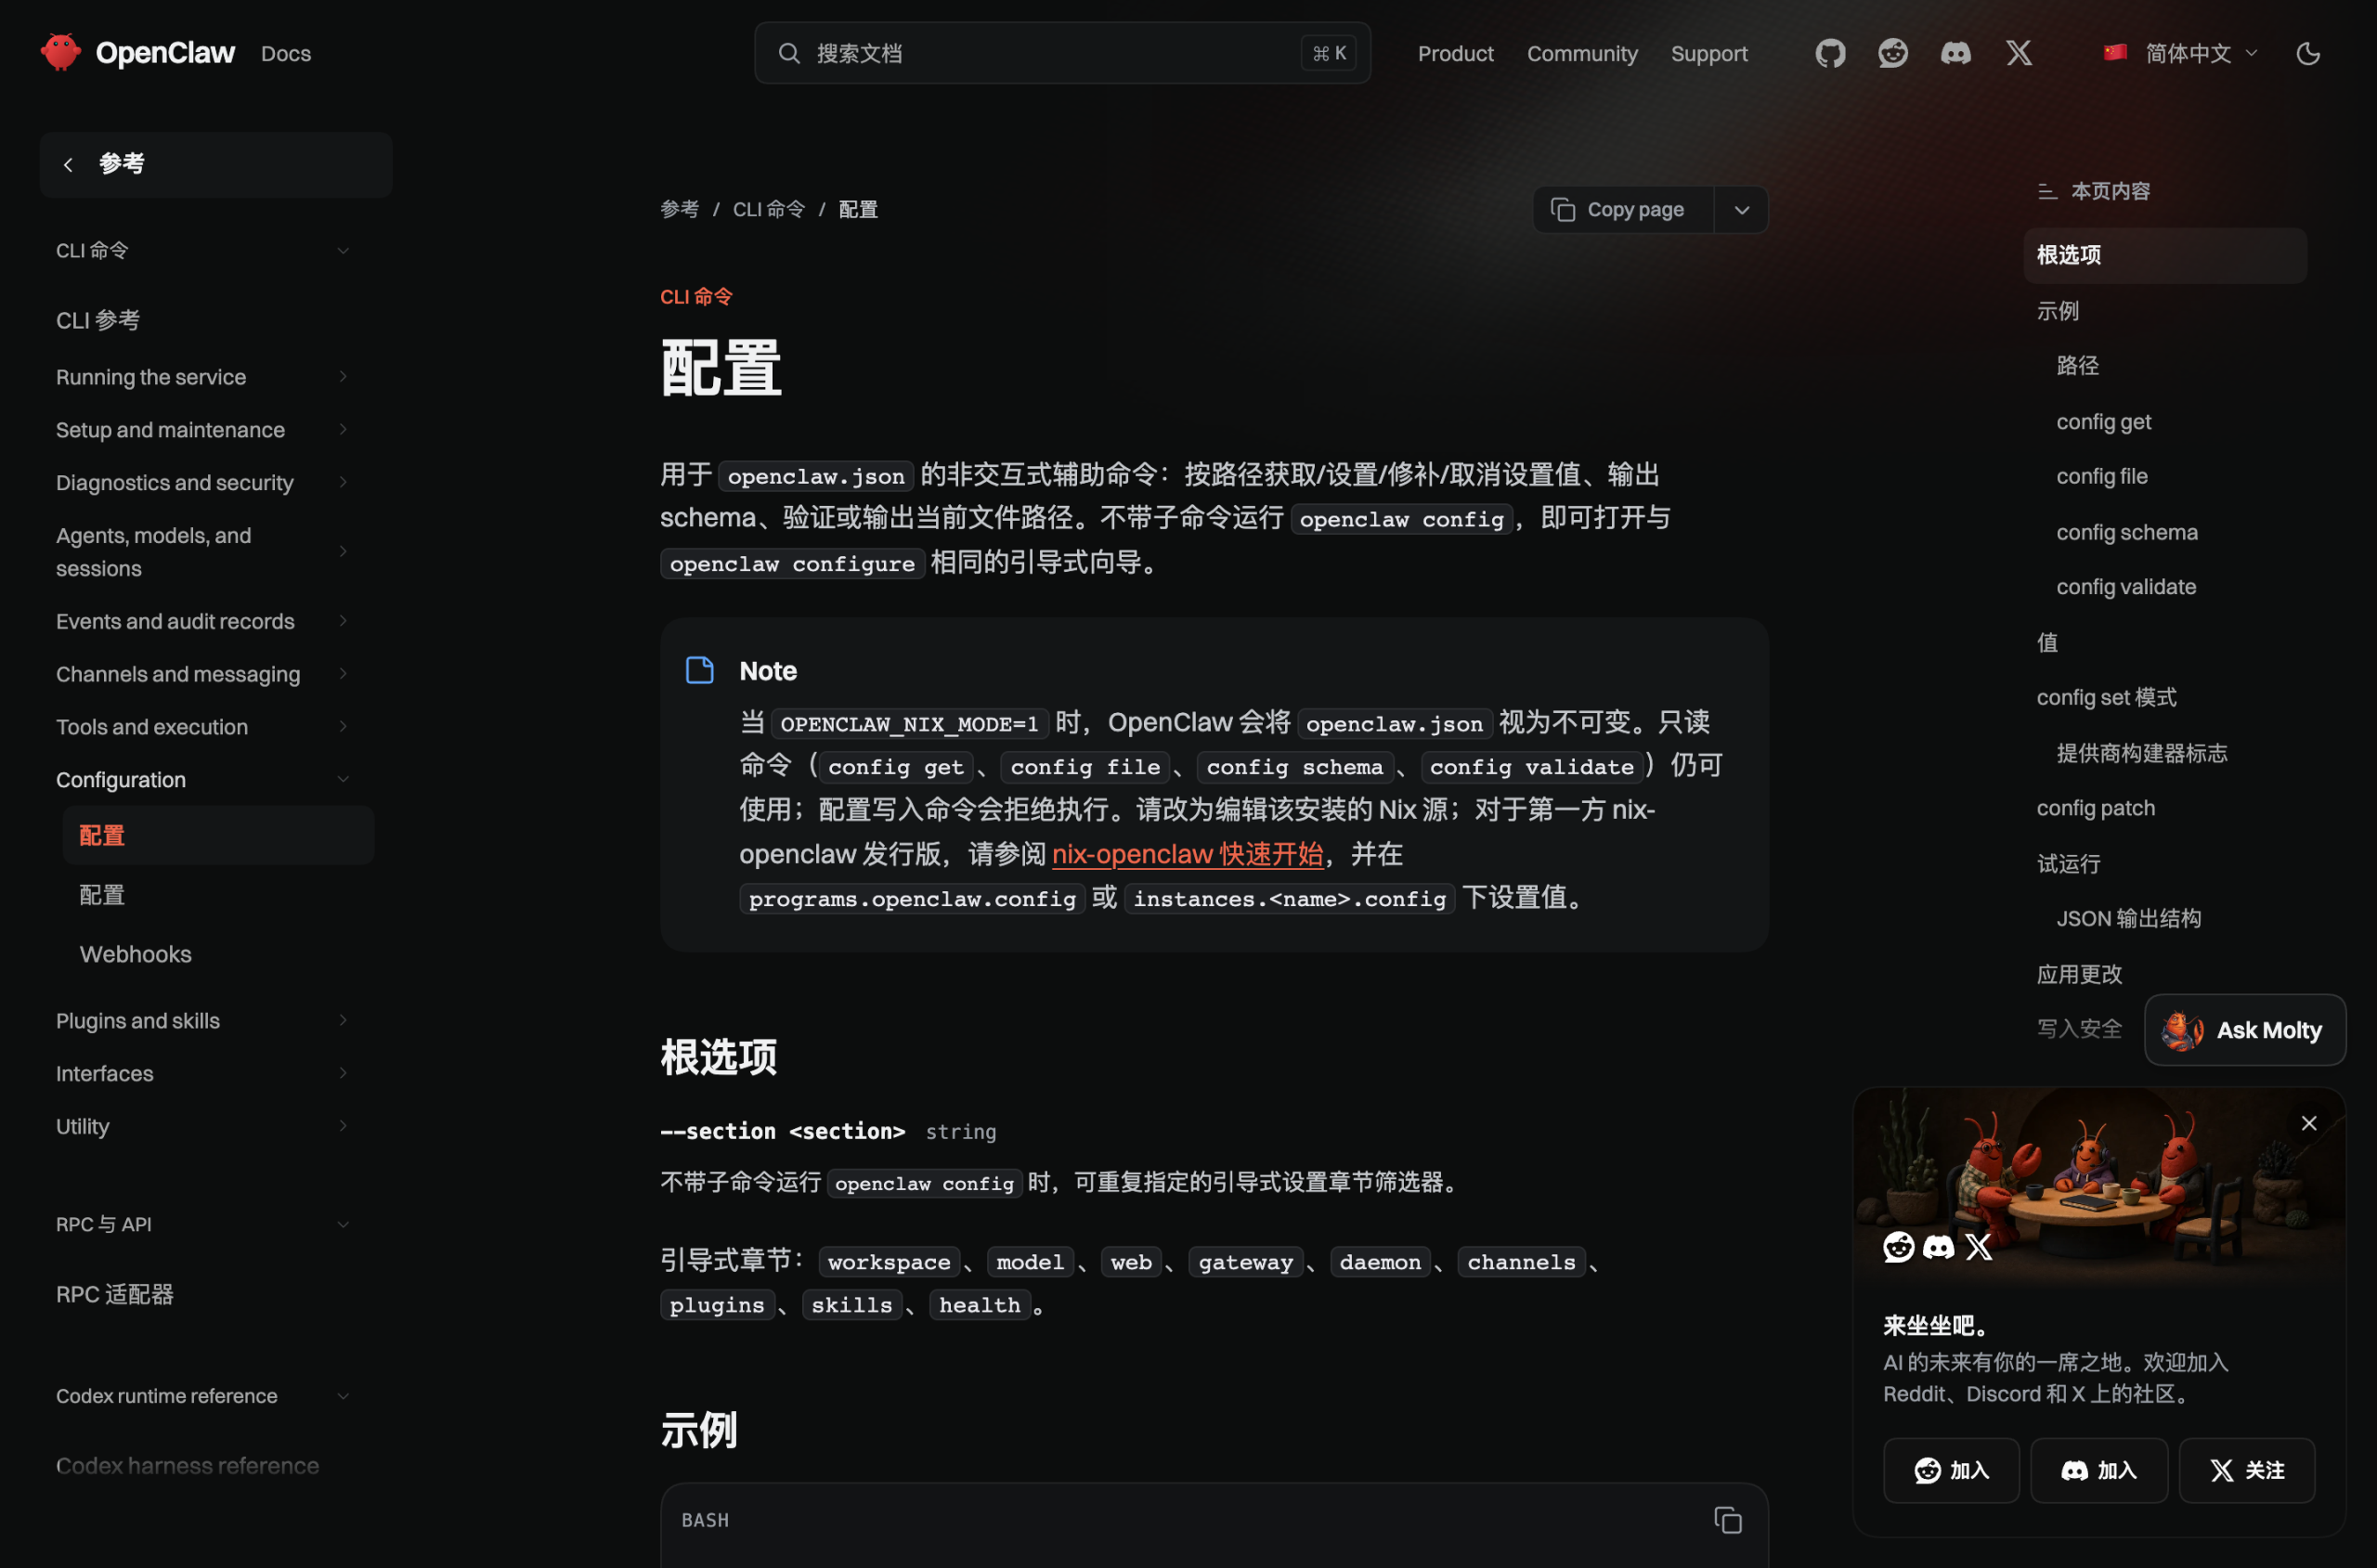
中文页面是实打实存在的,而且不是只翻了导航:我打开的 https://docs.openclaw.ai/zh-CN/cli/config 正文已经是完整中文(”用于 openclaw.json 的非交互式辅助命令:按路径获取/设置/修补/取消设置值……”),浏览器标题也是”配置 – OpenClaw”。同一条路径的 /zh/cli/config 则是 404——中文前綴只有 zh-CN 和 zh-TW 两种写法,/zh/ 不存在,这一点很容易踩。
再看搜索结果本身的构成:171 个唯一链接里,带 /zh-CN/ 前缀的为 0 条。也就是说,英文关键词查得再准,返回的永远是英文页。
那”先查英文、再手动换成中文页”这条绕行路线能走通多少?我把 171 个链接逐个换成 /zh-CN/ 前缀复测:
- 返回 200(有中文版):65 个,占 38.0%
- 返回 404(没有中文版):106 个,占 62.0%
所以绕行路线只能覆盖大约三分之一多的结果,剩下的页面根本没有中文版本,换前缀只会得到 404。
七、两个容易误判的细节
第一,标题和路径对不上是常态。 查 cron jobs,12 条结果里只有 2 条标题含 “cron”(”Automations (cron)”和”Worker-owned cron”),其余 10 条标题写的是 “Automations”、”Automation schedules”、”Automation payloads”,但它们的 URL 全在 /automation/cron-jobs/ 下。同一个产品概念在正文里已经从 cron 改叫 automations,索引显然也吃路径 slug,所以老关键词还能查到新页面。反过来说,只按标题去判断”这条结果相不相关”会误判。
第二,英文自然语言问句并不稳定。 我额外试了三句口语化英文:how do I restart the gateway 和 how do I stop the gateway 都返回 12 条(前三条都是 Gateway 相关页),但 what happens when my token expires 返回 0 条。同一套英文、同一时段,三句中有一句完全查不到。想把 docs 当问答用的人需要知道:它更像关键词检索,短名词短语的命中率明显高于长问句。
八、给中文用户的实际用法
按上面的实测,能落地的做法只有三步:
- 用英文短关键词查,两三个词,别写整句。
config validate、gateway token、exec approvals这类写法在 12 条测试里全部有结果。 - 拿到
/cli/...之类的链接后,把域名后的路径加上/zh-CN/再打开。171 条结果里 65 条能这样切到中文,其余会 404,404 就退回英文页。 - 别指望
--limit拉更多。上限 12 是服务端行为,要更多结果就换关键词分多次查。
九、明确的 UNKNOWN 与结论边界
- 搜索是关键词匹配还是向量检索:UNKNOWN,未测内部实现。
- 中文查询返回空的具体环节(分词丢弃 / 索引无中文 / 其他):UNKNOWN,外部只能观测到”0 条”。
- 索引更新延迟:UNKNOWN,本文只证明 05:12 这个时点 171 个链接全部 200,不能证明索引与站点内容实时同步。
- 其他非拉丁文字是否同样归零:UNKNOWN,只测了中文。
- 12 条是否是所有查询的硬上限:是本文观测到的最大值(部分查询只返回 3 条),但服务端阈值未公开。
结论只有一句是有证据支撑的:openclaw docs 对中文查询返回 0 条,而文档站 sitemap 里存在 721 个 zh-CN 页面;中文内容在,检索入口不在。 想让这条命令对中文可用,需要的是索引侧支持,而不是换写法或加大 --limit。
事实来源:openclaw docs --help、openclaw docs <query> --json(2026.10.7 / 157d8c2)、https://docs.openclaw.ai/api/search、https://docs.openclaw.ai/cli/docs、https://docs.openclaw.ai/sitemap.xml、https://docs.openclaw.ai/zh-CN/cli/config;全部在 2026-10-27 05:00–05:35(Asia/Shanghai)之间读取。