WorkBuddy 官网 sitemap 注释里挂着 9 个”候选页面”:7 个打开是 404,/blog 和 /privacy 是 CodeBuddy 的同一份页面
数据采集时间:2026-10-27 17:00–17:40(Asia/Shanghai)。更新时间:2026-10-27 17:40。
先把一个容易看错的地方说清楚:https://www.workbuddy.cn/sitemap-pages.xml 里一共有 12 个 <loc>,但只有 3 个在活动的 <urlset> 里,另外 9 个被整段包在 XML 注释的”待加入的候选页面”区块中。注释里的 URL 不会被搜索引擎当作 sitemap 条目解析,所以这不是”提交了 12 条、7 条 404″的提交错误——这是一份信息架构缺口清单:注释里列了 9 个”准备加入”的页面,其中 7 个今天打开是硬 404,剩下 2 个是另一个产品(CodeBuddy)的同一份页面。
正式声明的 3 条是干净的:/、/pricing/、/agents 原始请求全部 200。问题出在那份候选清单,以及清单背后已经不存在的页面。
一、sitemap 到底说了什么
sitemap-pages.xml 的文件头注释写着:Last generated: 2026-07-24,并声明”当前仅收录已上线且返回 200 的高质量页面”、”待 /blog 完成内容差异化(避免与 codebuddy.cn 重复)后再加入”。
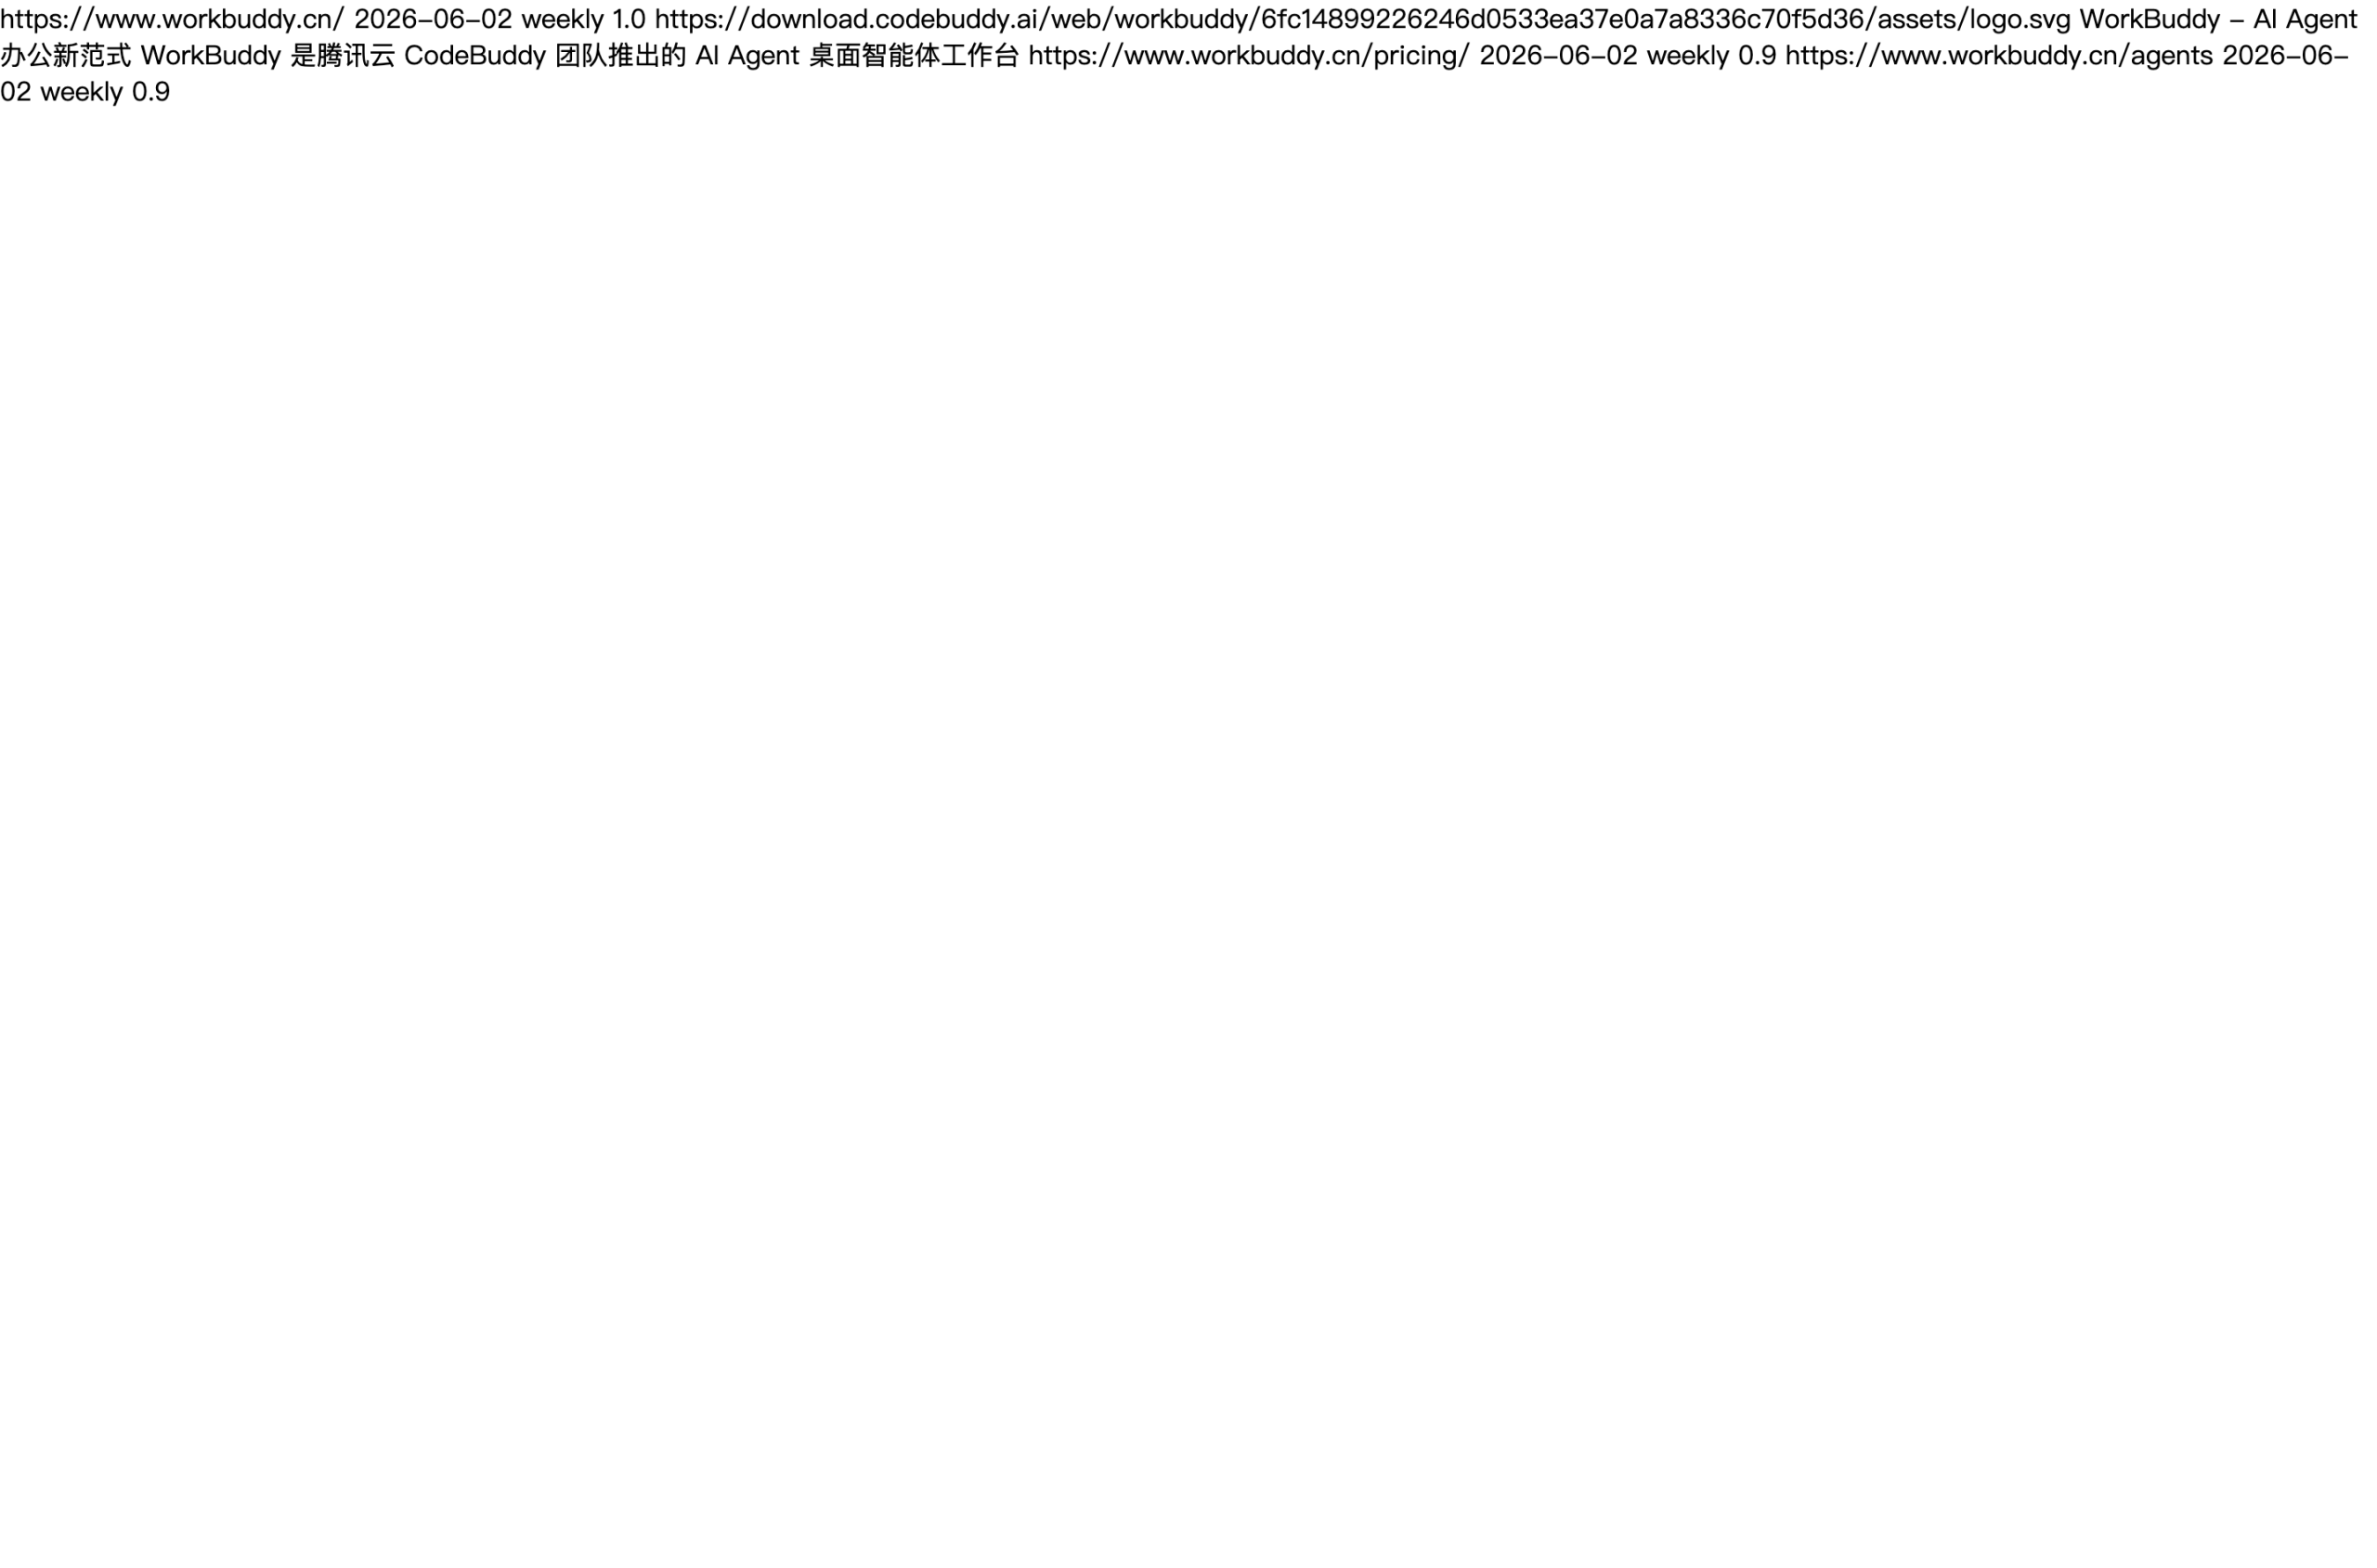
活动条目 3 条,每条都有 lastmod、changefreq、priority:
| 活动 URL | lastmod | changefreq | priority |
|---|---|---|---|
https://www.workbuddy.cn/ |
2026-06-02 | weekly | 1.0 |
https://www.workbuddy.cn/pricing/ |
2026-06-02 | weekly | 0.9 |
https://www.workbuddy.cn/agents |
2026-06-02 | weekly | 0.9 |
三个 lastmod 都停在 2026-06-02,距离采集日 147 天。首页还有 hreflang 的 zh-CN / x-default 两条 alternate,都指向自身。
注释区是这样写的(原文照录结构):
<!--
  待加入的候选页面
  <url><loc>https://www.workbuddy.cn/blog</loc>      ...</url>
  <url><loc>https://www.workbuddy.cn/privacy</loc>   ...</url>
  <url><loc>https://www.workbuddy.cn/terms</loc>     ...</url>
  <url><loc>https://www.workbuddy.cn/about</loc>     ...</url>
  <url><loc>https://www.workbuddy.cn/download</loc>  ...</url>
  <url><loc>https://www.workbuddy.cn/skills</loc>    ...</url>
  <url><loc>https://www.workbuddy.cn/templates</loc> ...</url>
  <url><loc>https://www.workbuddy.cn/use-cases</loc> ...</url>
  <url><loc>https://www.workbuddy.cn/changelog</loc> ...</url>
-->
注意注释里那条”待 /blog 完成内容差异化(避免与 codebuddy.cn 重复)后再加入”——这句话是这份文件里最有信息量的一行,后面会看到它有多准。
二、我测了什么
- 目标:
sitemap-pages.xml中的 12 个<loc>(3 个活动 + 9 个注释候选),逐条请求。 - 方法 A:不执行 JS 的原始 HTTP 请求,桌面 Chrome UA,手动跟随重定向,记录每一跳的状态码、
Location、Content-Type、响应字节数。 - 方法 B:Playwright 驱动 Chromium 1243,1440×950,
networkidle后读document.title、h1、可见文字长度,并截图。 - 补充一:把 docs 四个叶子 sitemap 的 185 条文档 URL 全部抓取,统计是否链接到上面 9 个候选路径。
- 补充二:把
workbuddy.cn/blog/、workbuddy.cn/privacy/的渲染文本与codebuddy.cn对应页做归一化 SHA-256 比对。
没有登录任何后台,没有用 GSC、百度资源平台或流量工具的数据。
三、9 个候选路径的实测结果
| # | 注释里的候选 URL | 原始 HTTP | 渲染结果 |
|---|---|---|---|
| 1 | /blog |
301 → /blog/ 200 |
标题「腾讯云代码助手 CodeBuddy IDE – AI 时代的智能编程伙伴」,h1「博客」 |
| 2 | /privacy |
301 → /privacy/ 200 |
标题与 h1 均为「腾讯云代码助手隐私保护声明」 |
| 3 | /terms |
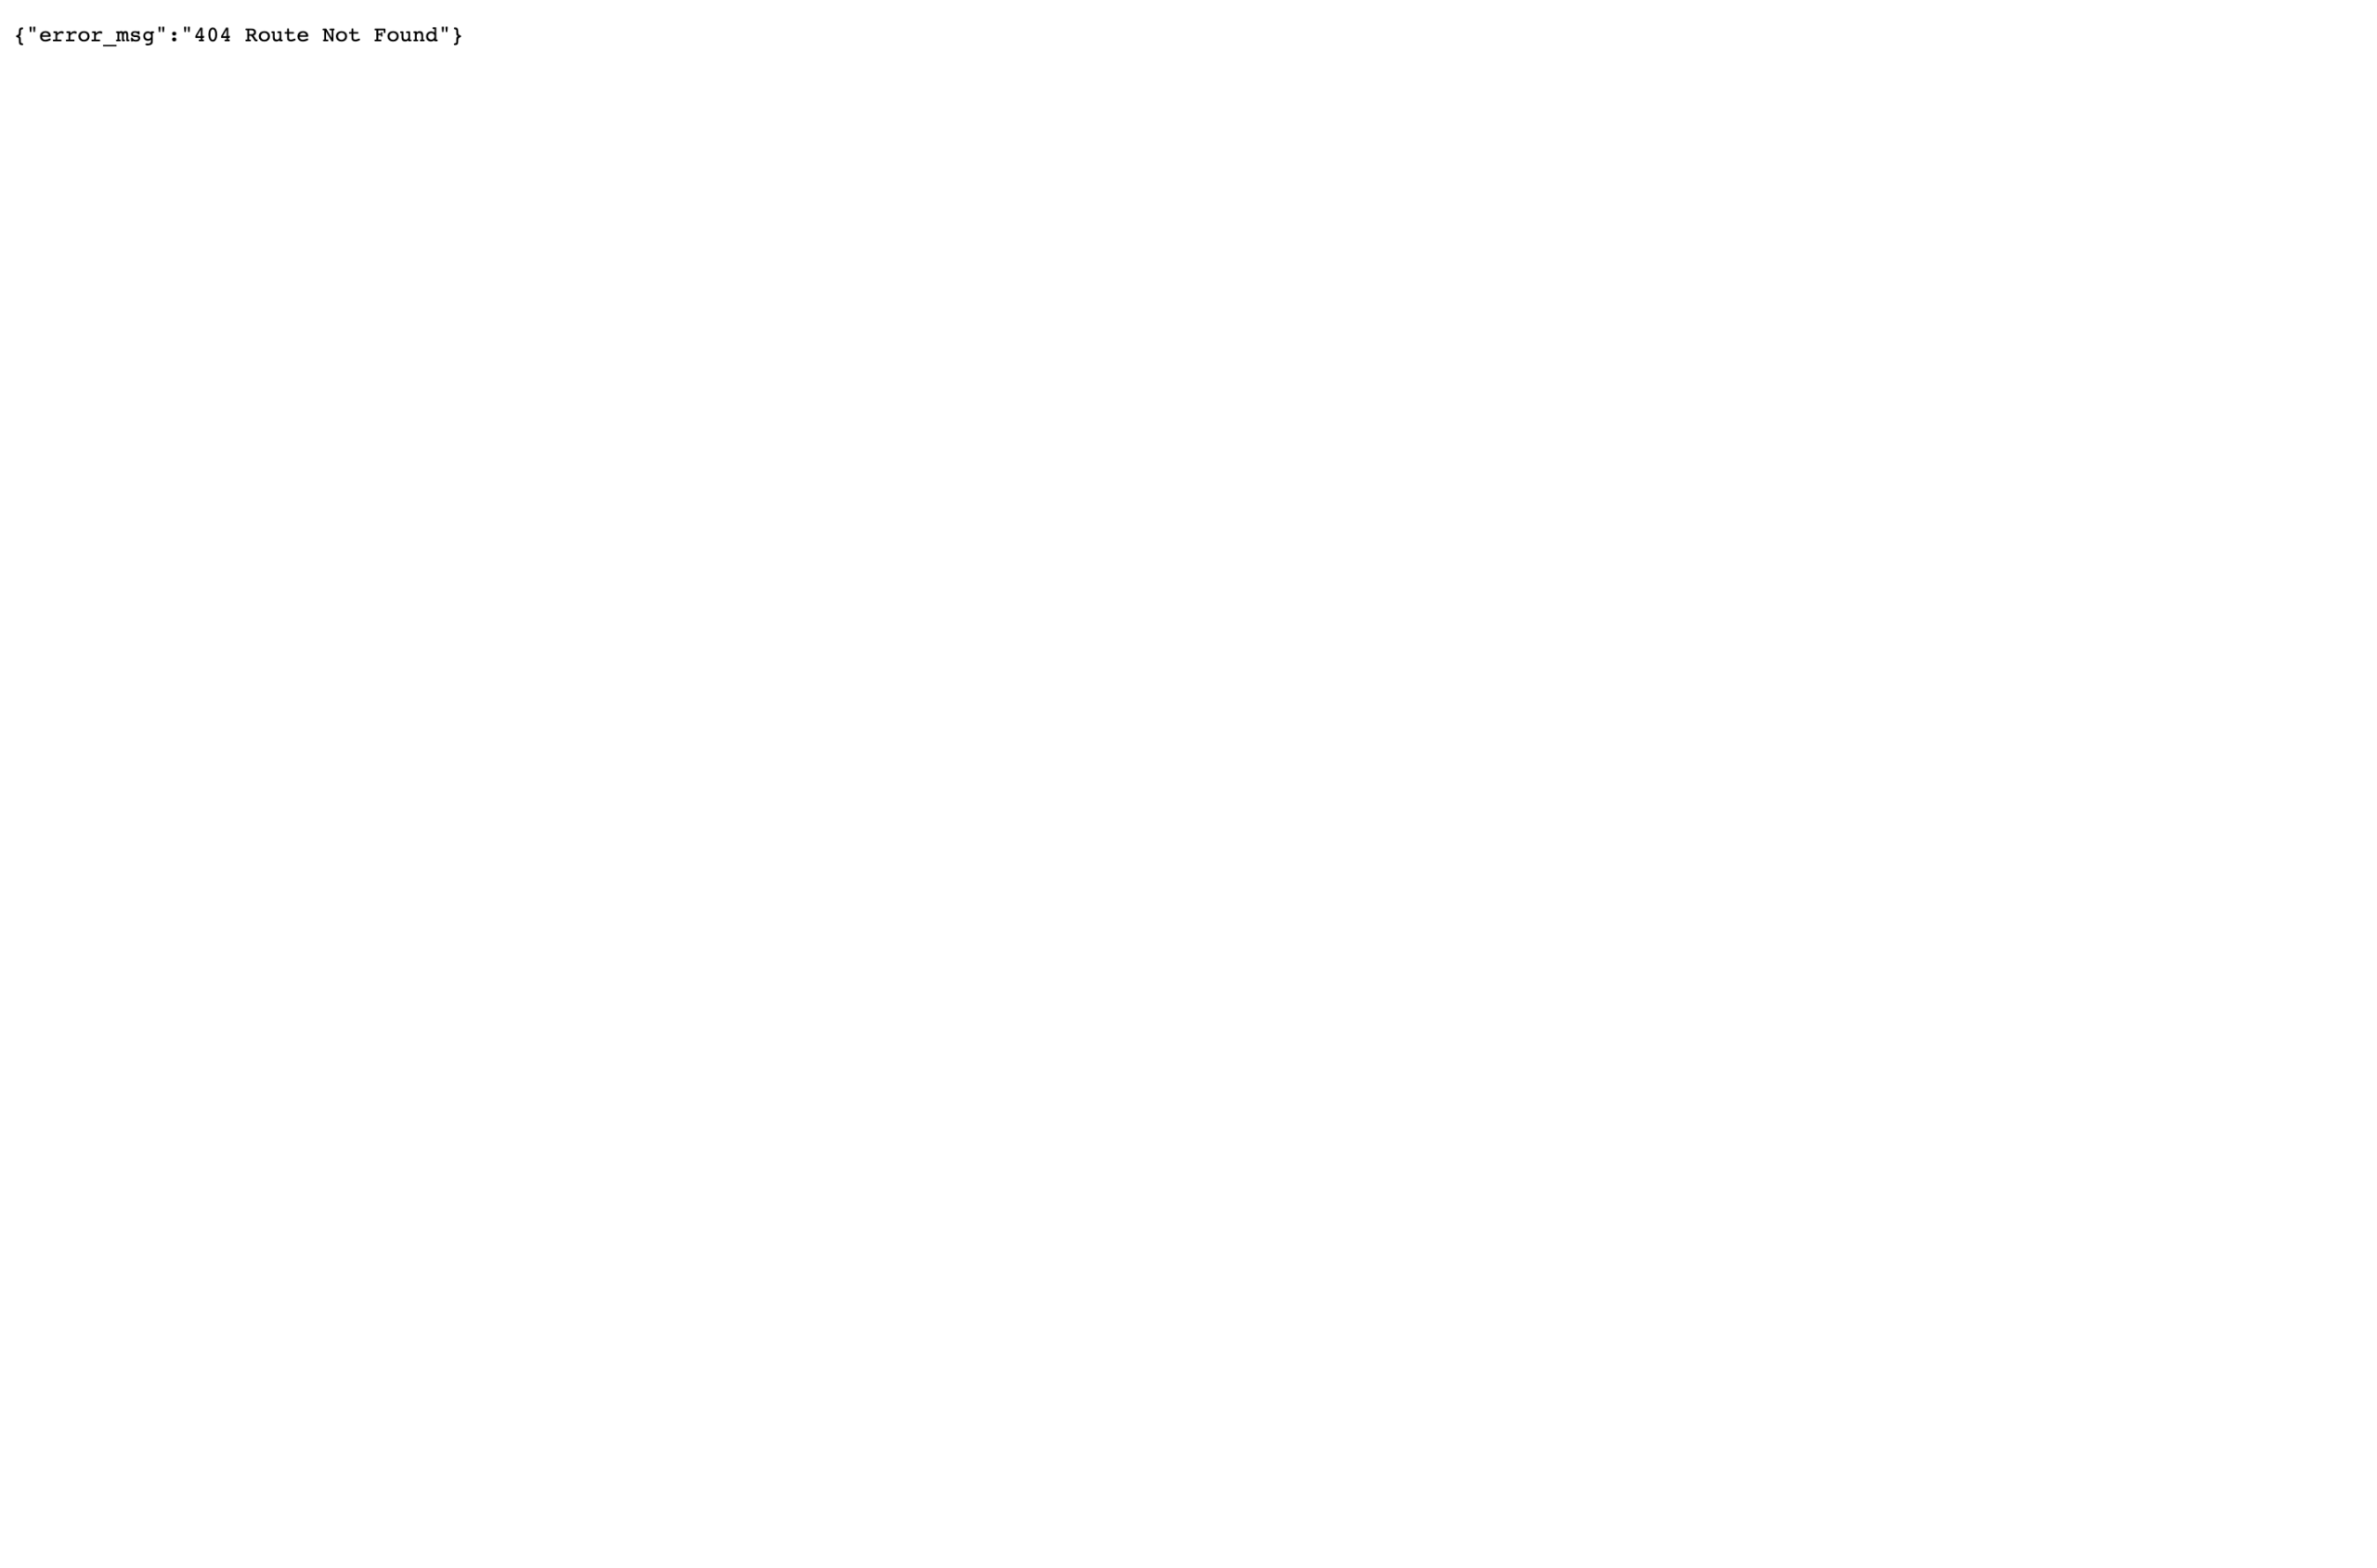
404 | {"error_msg":"404 Route Not Found"},36 字节,text/plain |
| 4 | /about |
404 | 同上 |
| 5 | /download |
404 | 同上 |
| 6 | /skills |
404 | 同上 |
| 7 | /templates |
404 | 同上 |
| 8 | /use-cases |
404 | 同上 |
| 9 | /changelog |
404 | 同上 |
7 条 404 不是”页面里写着找不到”,而是网关层的硬 404:响应头 server: APISIX/3.9.1,Content-Type: text/plain,正文 36 字节 JSON。给这 7 条全部加尾斜杠(/download/、/skills/ 等)重试,依然全部 404,所以不是少一个斜杠的路由细节,是这些路由不存在。
两条 200 的活动条目也顺带测了:/ 返回 15,278 字节,标题「WorkBuddy – AI Agent 办公新范式」,canonical 指向自身;/pricing/ 返回 11,605 字节,h1「WorkBuddy 个人版」。第三条 /agents 原始 HTML 是 200(42,065 字节),但浏览器渲染后跳到 /login/?platform=agents&state=0&redirect_uri=…,可见正文只剩 164 个字符——它是个需要登录的入口,不是可索引的内容页。
顺带查了首页导航里另外两个入口:/enterprise/ 渲染后落在 /enterprise/product,200,标题「产品介绍 – WorkBuddy 企业版」,正文 1,715 字符;/hardware 301 到 /hardware/,200,标题「WorkBuddy 智能硬件生态」,正文 1,408 字符。这两条可索引页面既不在 3 条活动条目里,也不在 9 条候选里。
四、/blog 和 /privacy:与 CodeBuddy 站字节级一致
这两条不是 404,但问题不比 404 小。
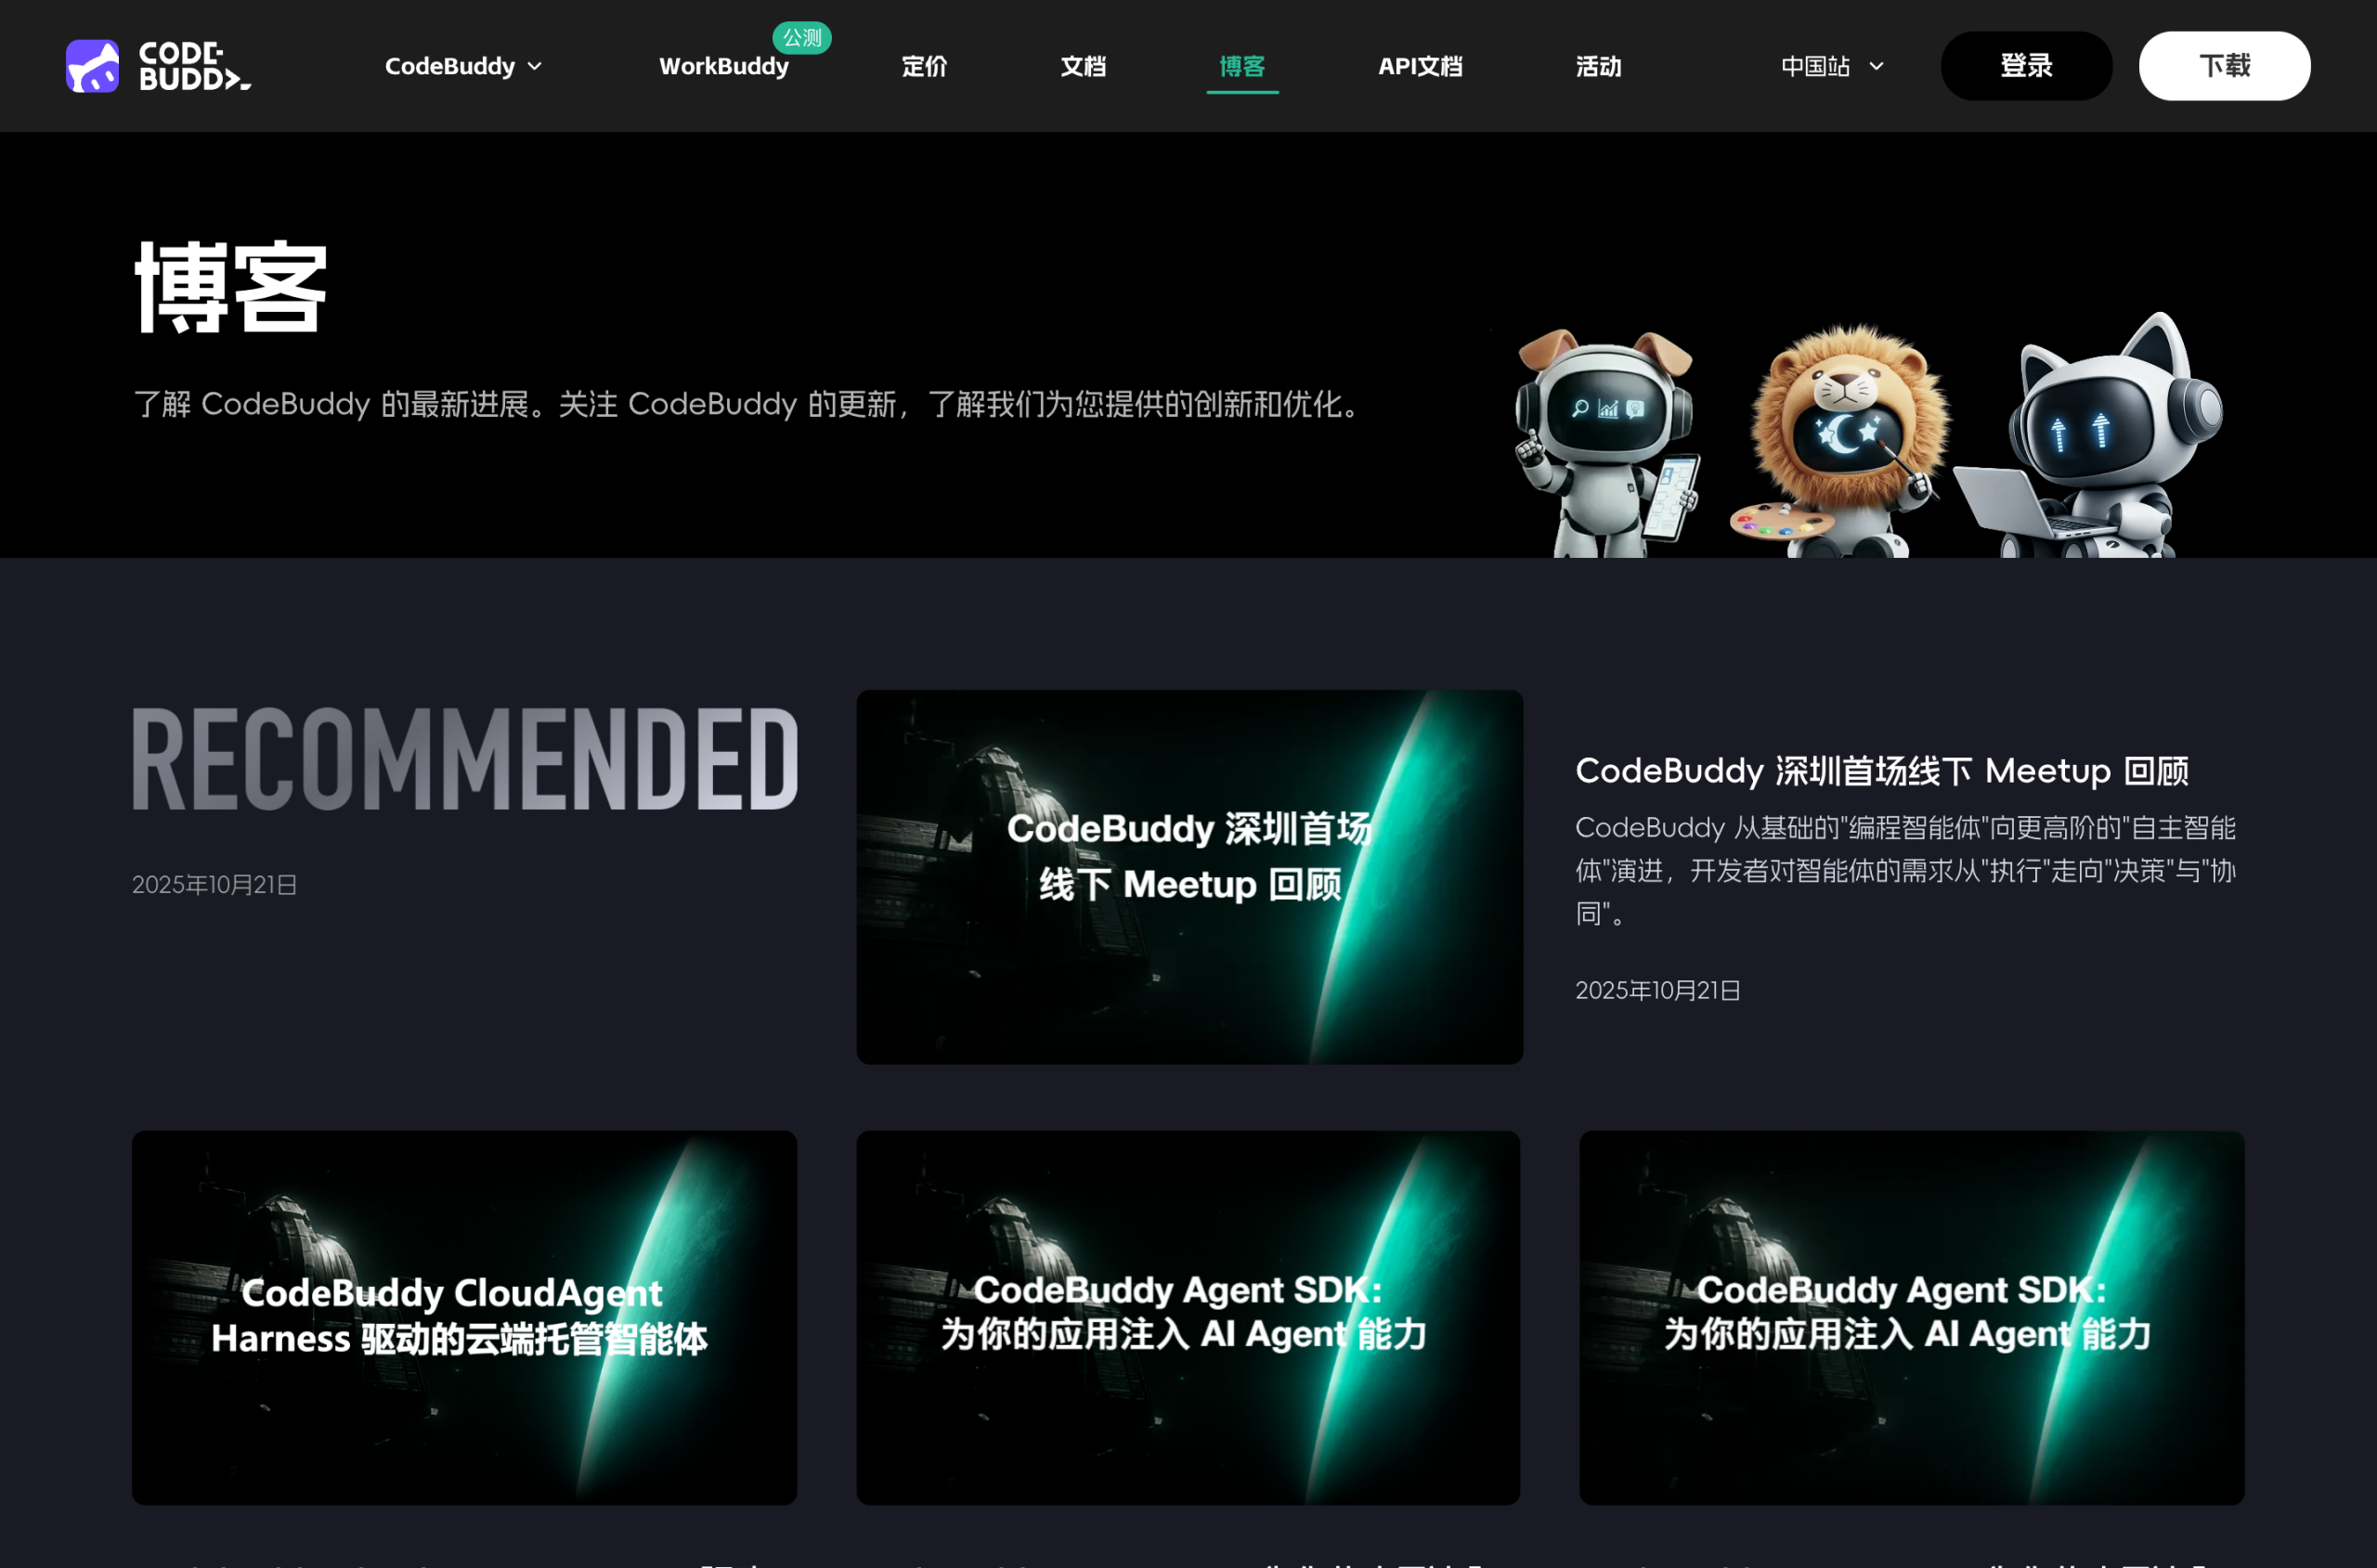
workbuddy.cn/blog/ 渲染出来是 CodeBuddy 博客:<title>「腾讯云代码助手 CodeBuddy IDE」,h1「博客」,导航是 /ide/、/cli/、/npc/、/security/、/work/ 这些 CodeBuddy 路径,副标题写「了解 CodeBuddy 的最新进展」。首屏 30 篇文章(id 3–34),最新一篇日期 2026 年 4 月 10 日,距采集日 200 天。
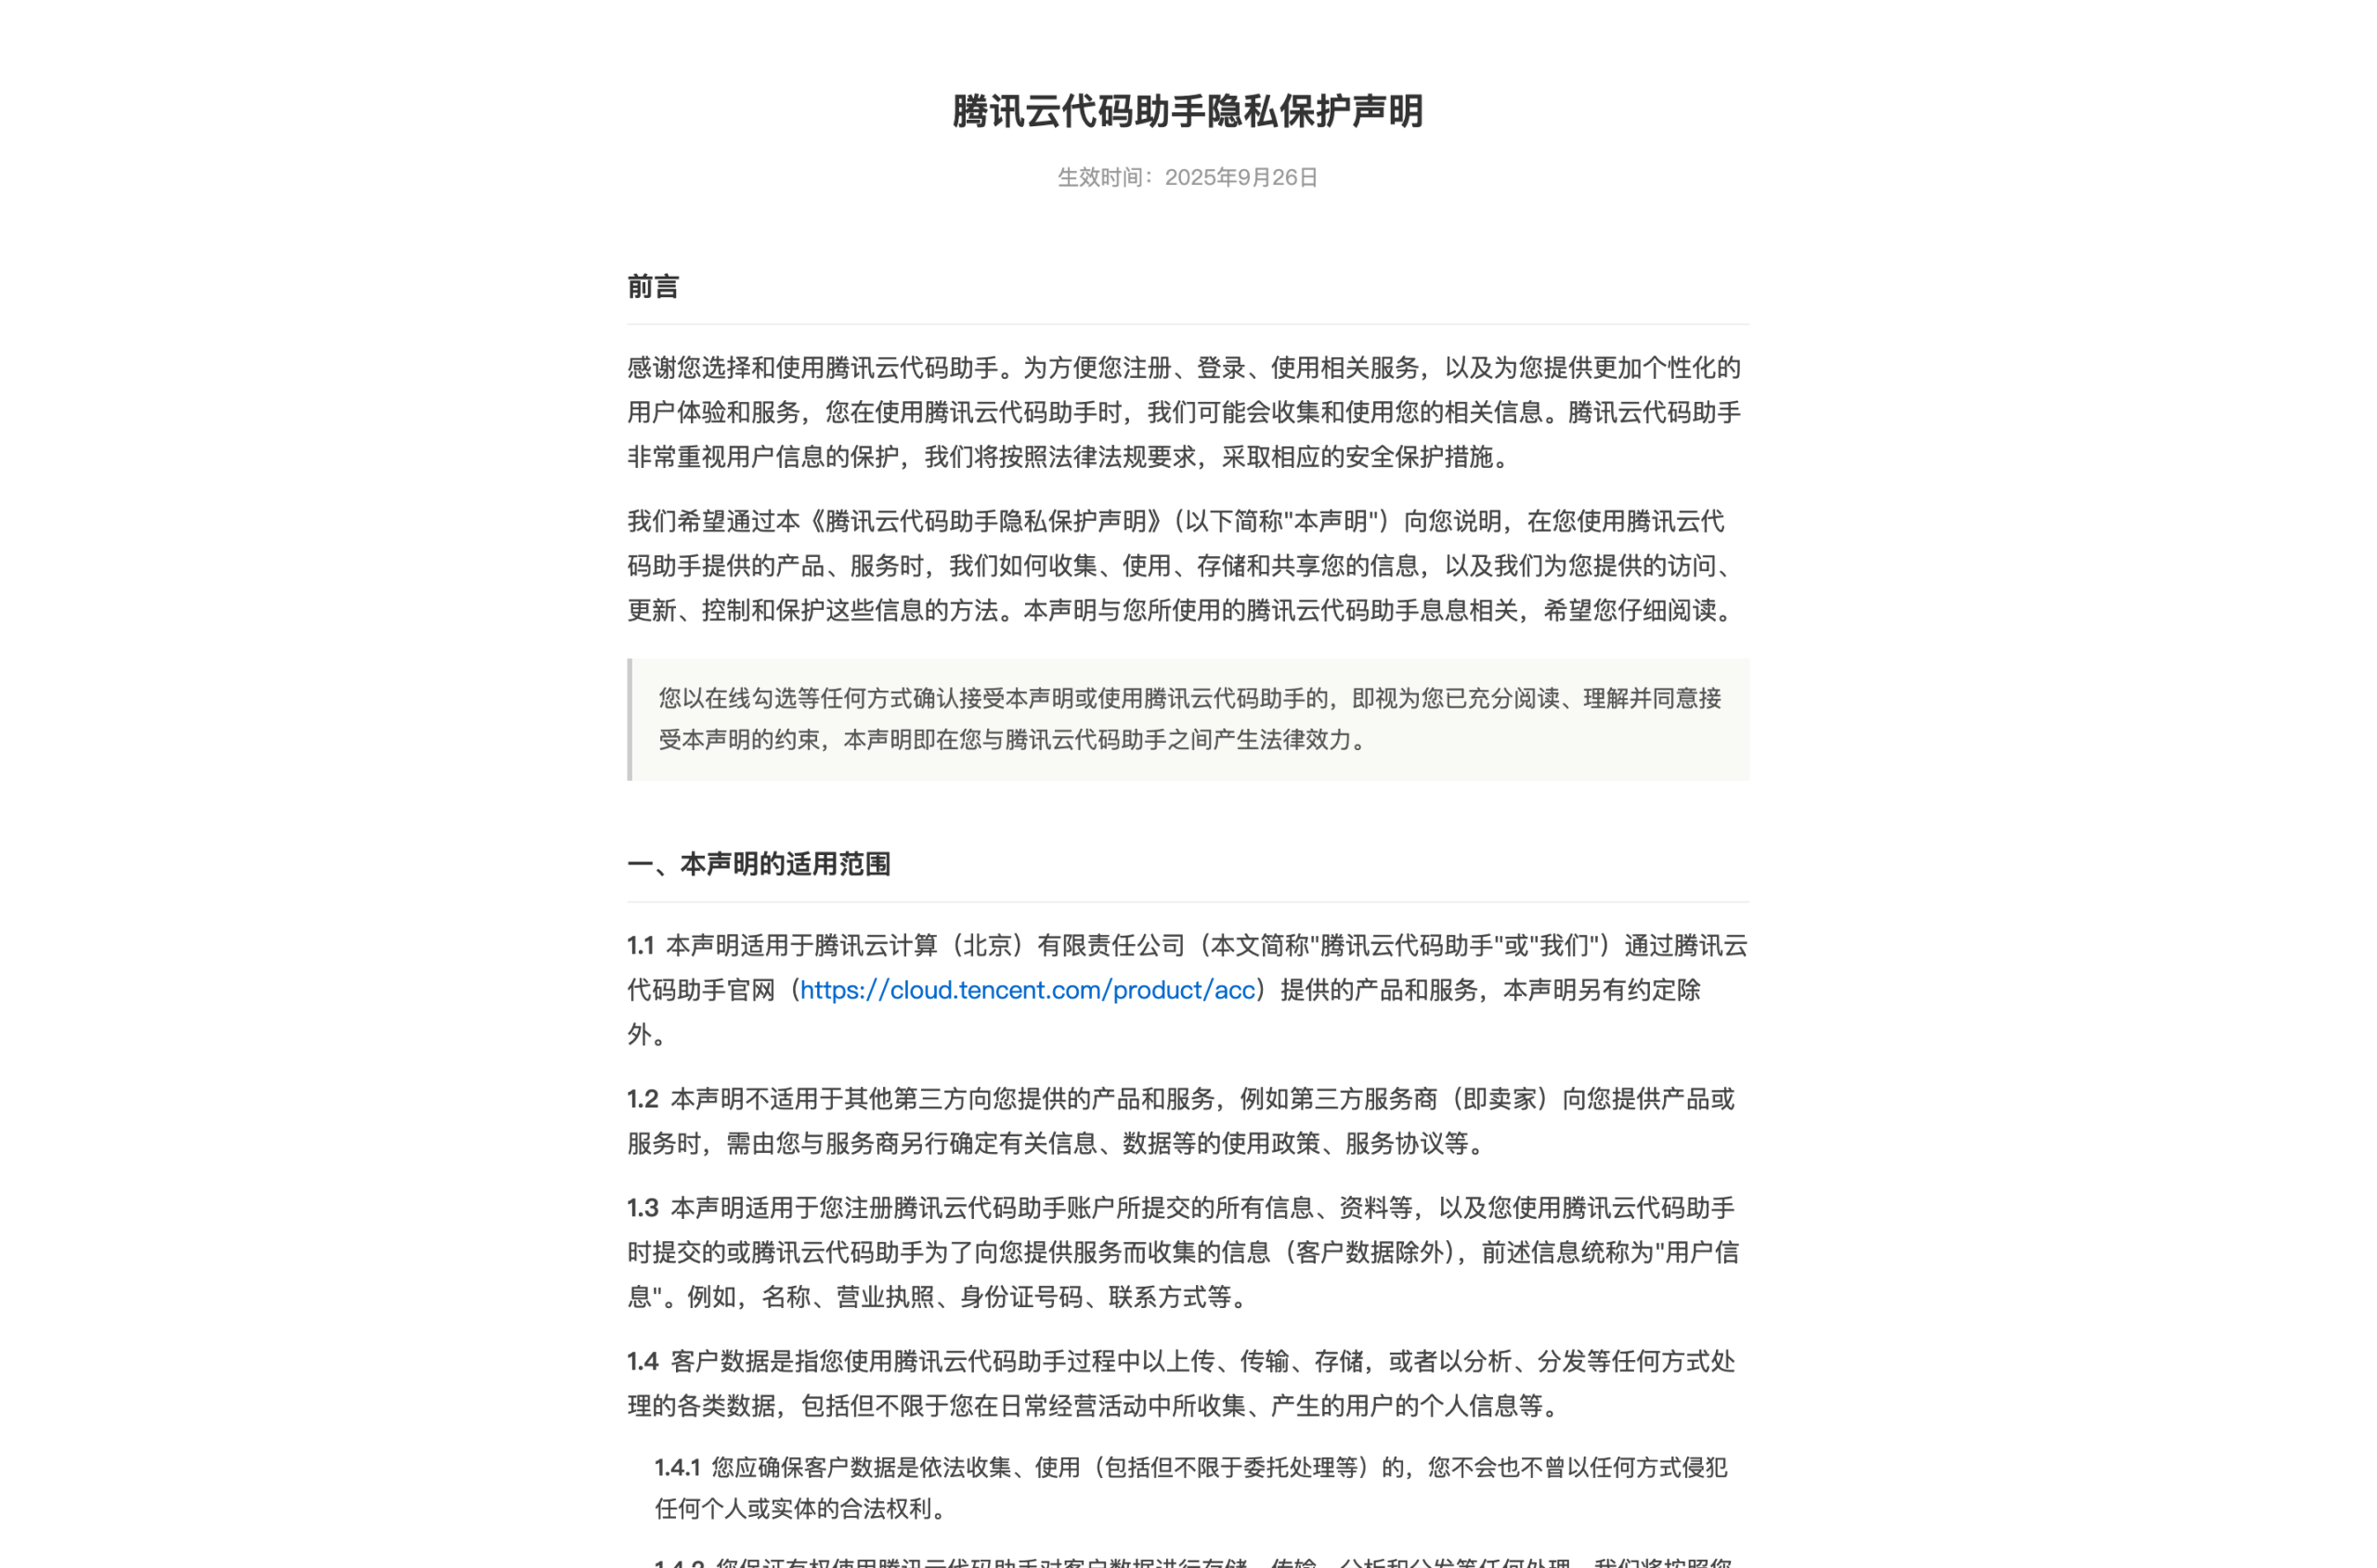
workbuddy.cn/privacy/ 渲染出来是「腾讯云代码助手隐私保护声明」,正文 9,258 字符。
用同一套渲染流程对比 codebuddy.cn:
workbuddy.cn/blog/vscodebuddy.cn/blog/:归一化可见文本 SHA-256 都是c47da365694deb6566f5d18263b689be35d68125266f60b1ab329f12bd69c179,长度都是 6,150 字符。workbuddy.cn/privacy/vscodebuddy.cn/privacy/:归一化可见文本 SHA-256 都是859975780afa1d726e0ef3a2953aae3e281e7b13b04e7da26be6a30fac38e51c,长度都是 9,258 字符。
这两个页面都没有 rel="canonical"(渲染后 DOM 里 link[rel=canonical] 不存在)。/blog/ 连 og:site_name 都没有,meta description 还是 CodeBuddy 的产品介绍。换句话说:WorkBuddy 站上用两个路径,完整托管了另一个产品的博客与隐私声明,且没有告诉搜索引擎”真正的版本在哪”。
这也解释了 sitemap 注释为什么把它们压在候选区——维护者知道这个重复问题存在。
五、这 9 个路径在站内没有任何入口
一个容易被忽略的细节:这些候选页面不是用户点进去的,是写在 sitemap 注释里的”计划”。
- 首页渲染后有 34 个链接,没有任何一个指向
/download、/skills、/templates、/use-cases、/changelog、/about、/terms、/blog、/privacy。首页的下载入口是#download-section锚点,页脚的隐私与条款分别指向privacy.qq.com和rule.tencent.com的外部文档。 - docs 四个叶子 sitemap 的 185 条文档 URL 全部抓取(全部返回 200),在 HTML 里搜索指向上述 9 个路径的链接:命中数全部为 0。
所以现状是:sitemap 活动清单里可直接索引的自有页面只有首页和定价页两页(/agents 要登录);站点上至少还有 /enterprise/product、/hardware/ 两个可索引页面没被列入,下载、更新日志、模板、技能市场、关于、条款这些路径则要么不存在,要么以锚点和第三方文档的形式散落在首页与页脚里。
六、这件事的实际影响
- “下载””更新日志””模板”这些高意图路径没有落地页。
/download、/changelog、/templates、/skills、/use-cases全是 404。用户从搜索引擎或外部链接过来,只会看到 36 字节的 JSON 错误。这些词对应的搜索需求是明确存在的,但站点没有可承接的页面——这是产品信息架构问题,不是 sitemap 提交问题。 - 注释里的候选清单已经过期至少 95 天。 文件
Last generated: 2026-07-24,三个活动条目的lastmod停在 2026-06-02。候选清单里 7 条路由在这段时间内没有任何一条变成可用页面,也没有被从清单里删掉。 - 跨产品重复内容风险。
/blog与/privacy在 workbuddy.cn 域名下提供 CodeBuddy 的内容,文本哈希完全一致,且无 canonical。如果这些页面被索引,同一份内容会以两个域名出现;对用户来说,点”隐私声明”读到的是另一个产品的声明,这是合规文本归属问题。 - sitemap 覆盖面与站点结构脱节。 活动
<urlset>只有 3 条,其中 1 条要登录;实测可索引的/enterprise/product、/hardware/都不在其中,候选清单里又躺着 7 个 404。对比 docs 侧 185 条文档 URL 全部 200,能看出维护精力集中在文档站,官网着陆页这一层长期没跟上。 - 注释不是提交内容,所以这不是”无效提交”。 需要强调:搜索引擎不会解析 XML 注释里的
<url>,这 9 条从未通过这份 sitemap 提交过。把它当成”提交错误”会误判修复方向——真正要做的是补页面或删候选,而不是改 sitemap 的提交格式。
七、修复顺序
- 先给 7 条 404 路由定性。 要么恢复页面(下载页、更新日志、模板、技能市场都是产品入口),要么从注释候选清单里删掉。保持”候选了 95 天、打开是 404″的状态没有收益。
/blog和/privacy二选一。 要么把 canonical 指到 codebuddy.cn 对应页并从 workbuddy.cn 的候选清单移除;要么替换成 WorkBuddy 自己的博客与隐私声明。注释里已经写明”待 /blog 完成内容差异化”,说明团队清楚这件事,需要的是执行。- 补页面后同步活动
<urlset>。 新页面要进活动的<url>段,并给真实lastmod;现在 3 条的lastmod全是同一天(2026-06-02),批量同日期等于没有增量信号。顺带把实测 200 的/enterprise/product、/hardware/补进清单。 /agents要么做成公开介绍页,要么移出 sitemap。 现在它 200 但渲染即跳登录,对搜索没有承接价值。- 上线后回归验证。 下面这段命令同时检查 3 条活动条目和 9 条候选:
for p in / /pricing/ /agents /blog /privacy /terms /about /download /skills /templates /use-cases /changelog; do
  printf '%-14s ' "$p"
  curl -s -o /dev/null -w '%{http_code} %{redirect_url}\n' -A 'Mozilla/5.0' "https://www.workbuddy.cn$p"
done
判定标准:活动条目必须 200(或 301/308 指向 200);候选条目若长期不是 200,就不该继续挂在”待加入”里。
八、未知项
- 这 7 条 404 路由是有意下线,还是迁移时漏配,站外无法判断。我没有任何内部发布记录或路由表。
- 我没有 GSC / 百度资源平台数据,不知道这些路径是否曾被抓取、是否产生过展现,也不估算流量或排名损失。
/agents登录后的真实内容没有验证,只记录了未登录时的跳转行为。- 本文只覆盖
sitemap-pages.xml(3 条活动 + 9 条注释候选)。sitemap.xml索引里只列了这一份子 sitemap;docs 的 185 条文档 URL 在本次采集中全部返回 200,不在问题范围内。 /enterprise/product与/hardware/只验证了渲染后标题、h1 和正文长度,没有逐段核对内容质量。
参考来源(均为 2026-10-27 17:00–17:40 实测): https://www.workbuddy.cn/sitemap-pages.xml、https://www.workbuddy.cn/sitemap.xml(索引注释 Last generated: 2026-09-07,子 sitemap lastmod 2026-07-24)、https://www.workbuddy.cn/robots.txt(6,423 字节,两条 Sitemap 声明)、https://www.workbuddy.cn/docs/sitemap.xml 及 4 个叶子 sitemap(185 条 URL)、上述 12 条路径、https://www.codebuddy.cn/blog/、https://www.codebuddy.cn/privacy/。