WorkBuddy 双站文档实测:288 条官方 URL 全部 GET 200 / HEAD 404,19/24 条跨站路径渲染成 “PAGE NOT FOUND”
一、先说结论
2026 年 10 月 16 日晚,我把 WorkBuddy 国内站(workbuddy.cn)和海外站(workbuddy.ai)的官方 sitemap 全部拉下来做了一次交叉实测。四个数字构成了这篇文章:
- 288 条官方 sitemap 声明的文档 URL,100% 返回 GET 200,同时 100% 返回 HEAD 404
- 两站文档 URL 集合只重叠 26 条;154 条只在 .cn,82 条只在 .ai
- 跨站抽样 24 条”对方 sitemap 里没有”的路径,19 条渲染成 “PAGE NOT FOUND”(79.2%),只有 5 条还能打开
- 同一个路径在两站的响应体可以字节级完全相同(md5 一致),而页面内容是错的
第 4 条是我在写作过程中差点写错、被自己的脚本抓出来的。下面完整展开。
二、最有工程价值的一条:HEAD 探活在这两个站点上 100% 假阳性
大多数站点巡检脚本判断 URL 是否有效,第一个动作是发一个 HTTP 请求,看到 200 就记”正常”。在 WorkBuddy 文档站上,这个判断必然出错。
我的实测分三步,每一步都推翻了一步的结论:
第一步,纯 GET。 curl https://www.workbuddy.ai/docs/enterprise/price/Pricing 返回 200,响应体 3,882 字节,是 VitePress 的空壳
。我据此判断该页在海外站”不存在”。
第二步,headless Chrome 渲染 DOM。 用 --dump-dom 让浏览器真正执行 JS 后读 DOM,结果 h1 是”产品概述”,内容存在。我的结论被推翻。
第三步,换 HEAD 请求,这是决定性的一步:
HEAD  https://www.workbuddy.ai/docs/workbuddy/Subscription   → 404
GET   https://www.workbuddy.ai/docs/workbuddy/Subscription   → 200
HEAD  https://www.workbuddy.ai/                              → 200
GET   https://www.workbuddy.ai/                              → 200
响应头显示 server: APISIX/3.12.0(.ai)与 APISIX/3.9.1(.cn)。APISIX 网关对 /docs 路径的 HEAD 请求统一返回 404,与页面是否真实存在无关;而 GET 无论页面存在与否都返回 200 加空壳,真正的 404 判断被推迟到浏览器端 JS。
把这个测法跑满两个站点全部 sitemap URL:
| 域名 | sitemap URL 数 | GET 200 | HEAD 404 | 其他 |
|---|---|---|---|---|
| workbuddy.ai | 108 | 108 | 108 | 0 |
| workbuddy.cn | 180 | 180 | 180 | 0 |
| 合计 | 288 | 288 | 288 | 0 |
288 条官方声明存在的文档页,无一例外 HEAD 404。 两个后果很实际:
- 任何用 HEAD 探活做死链巡检的工具,在这两个站点上会报 288 条坏链,而它们全是好链。
- 任何只看状态码就判定”链接有效”的引用建设流程,会把 288 个 URL 全当成可用外链资源,其中 79% 在另一站打不开。
三、两个域名的文档根本不是同一套东西
| 集合 | 数量 | 说明 |
|---|---|---|
| 交集(两边都有) | 26 | 入门指南、功能说明、平台接入 |
| 仅 .cn | 154 | 企业版 27 + 小程序 18 + 移动端 15 + 主文档 94 |
| 仅 .ai | 82 | 中文路径 53 + 主文档 29 |
| 并集 | 236 | 两站通用内容仅占 11% |
按板块拆开:
| 板块 | .cn 独有 | .ai 独有 |
|---|---|---|
| 企业版 /docs/enterprise | 27 | 0 |
| 小程序 /docs/workbuddymini | 18 | 0 |
| 移动端 /docs/workbuddyapp | 15 | 0 |
| 主文档 /docs/workbuddy | 94 | 29 |
| 中文路径 /docs/zh/workbuddy | 0 | 53 |
海外站的 /docs/sitemap.xml 下只有 4 个叶子(root / workbuddy / zh-root / zh-workbuddy),整个企业版文档树一页都没有。反过来,国内站 sitemap 里没有一条 /docs/zh/ 中文路径。
四、跨站抽样:19/24 条渲染成 404
我从 154 条 .cn 独有和 82 条 .ai 独有路径里按板块分层抽样 24 条,在”对方域名”上用 headless Chrome 渲染(curl 无法判定,见 §七),结果:
| 抽样分组 | 抽样数 | 渲染成功 | 渲染 404 |
|---|---|---|---|
| .cn 独有 → 在 .ai 上打开 | 16 | 4(全部为企业版) | 12 |
| .ai 独有 → 在 .cn 上打开 | 8 | 1 | 7 |
| 合计 | 24 | 5 | 19(79.2%) |
真实失败的例子(渲染后 h1 = “PAGE NOT FOUND”):
.ai/docs/workbuddyapp/Overview                          → 404
.ai/docs/workbuddymini/features/Settings                → 404
.ai/docs/workbuddy/Changelog-5.8.2                      → 404
.cn/docs/zh/workbuddy/Claw                              → 404
.cn/docs/workbuddy/Platform-Integration/Telegram-Guide  → 404
.cn/docs/zh/workbuddy/Platform-Integration/Slack-Guide  → 404
这几条我各重复渲染 4 次,4/4 结果完全一致,站点行为是确定性的,不存在抖动。作为对照,我编造的两个假路径 .ai/docs/zzz-control-20261016 和 .cn/docs/zzz-definitely-not-a-page-20261016 渲染结果同样是 “PAGE NOT FOUND”——真缺页和假缺页在响应体层面无法区分,只能靠渲染后的 h1。
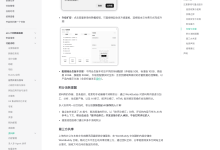
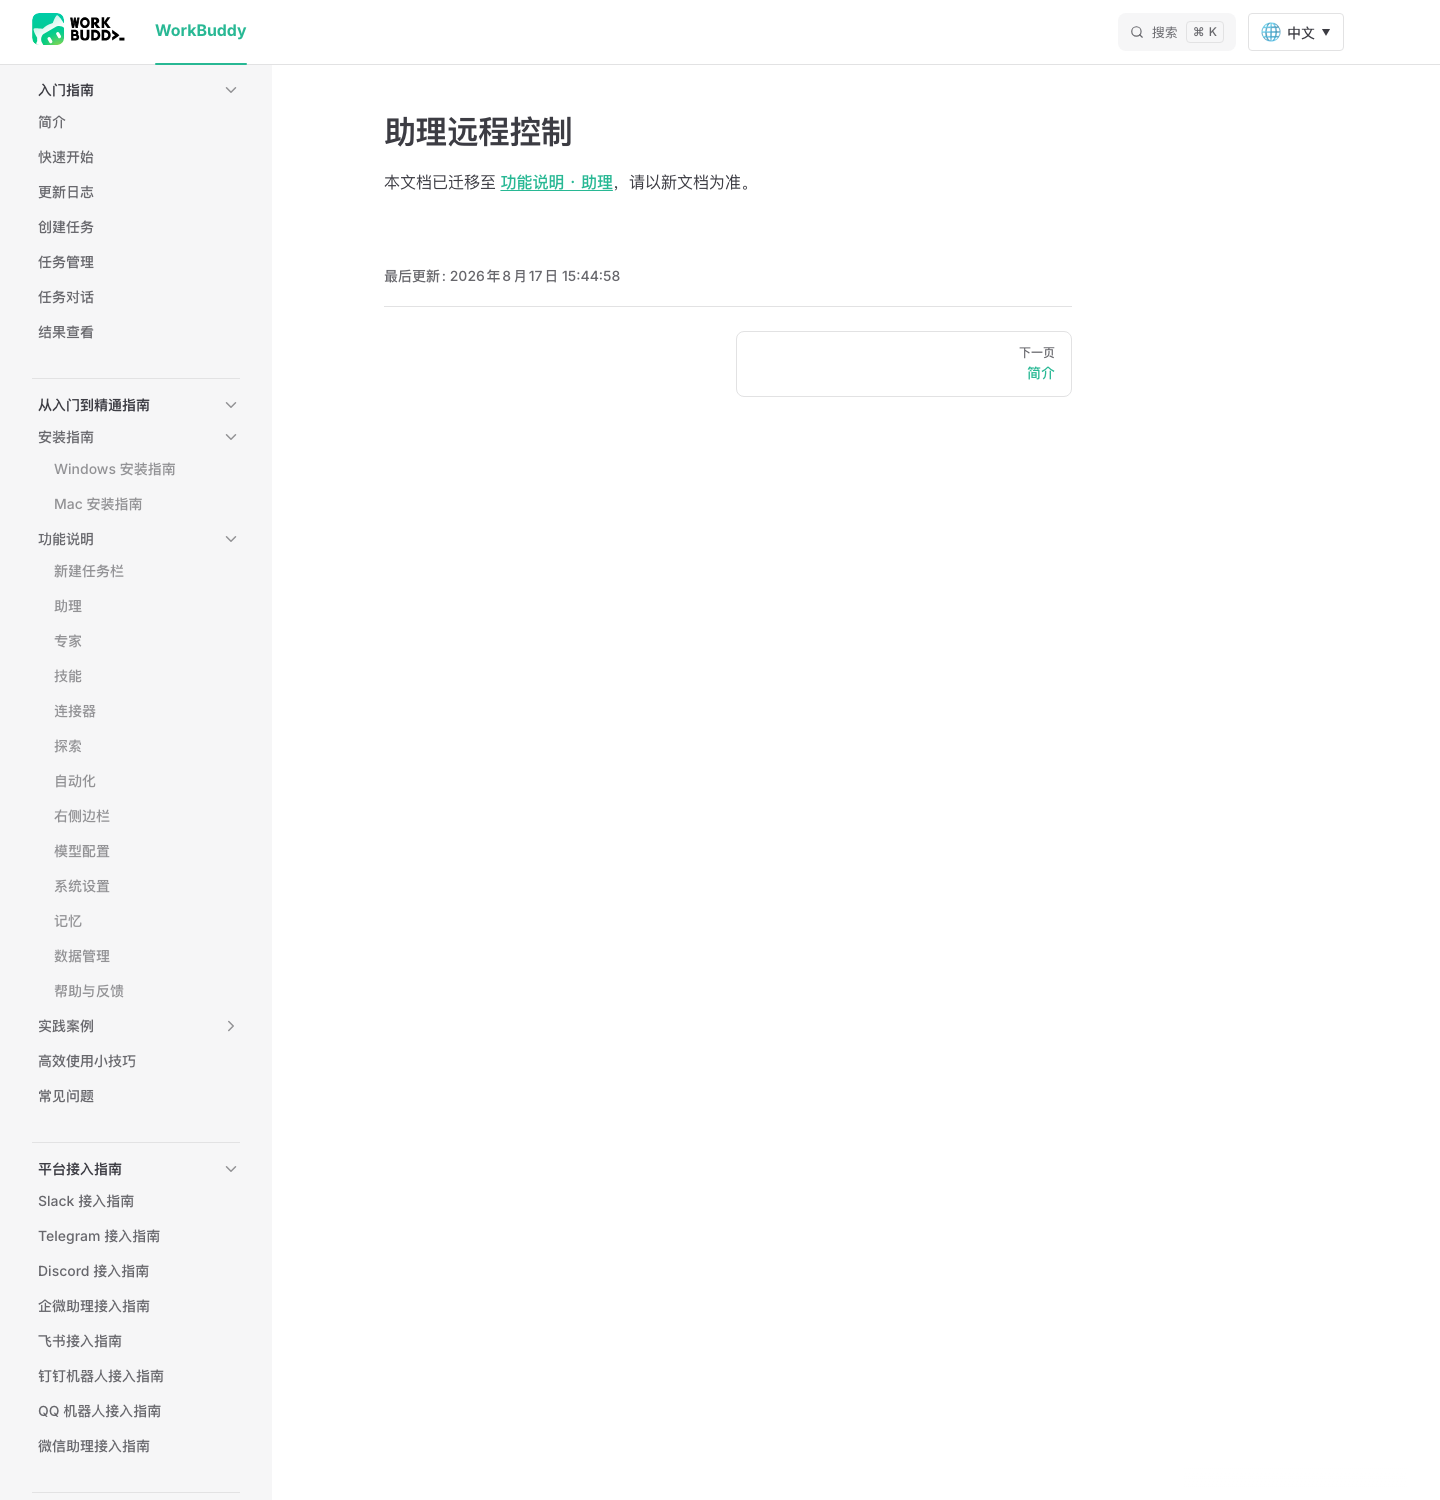
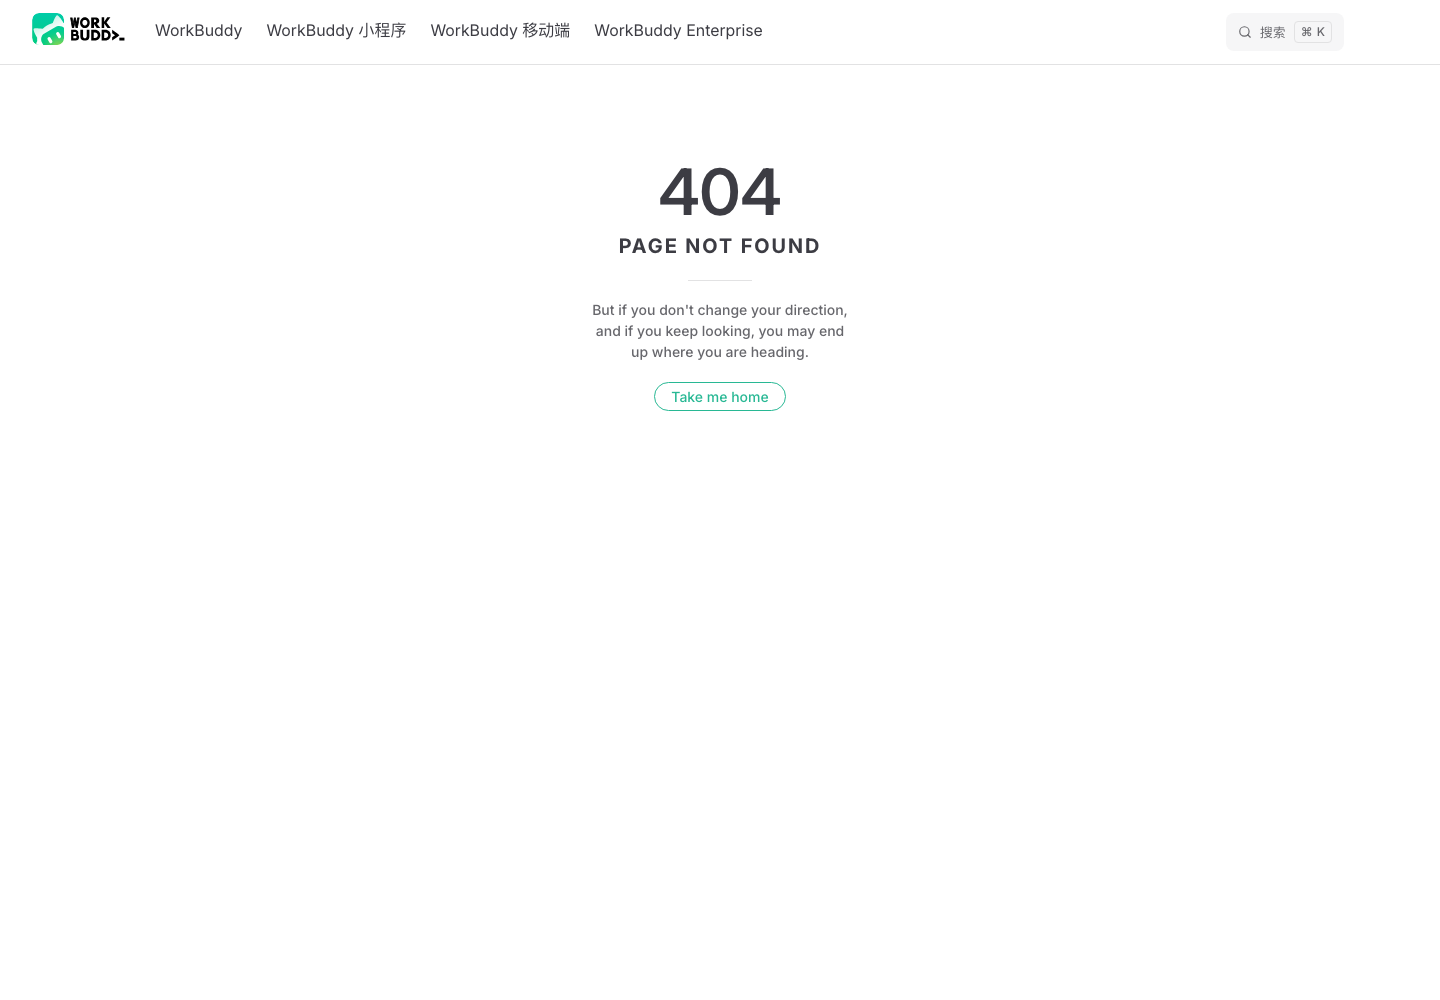
下图是同一个路径 /docs/zh/workbuddy/Claw(”助理远程控制”)在两个域名的真实渲染结果:海外站(左)正文完整,国内站(右)只有一张 404 页面。而这两个 URL 的 GET 状态码都是 200。
五、我在这个过程中写错过一次,以及怎么抓出来的
这是这篇文章里我自认为最值得记录的一段。
抽样脚本第一版把 24 条全部判为”渲染成功”,其中包括 .ai/docs/workbuddymini/features/Settings——但这个 URL 在前面的 domcheck.py 里明确是 “PAGE NOT FOUND”。同一 URL,两次运行结论相反。
我没有取多数票,而是去查判据本身,查出是第一版脚本的分类逻辑有 bug:它把渲染后的整页文本取前 400 字符再找 “PAGE NOT FOUND”,但 VitePress 的导航侧边栏先于正文进入这 400 字符,404 提示反而落在切片之外,于是全部误判为”成功”。判据错了,不是站点在抖动。 改用 h1 作为唯一权威信号后,24 条样本立刻收敛到 5 成功 / 19 失败。
我随后做了两件事防止同类错误:
- 对 7 条争议 URL 各重复渲染 4 次(
repeatability.json),确认 4/4 一致,站点确定性成立。 - 换一个正交判据复核——直接比对响应体 md5,见下一节。
这两步都不是冗余。第一步证明”不是随机”,第二步证明”判据本身可信”。
六、最隐蔽的一种失败:状态 200、内容错误、响应体和别的页面一模一样
改用正确判据后,抽样里剩下 5 条”渲染成功”的企业版路径。我本来准备写”企业版文档在海外站也能访问,这是 sitemap 漏报”——这个结论也是错的,是字节级比对抓出来的。
# .ai 上三个不同企业版路径的响应体 md5
f549b9e3af18d21724c88beb6826374a  /docs/enterprise/
f549b9e3af18d21724c88beb6826374a  /docs/enterprise/adminguide/基础设置
f549b9e3af18d21724c88beb6826374a  /docs/enterprise/adminguide/积数量

# .cn 上同样三个路径的响应体 md5
ec4783d33ff6483e584980f177ab0ff9  /docs/enterprise/
c272bfd43ac59c47e241dfa979b99c3e  /docs/enterprise/adminguide/基础设置
af48e6b8b168a39048652105cfbc95b1  /docs/enterprise/adminguide/积数量
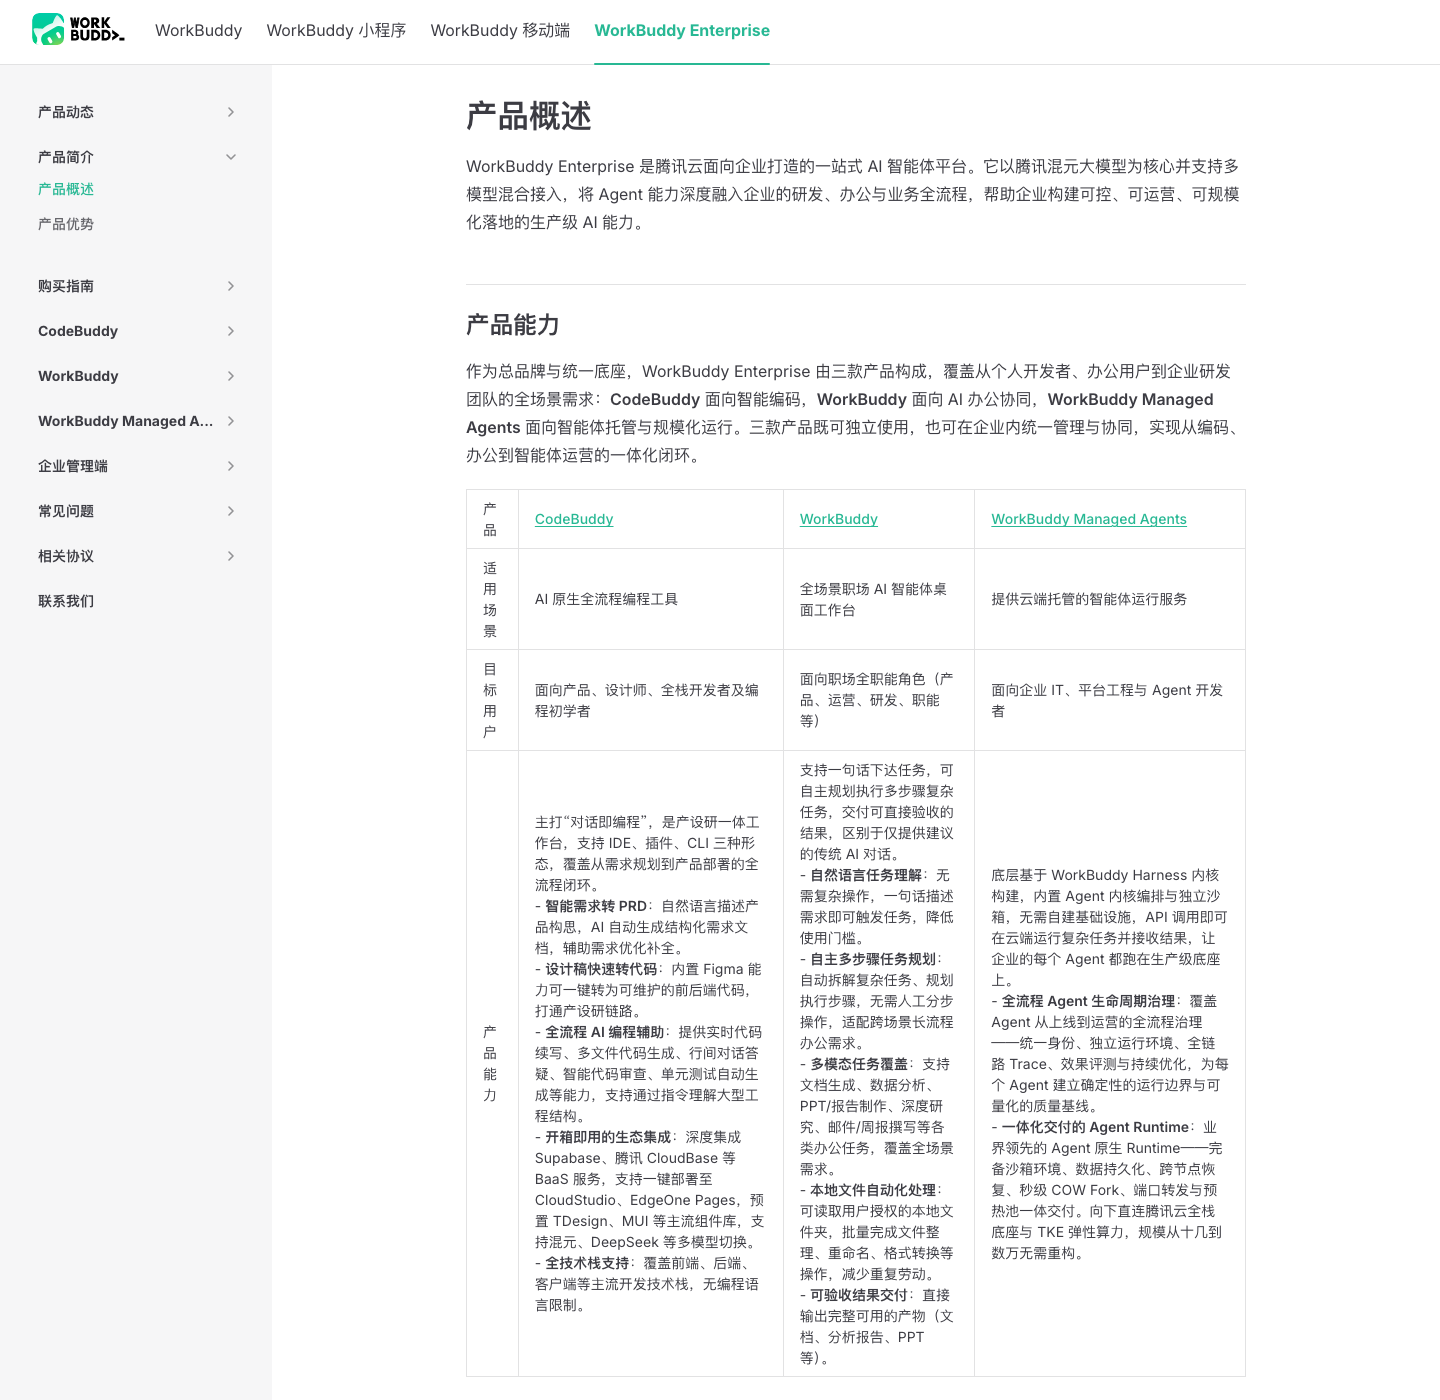
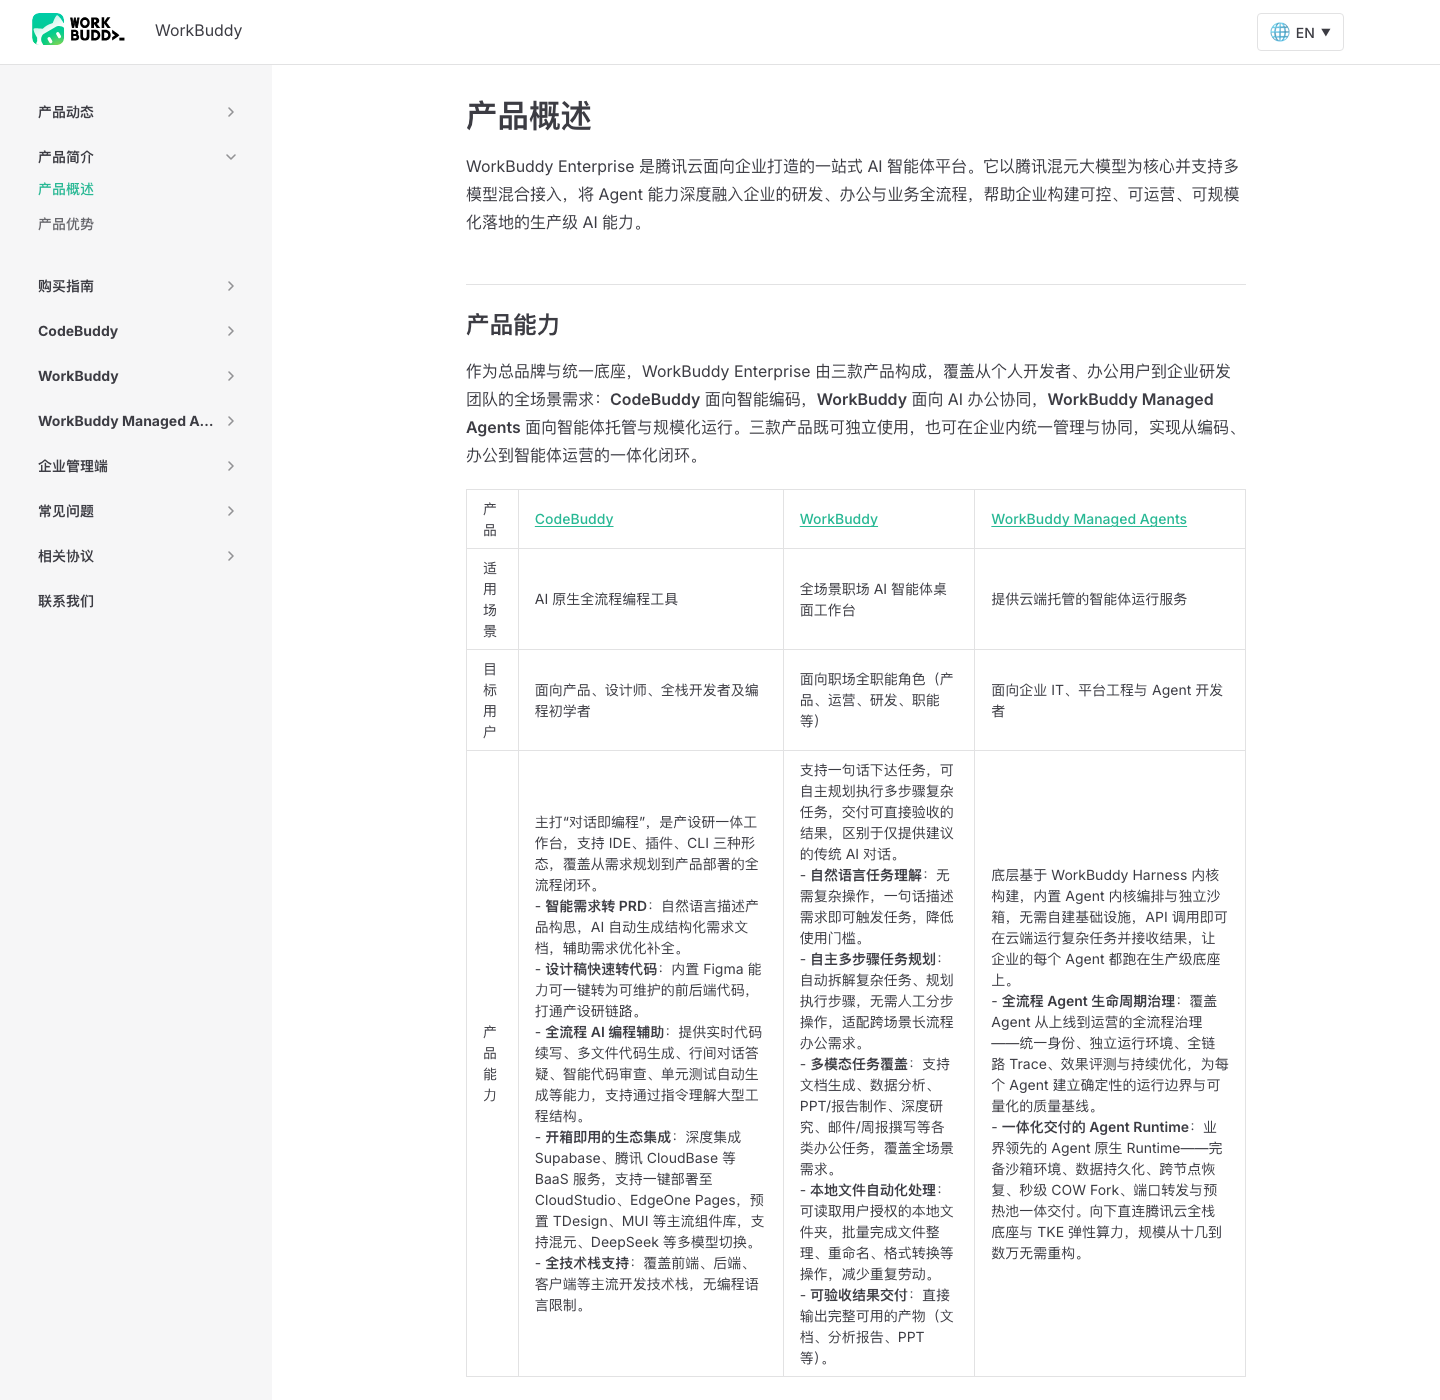
.ai 上三个语义完全不同的页面返回字节级完全相同的响应体,.cn 上三个各不相同。渲染后看,这 4 条在 .ai 上的 h1 都是”产品概述”、正文长度都是 2,181 字符——这不是三篇不同的文档,是同一个”产品概述”页被重复返回给了所有企业版路径。
也就是说,一个只看状态码(200)、不看正文一致性的爬虫,会把 .ai/docs/enterprise/adminguide/基础设置 当成一篇”基础设置”的真实文档收进去,而它实际渲染出来的是”产品概述”。这类假阳性比 404 危险得多:404 至少会暴露,假内容会一路混进知识库和引用链路。
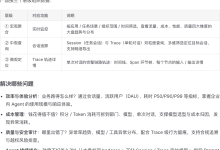
下面两张图是同一个 URL /docs/enterprise/adminguide/基础设置 在两个域名的渲染结果。请注意它们的正文完全一样——左图是国内站,右图是海外站。海外站那一页的正文其实是”产品概述”,它根本没讲”基础设置”。
再验证 Account-Cancellation 这类非企业版路径:.cn 渲染出”账号注销”、正文 3,871 字符;.ai 渲染出 “PAGE NOT FOUND”。同一路径在两站,一站有内容一站没有,而两站 GET 都是 200。
七、更新日志的版本断层:5.8.4 只在海外站
| .cn 更新日志 | .ai 更新日志 | |
|---|---|---|
| 版本分段数(h2) | 100 | 6 |
| 最新版本 | 5.8.2(2026-10-16) | 5.8.4 |
| 最旧版本 | 4.5.0 | 5.2.3 |
| 正文总字数 | 40,369 | 约 1,367 |
| 平均每段字数 | 403.7 | 227.8 |
国内站是一份完整历史档案(100 段、4 万字);海外站只有 6 段。5.8.4 在国内站完全找不到——/docs/workbuddy/Changelog-5.8.4 在两边都渲染 404,而 Changelog-5.8.2 在国内站正常打开,说明国内站停在 5.8.2。
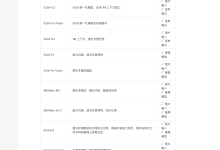
下图是海外站更新日志的顶部,右侧”快速导航”清楚列出这个站点只有 6 个版本:5.8.4、5.7.6、5.6.2、5.5.0、5.2.7、5.2.3。
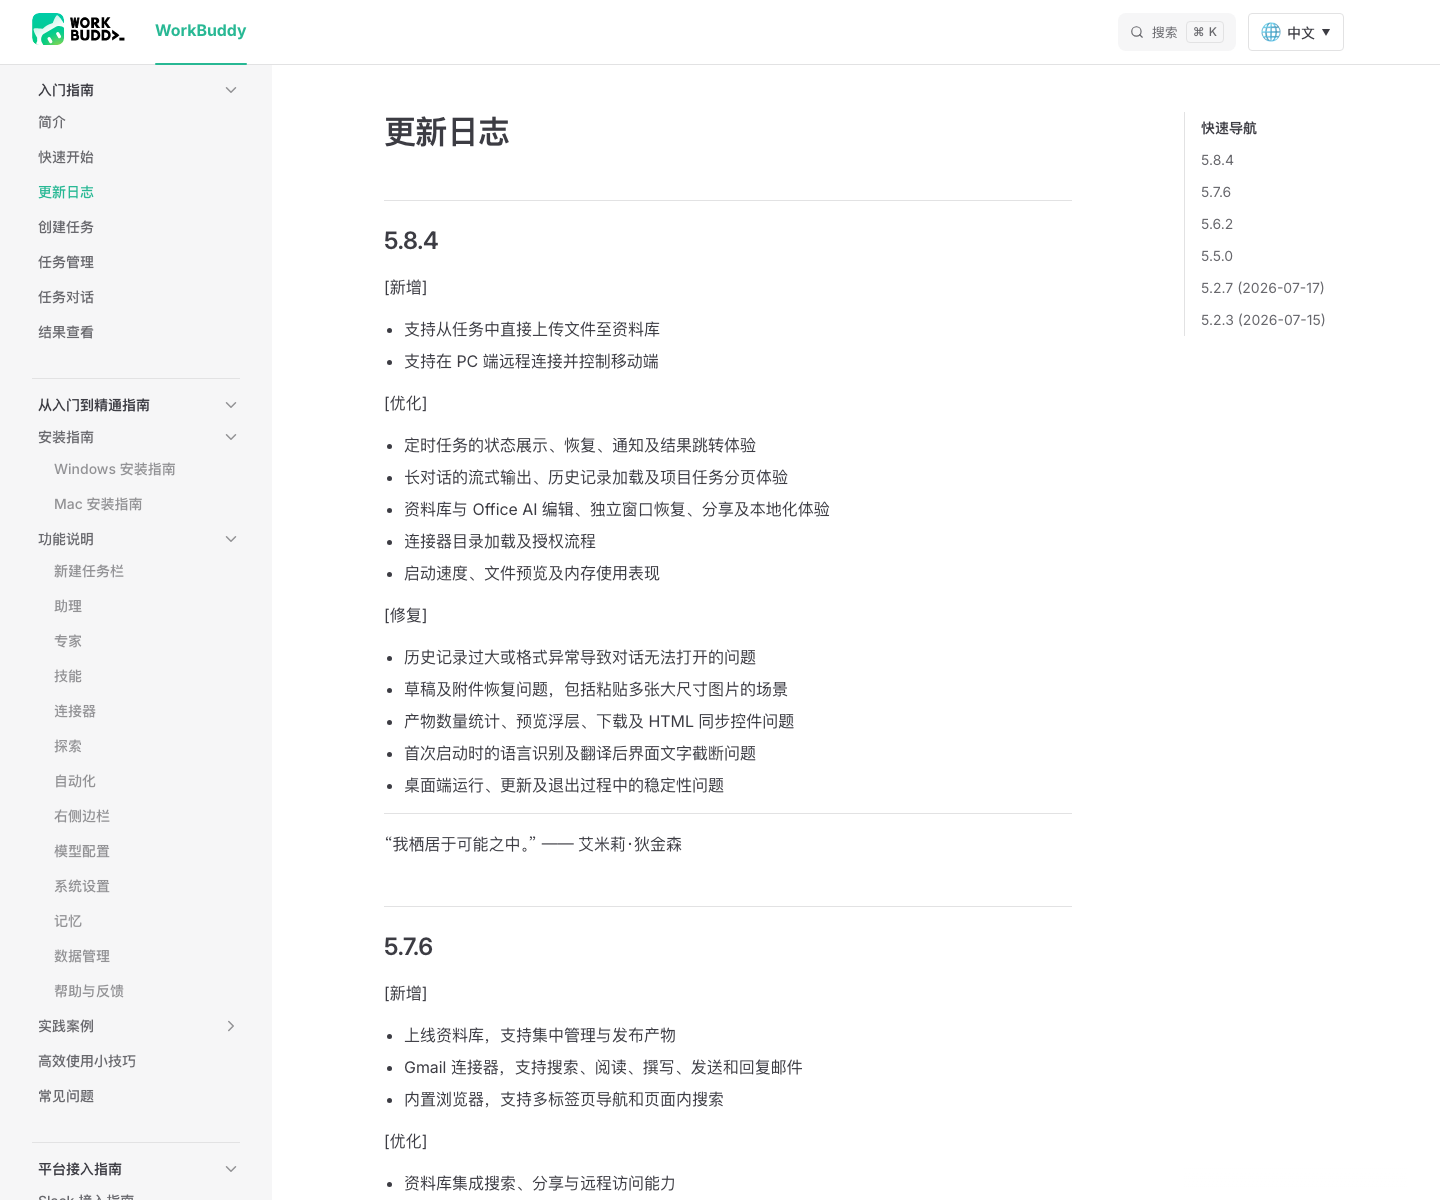
5.8.4 的内容是”支持从任务中直接上传文件至资料库””支持在 PC 端远程连接并控制移动端”。后一条正是 .ai/docs/zh/workbuddy/Claw(标题”助理远程控制”)的主题——海外站能查到 5.8.4 的更新说明却打不开解释它的文档页;国内站保留了功能文档页 .cn/docs/workbuddy/Claw(”助理(远程任务)”)却没有这次更新。 两个方向各缺一半。
另外国内站有 27 条独立的 Changelog-5.x.x 分页(每版本一页),海外站一条都没有。
八、如果你要引用 WorkBuddy 文档,请照这张表选站
| 你要做的事 | 该用哪个域名 | 依据 |
|---|---|---|
| 引用企业版能力(27 页) | .cn | .ai 无 enterprise 构建,且返回重复正文 |
| 引用移动端 / 小程序(33 页) | .cn | .ai 抽样 8/8 渲染 404 |
| 查历史版本更新说明 | .cn | 100 段 vs 6 段 |
| 查 5.8.4 最新更新 | .ai | .cn 停在 5.8.2 |
| 引用中文功能文档(53 页) | .ai | .cn 抽样 4/4 渲染 404 |
| 任何自动化死链巡检 | 不要用 HEAD | 288/288 假阳性 |
九、给做站点巡检和引用建设的人:四条可直接落地的口径
- JS 渲染站点,状态码不承载存在性信息。 判定页面存在请读渲染后的
h1或正文长度;纯curl只会拿到空壳。 - 不要用 HEAD 做存在性探针。 在 APISIX + VitePress 这类组合上,HEAD 与 GET 状态码会系统性不一致,且 HEAD 的 404 往往是假的。288/288 就是直接反例。
- 校验”页面是否对题”,而不只是”能否打开”。 比对同一域名下多个路径的响应体 md5,能一次性抓出”状态 200 但返回了别的页面”这类故障,成本极低。
- sitemap 不等于页面清单。 跨站抽样里 79.2% 打不开;同时企业版路径虽不在
.aisitemap 里却能返回 200(只是内容是错的)。sitemap 只能当候选来源,不能当事实依据。
十、证据口径说明
本文区分三类信息:
- 官方明示:sitemap 的
Crawl-delay、页面 HTML 里的build-info构建信息与构建产物路径键,均直接来自官方响应。 - 本文加工:交集/并集/独有数量、更新日志分段字数统计、跨站抽样的 79.2%、”PAGE NOT FOUND” 判定阈值,均为我在本地脚本中的统计口径,方法已在正文写明。
- UNKNOWN:
– 为什么 .ai 上所有企业版路径都返回同一份”产品概述”,而 .cn 上路径之间内容各不相同——可观察到”内容重复”这一现象,但构建产物裁剪的具体原因未确认。 – 国内站 100 个版本段落中有 1 段正文仅 45 字(疑为占位),是否为有意保留未确认。 – 两个域名 sitemap 的 lastmod 全部等于生成日期(2026-10-16),无法据此判断单页真实更新时间;唯一可用的时间信号是更新日志标题里的版本发布日期。
十一、测试方法与来源
全部数据来自 2026 年 10 月 16 日 18:00–18:40(Asia/Shanghai)实测。探测频率控制在每秒约 1 次以内,遵守两站 robots.txt 中 Crawl-delay: 1 的声明。
| 来源 | 用途 |
|---|---|
| workbuddy.cn/docs/sitemap.xml | 国内站文档 sitemap 索引(5 个叶子) |
| workbuddy.ai/docs/sitemap.xml | 海外站文档 sitemap 索引(4 个叶子) |
| workbuddy.cn/robots.txt | 抓取策略与 Crawl-delay 声明 |
| workbuddy.ai/robots.txt | 海外站抓取策略(含 2026-09-10 新增的 5 条屏蔽规则) |
| workbuddy.cn/docs/workbuddy/Changelog | 国内站 100 段更新日志 |
| workbuddy.ai/docs/zh/workbuddy/Changelog | 海外站 6 段更新日志 |
探测脚本 6 份,存于 timew 工作区 .openclaw/tmp/wb1800-2026-10-16/:sweep.py(全量交叉扫描 550 请求)、domcheck.py(DOM 真伪判定)、render-check.py(渲染指纹)、verbmatrix.py(GET/HEAD 矩阵 576 请求)、domspot.py(跨站分层抽样)、repeat.py(可重复性验证 28 次渲染)。
每条结论都可用上表 URL 复现。所有状态码结论请用 GET 复核,不要用 HEAD。