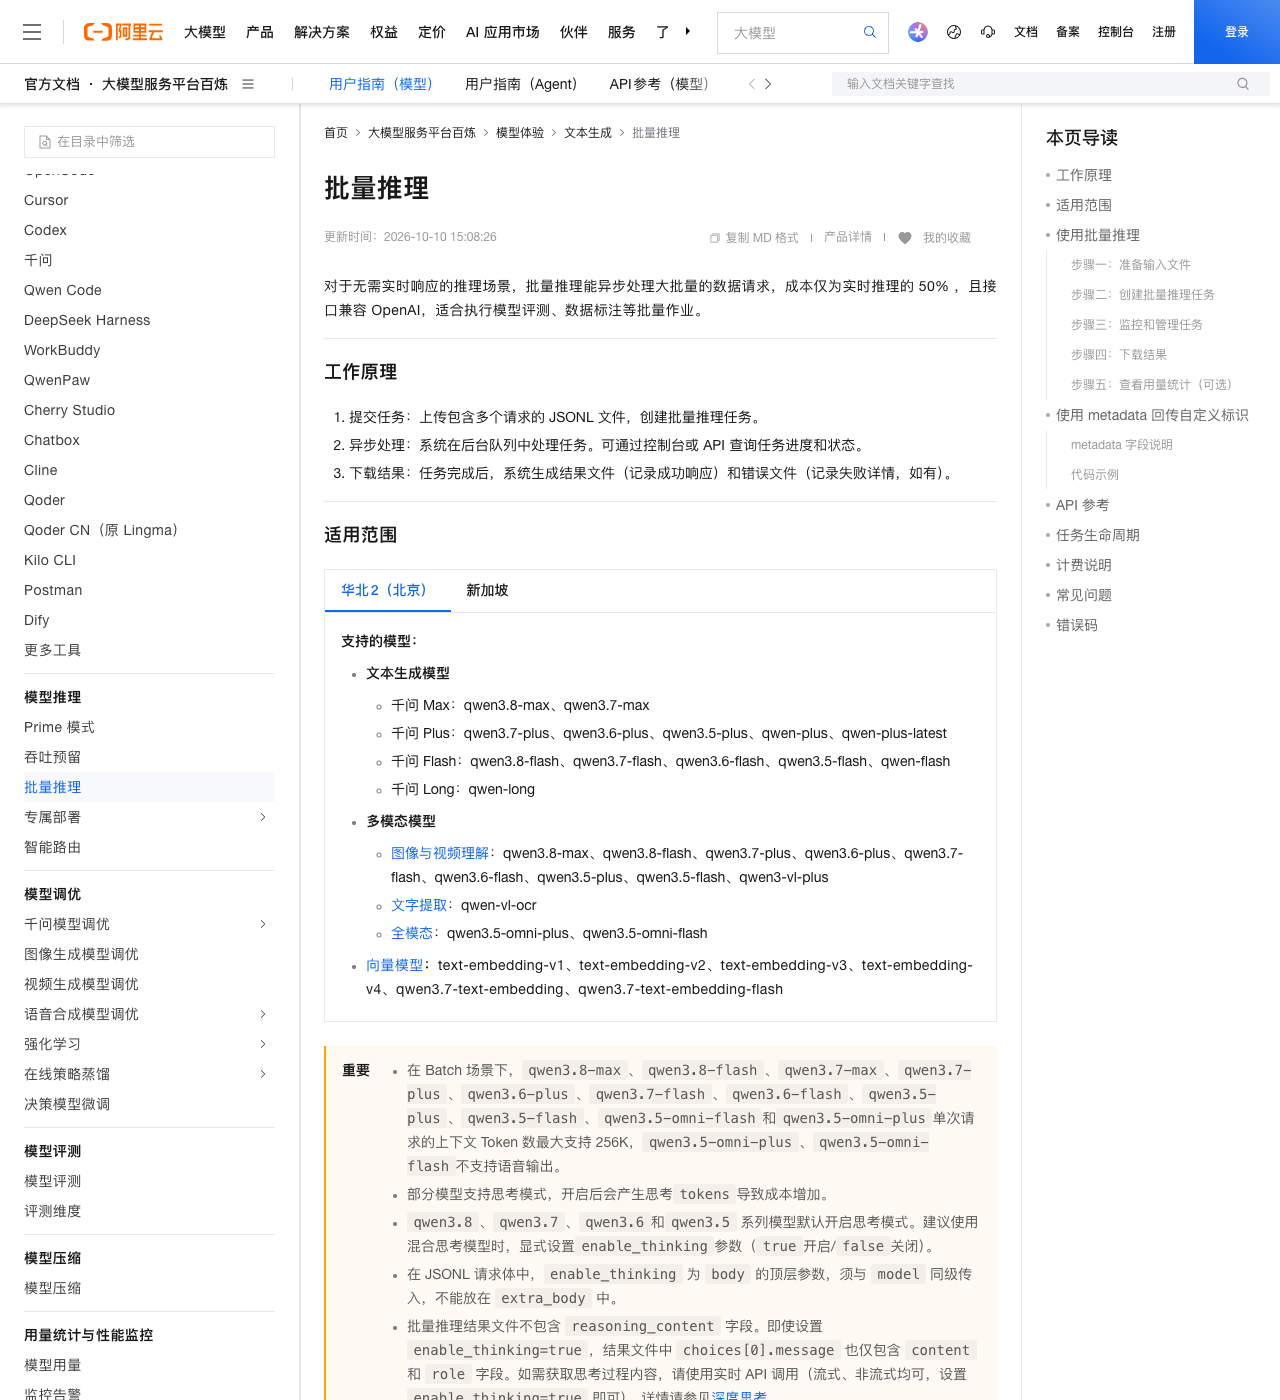
批量推理(Batch Inference)是百炼最容易被误解的一个功能。文档首页写着「成本仅为实时推理的 50%」,这句话本身没错,但它掩盖了三个更值得工程团队注意的事实:这套半价并不是无条件的、支持半价的模型名单只有 18 个,而且控制台文档和 API 文档在同一个限制项上给出了相差 6 倍的数值。
本文的全部结论来自 2026-10-18 12:00 对三份官方页面的一次性抓取与脚本交叉核对:批量推理(控制台指南)、OpenAI兼容-Batch(文件输入)、模型调用计费。三页的更新时间分别是 2026-10-10 15:08:26、2026-10-10 15:08:26、2026-10-13 15:44:40——前两页是同一次提交产出的孪生页面,这解释了后面多处不一致的成因。
一、50% 半价的真实规则:三条例外
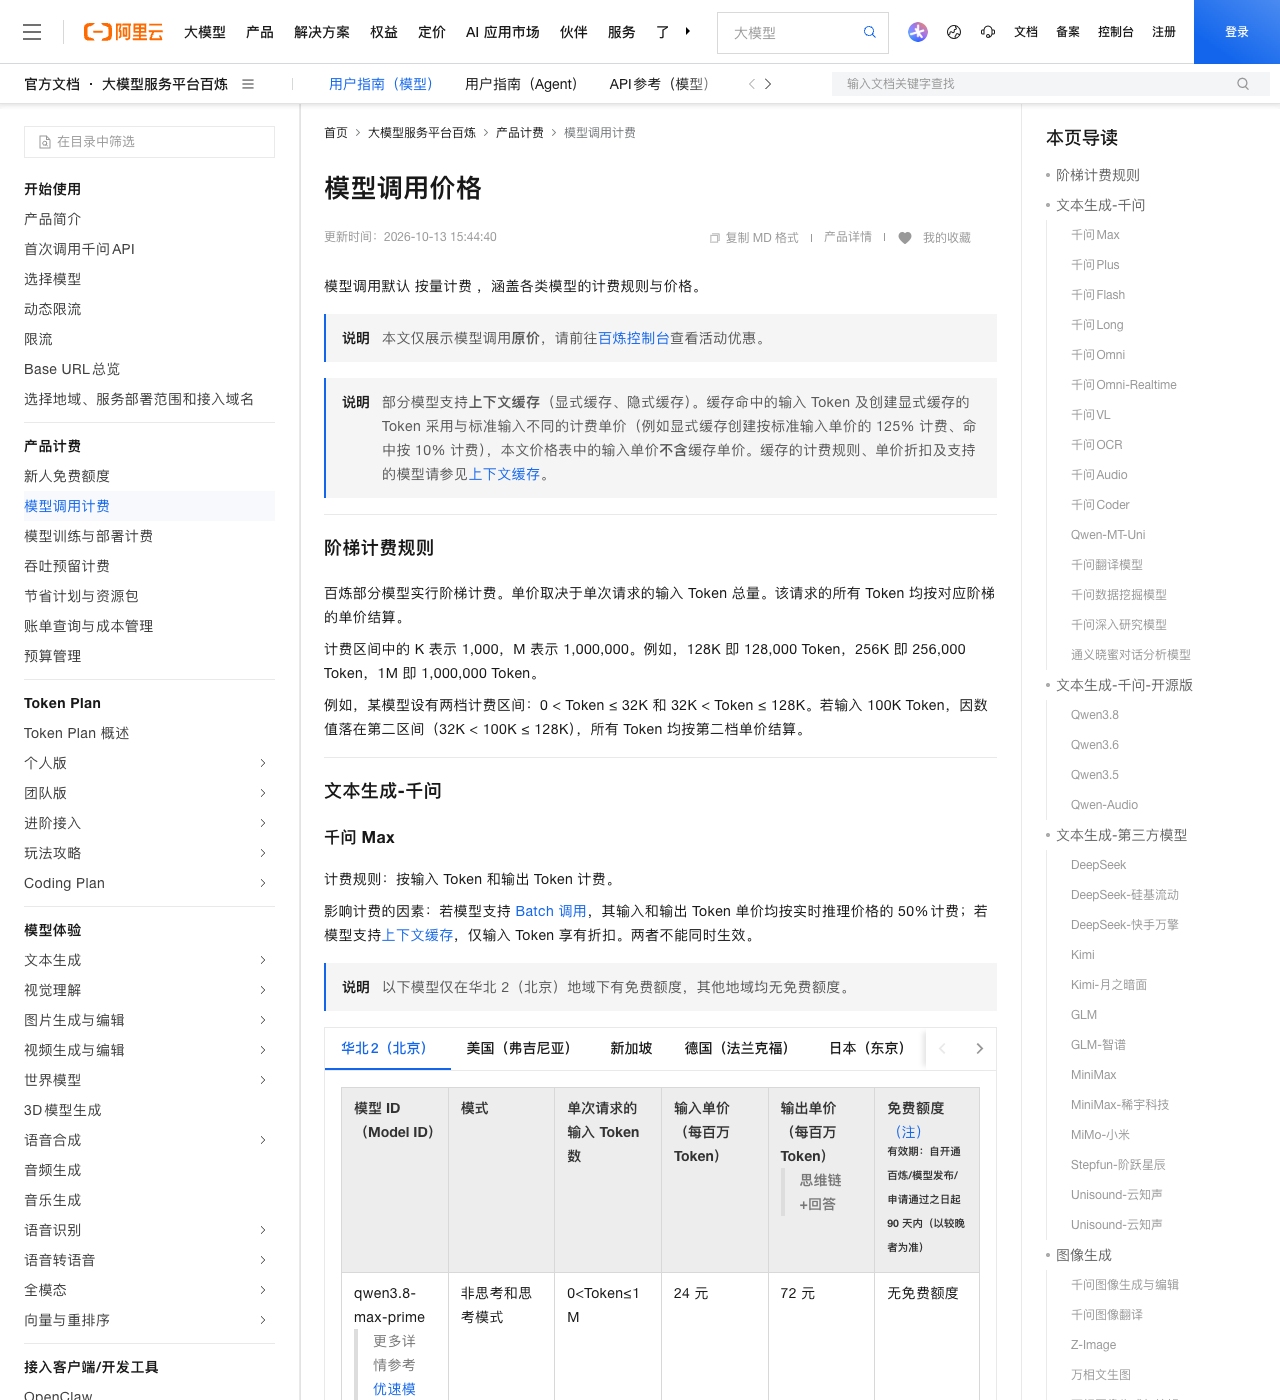
先说清楚这 50% 到底怎么算。定价页对每个模型标注了「Batch 调用 半价」,控制台文档的计费说明给出了完整口径:
- 计费单价:所有成功请求的输入和输出 Token,单价均为对应模型实时推理价格的 50%。
- 计费范围:仅对成功执行的请求计费;文件解析失败、任务失败、行级错误请求均不产生费用;被取消的任务在取消前已成功完成的请求仍正常计费。
- 不支持叠加:批量推理为独立计费项,支持 AI 通用型节省计划,但不支持预付费(节省计划)、新人免费额度等优惠,也不支持上下文缓存。
最后一条是本文最容易被忽略、也最影响成本的一条。定价页对同一批模型同时标注了「Batch 调用 半价」和「上下文缓存 享有折扣」,并且明确写着「两者不能同时生效」。也就是说,一份超长前缀、重复请求上千次的批量作业,用 Batch 省 50%,就不能再吃缓存的输入折扣;反过来用缓存,就拿不到 Batch 的 50%。这两个折扣不是叠加的,是二选一的。
第三条例外是思考 Token。控制台文档写明「部分模型支持思考模式,开启后会产生思考 tokens 导致成本增加」,且思考 token 按输出 Token 价格计费。这一条的实际杀伤力我们用真实单价算了一遍(qwen3.8-max 北京地域,输入 12 元/百万、输出 36 元/百万,1000 个请求、每请求 2000 输入 + 1000 输出 token):
| 模式 | 该批次成本 | 相对实时 |
|---|---|---|
| 实时推理,不开思考 | 60.0 元 | 基准 |
| Batch,不开思考 | 30.0 元 | 省 50% |
| Batch,每请求 +1000 思考 token | 48.0 元 | 只省 20% |
思考模式会把 Batch 的折扣从 50% 吃掉 30 个百分点。 文档特别提示 qwen3.8、qwen3.7、qwen3.6 和 qwen3.5 系列模型默认开启思考模式——也就是说,2026 年的主力模型在 Batch 场景下默认就在付这笔钱。而 qwen3.8 系列默认开启思考模式的同时,其思考 token 并不会出现在结果文件里(见第三节)。
二、支持半价的只有 18 个模型,另外 6 个只在文档里出现
这是本次核对最实的一个发现。我们解析定价页(北京地域)表格中全部 1509 行,抽出 127 个模型行,逐行判定是否带「Batch 调用 半价」标记:
| 来源 | 模型数 | 具体名单 |
|---|---|---|
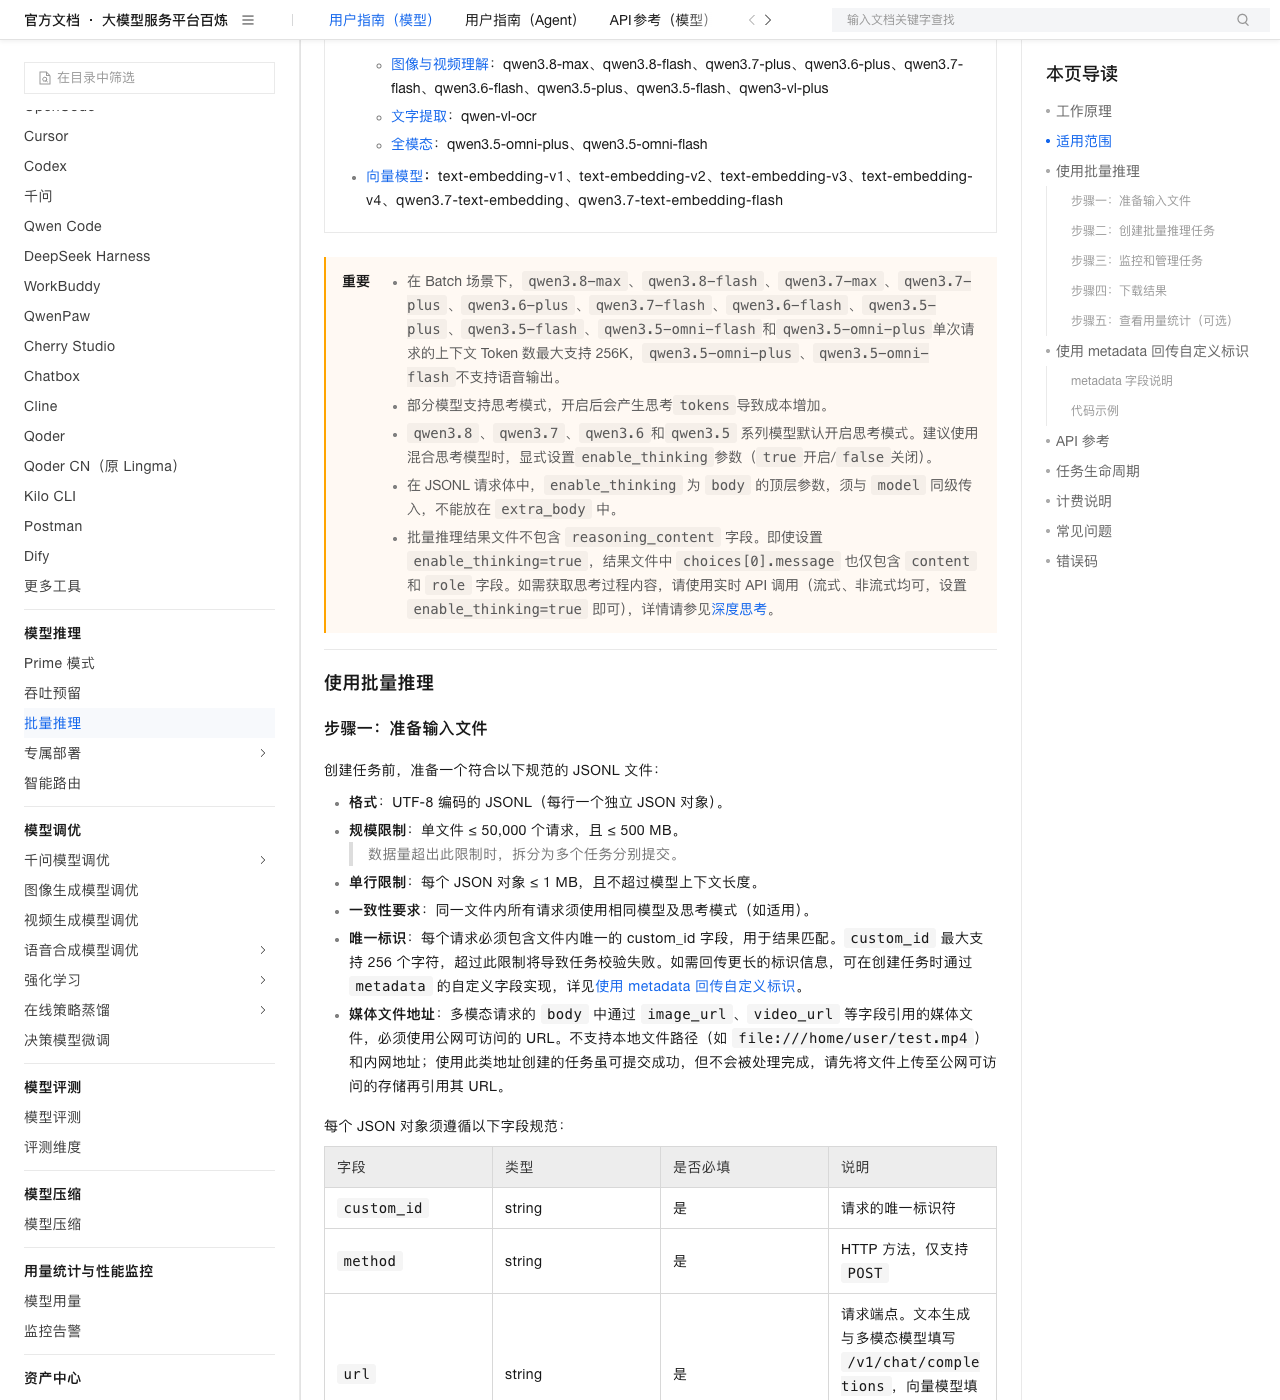
| 定价表标注 Batch 半价 | 18 | qwen3.8-max / qwen3.7-max / qwen3.7-plus / qwen3.7-flash / qwen3.6-flash / qwen3.5-flash / qwen-flash / qwen-long / qwen-plus / qwen-plus-latest / qwen3-vl-plus / qwen-vl-ocr / qwen3.7-text-embedding / qwen3.7-text-embedding-flash / text-embedding-v1 / v2 / v3 / v4 |
| 两份文档「适用范围」列出、但定价表无半价标记 | 6 | qwen3.8-flash / qwen3.6-plus / qwen3.5-plus / qwen3.5-omni-plus / qwen3.5-omni-flash / qwen-omni |
这 6 个模型的定价表北京地域行仍然存在,价格也读得到(qwen3.8-flash 0.8 元 / 2.7 元,qwen3.6-plus 2 元 / 12 元,qwen3.5-plus 0.8 元 / 4.8 元,qwen3.5-omni-plus 7 元 / 53 元,qwen3.5-omni-flash 2.2 元 / 18 元),但模型 ID 旁边的标记里没有「Batch 调用」——qwen3.8-flash 和 qwen3.5-flash 那一格只写了「上下文缓存 享有折扣」,而 qwen3.6-plus、qwen3.5-plus、qwen3.5-omni-plus、qwen3.5-omni-flash 连缓存标记都没有。
两份文档的「适用范围」都把这些模型列为支持,而定价表没有给出半价承诺。 文档和价格表在这里对不上,定价表更新时间是 10-13,比两份文档的 10-10 晚三天,所以更可能是定价表把这些模型的 Batch 支持收窄了而文档没跟上,而不是文档写错了。这一点我们没有实测调用验证,记为 UNKNOWN;但工程上应该按「没有折扣」来做成本预估,否则账单会超出预期。
反向检查则是干净的:定价表标注半价的 18 个模型,两份文档的适用范围里全部都能找到,没有「文档没写却能打折」的幽灵条目。
另一个容易漏掉的点是地域。两份文档的适用范围都只列了「华北2(北京)」和「新加坡」两个地域,而定价表的模型表有华北2(北京)、美国(弗吉尼亚)、新加坡、德国(法兰克福)、日本(东京)五列。美国、日本、弗吉尼亚的 qwen3.7-plus 行价格明显不同(2.998 元 / 11.991 元,而北京是 2 元 / 8 元),但这三个地域并不在 Batch 的支持范围内。API 文档也只给出两个接入域名:
- 华北2(北京):
https://dashscope.aliyuncs.com/compatible-mode/v1 - 新加坡:
https://dashscope-intl.aliyuncs.com/compatible-mode/v1
三、思考模式的三个陷阱
批量推理和思考模型的组合有三条独立的限制,其中两条会造成「看起来成功了但结果不对」。
第一,结果文件里没有 reasoning_content。 文档原文:「批量推理结果文件不包含 reasoning_content 字段。即使设置 enable_thinking=true,结果文件中 choices[0].message 也仅包含 content 和 role 字段。」想拿思考过程只能走实时 API。对评测场景来说这意味着——你无法用 Batch 跑出来的结果来分析模型的推理质量,只能拿到最终答案。
第二,enable_thinking 的位置写得很死。 文档强调它必须是 body 的顶层参数,与 model 同级,不能放进 extra_body。理由文档也给了:extra_body 是 OpenAI Python SDK 用于透传非标准参数的机制,仅在实时推理的 SDK 调用中有效,在批量推理的 JSONL 文件中不适用。
这里其实还有一个更深的坑,和上一节的成本问题同源:官方给的 JSONL 生成脚本里,写死了 body["stream"] = True,注释是「思考模式需开启 stream」。也就是说官方脚本认为思考模式必须配流式,而实时推理的批量子集在 Batch 结果里根本没有流式输出。如果你需要模型的 reasoning_content,就必须回到实时 API——那也就同时失去了 Batch 的 50%。
第三,思考模式在 Batch 里单请求上下文上限是 256K。 文档列出了这 11 个模型的 256K 上限,其中 qwen3.5-omni-flash 和 qwen3.5-omni-plus 还不支持语音输出。
四、同页两套限制:单行 1 MB 还是 6 MB?
这是本文标题里的问题,
答案取决于你看哪一页。
| 项目 | 控制台文档(batch-inference) | API 文档(batch-interfaces-compatible-with-openai) |
|---|---|---|
| 单个 JSON 对象大小 | ≤ 1 MB | ≤ 6 MB |
| 单文件请求数 | ≤ 50,000 | ≤ 50,000(一致) |
| 单文件总大小 | ≤ 500 MB | ≤ 500 MB(一致) |
custom_id 长度上限 |
256 字符 | 未在该节重申 |
| 多模态模型清单 | 13 个(含 qwen3.5-omni-flash) |
12 个(不含 qwen3.5-omni-flash) |
| 256K 上下文模型清单 | 11 个(含 qwen3.5-omni-flash) |
10 个(不含该模型) |
| 最长等待时间 | 1–14 天 | completion_window="24h"(未给取值范围) |
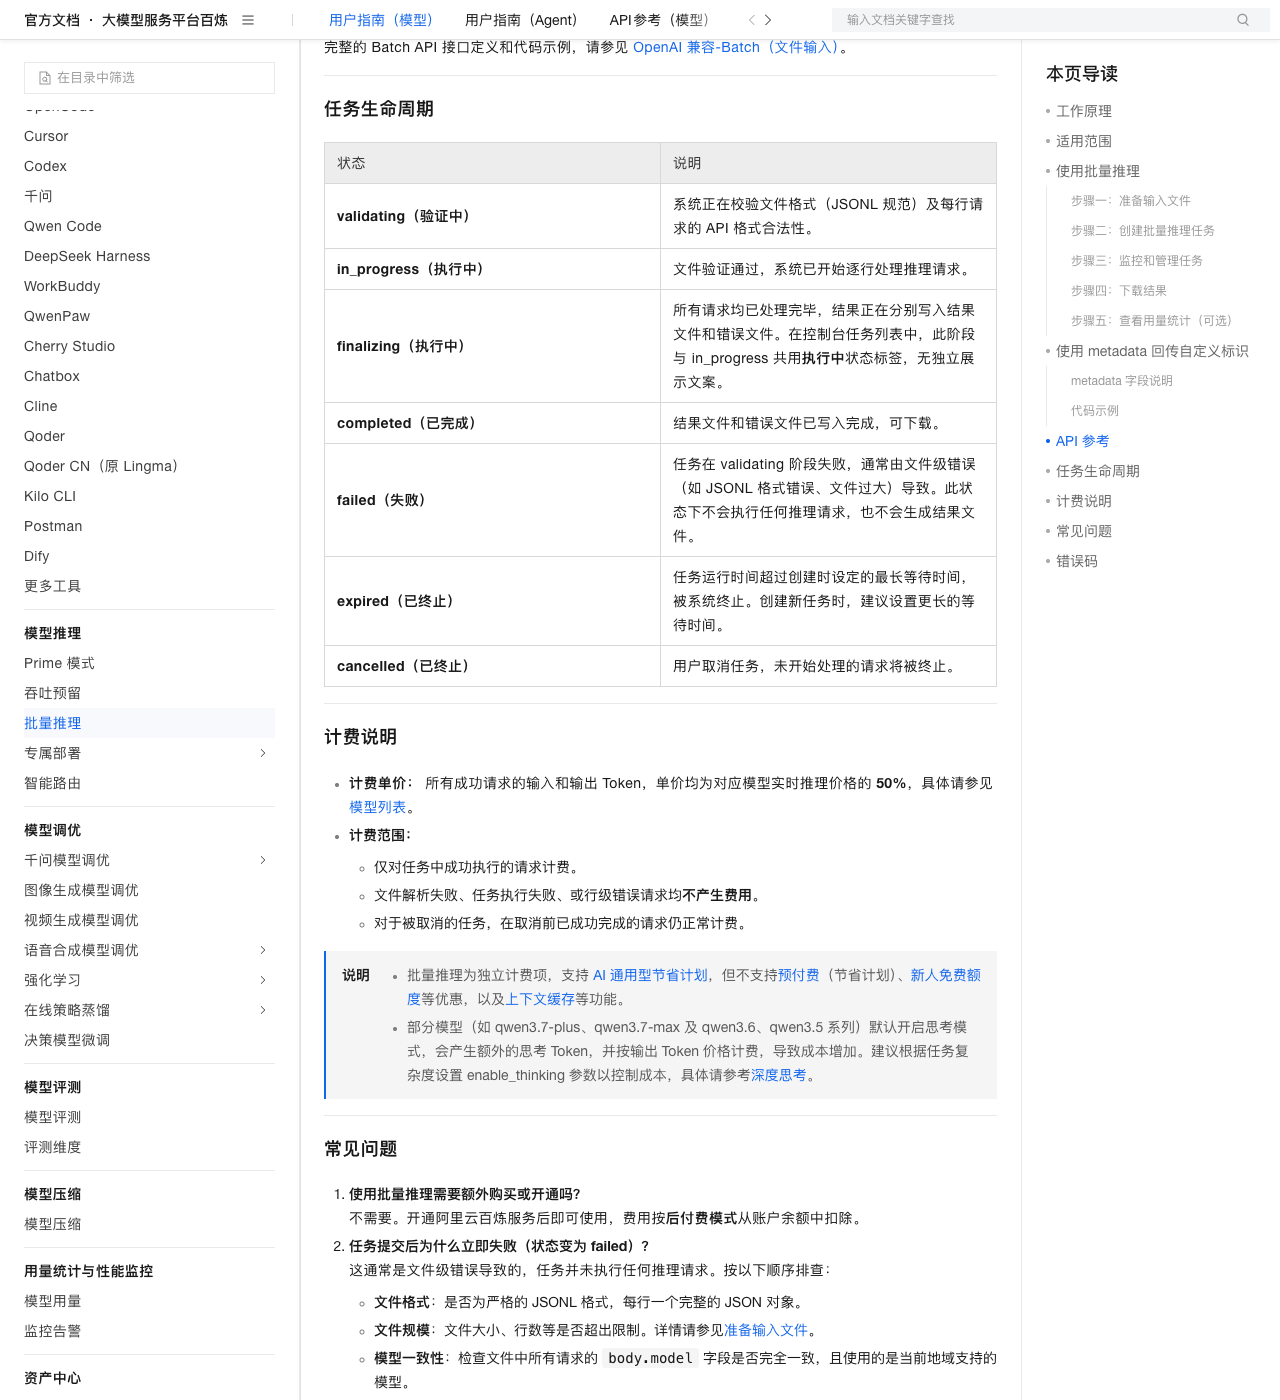
单行限制一个写 1 MB、一个写 6 MB,相差 6 倍,而这两页的更新时间是同一秒(2026-10-10 15:08:26)。 更能说明问题的是:两页的官方 JSONL 生成脚本里,docstring 写的都是「文件大小限制:单行 ≤6MB,总文件 ≤500MB,建议 ≤10000 行」——控制台文档的正文说 1 MB,同一页的代码注释说 6 MB,自己跟自己矛盾。
这个矛盾的工程后果很具体:如果多模态请求体里塞了 Base64 图片或视频,单行很容易超过 1 MB。按控制台文档的 1 MB 你会主动分批、控制体积;按 API 文档的 6 MB 你可能一次提交,然后任务提交成功、逐行执行、单行报错、最后拿到一堆行级错误。两种做法都不致命,但成本估算和重试逻辑会完全不同。我们没有实测哪个值是服务端真正执行的,记为 UNKNOWN,建议按 1 MB 这个更严的值设计。
五、四处会静默失败的地方
除了上面的矛盾,文档里还埋了几条「不报错但结果不对」的规则,都是逐字读出来的。
1. 媒体地址必须是公网 URL,否则任务提交成功但永不完成。 文档原文:「多模态请求的 body 中通过 image_url、video_url 等字段引用的媒体文件,必须使用公网可访问的 URL。不支持本地文件路径(如 file:///home/user/test.mp4)和内网地址;使用此类地址创建的任务虽可提交成功,但不会被处理完成。」这是全文最危险的一句——任务在控制台上是 in_progress,不会有失败提示。
2. qwen-max 在同一页里既不在清单、又被单独点名。 两份文档的「适用范围」都按 Max / Plus / Flash / Long 四档列出文本生成模型,这四档里没有 qwen-max(Max 档写的是 qwen3.8-max、qwen3.7-max)。但紧接着向量模型段落之后,又孤零零起了一行:「支持的模型:qwen3.7-plus、qwen-max、qwen-plus。」这一行既不属于任何分类,也和上面的清单冲突。而定价页上 qwen-max(2.4 元 / 9.6 元)那行的标记里没有「Batch 调用 半价」——和第 2 节那 6 个模型一样。
3. 一个文件只能有一个模型,且思考模式也要一致。 混用模型的报错是文件级的,任务直接 failed,所有请求都不执行:「The model ‘qwen-plus’ for this request does not match the rest of the batch. Each batch must contain requests for a single model.」
4. 结果只保留 30 天,且用量按任务结束时间统计。 「任务结束超过 30 天将自动删除,请及时下载结果。」同时「批量推理的调用数据以任务结束时间为准进行统计。正在运行的任务,其调用信息在任务完成前无法查询到」,监控数据还有 1~2 小时延迟。这意味着一个跑了 13 天的任务,费用要等它跑完才在控制台可见——中途想看花了多少钱是看不到的。
六、把 Batch 接进生产要做的 6 件事
综合上面的核对,如果现在要把批量推理接进一条生产作业,建议按这个顺序做:
- 先用
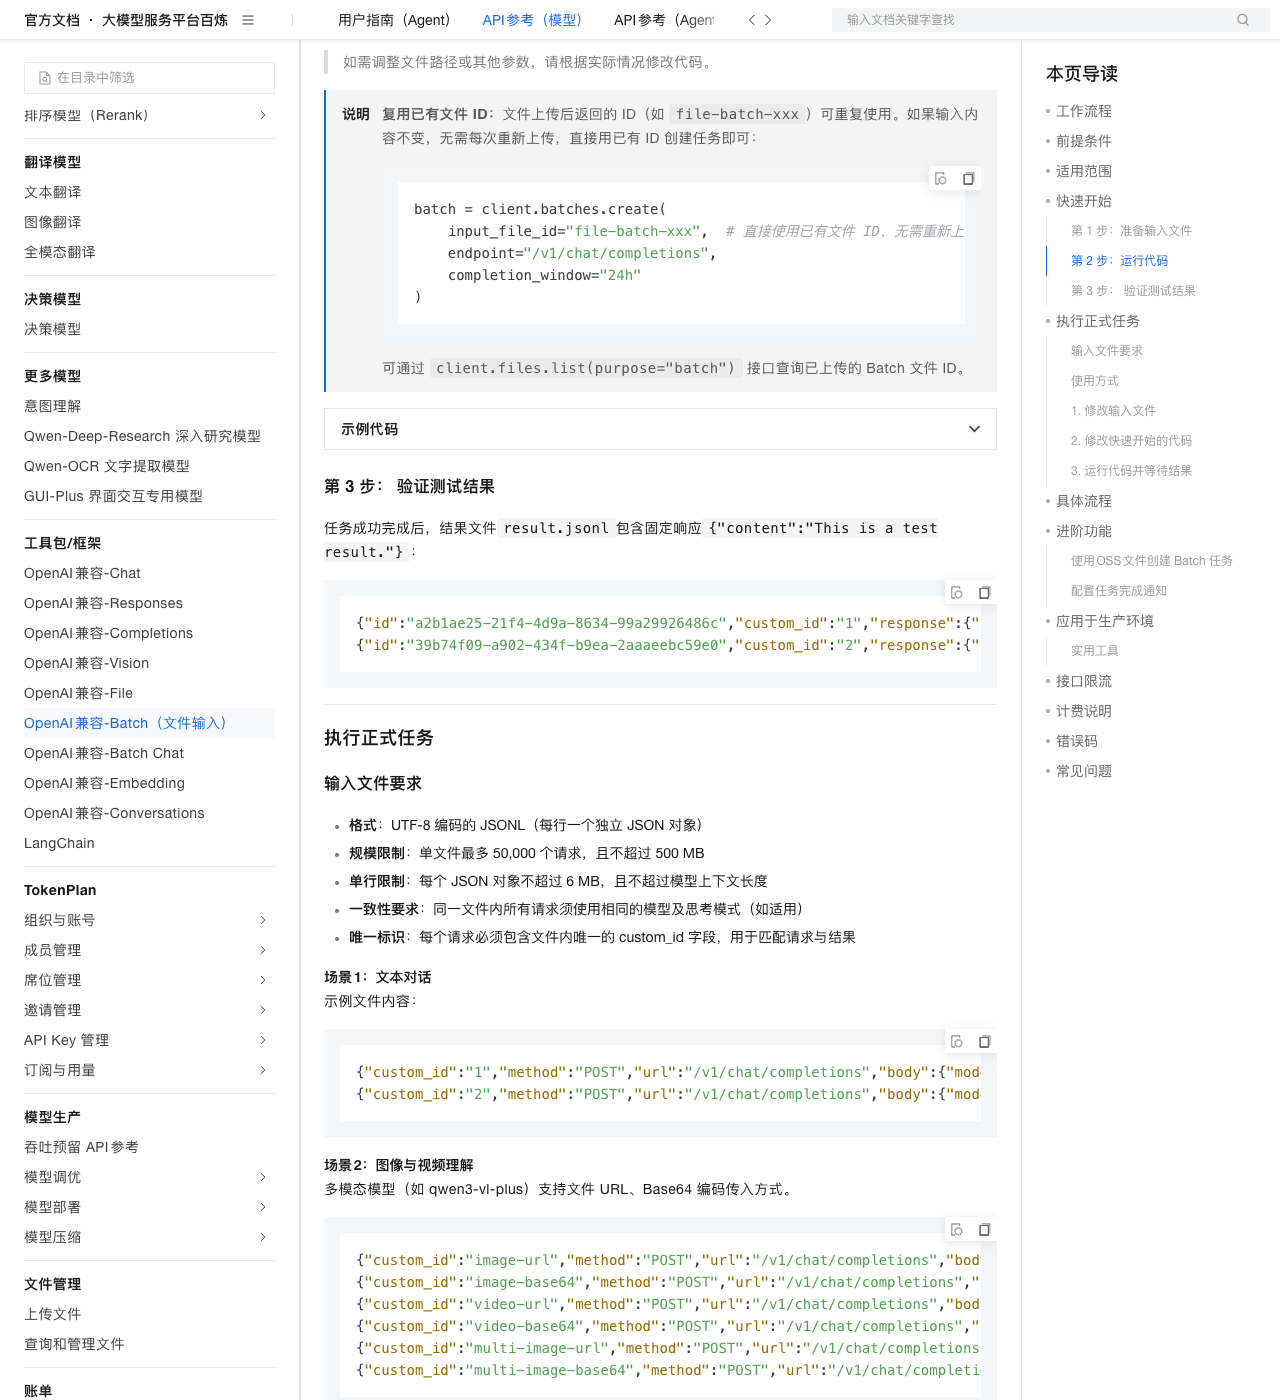
batch-test-model跑通链路,再上真模型。 API 文档提供了一个跳过推理的测试模型,直接返回固定响应,用于验证格式和接口。限制是:文件不超过 1 MB、行数不超过 100、并发最多 2 个任务、不产生推理费用。它的测试端点是/v1/chat/ds-test(和正式任务的/v1/chat/completions不同),且这个测试模型在控制台文档里完全没有出现——只在 API 文档里有。 - 显式设置
enable_thinking,不要依赖默认值。 2026 年的主力模型默认开思考,不显式关掉的话你会同时失去一半折扣和分析推理链的能力。放在body顶层,不要放extra_body。 - JSONL 按「单行 ≤ 1 MB」的保守值切分,并保证一个文件只有一个模型、思考模式一致。
- 多模态媒体一律走公网 URL,本地文件和内网地址会让任务静默卡死。
- 成本预估只算那 18 个有半价标记的模型,其余 6 个按原价估。
custom_id超过 256 字符会直接校验失败,长标识要靠metadata自定义字段回传(自定义字段的值不受 256 限制)。 - 设一个下载结果的自动化。 30 天自动删除,且最长等待时间可以设到 14 天——
expired状态意味着未处理的请求全部终止。
关于耗时,文档只给了模糊口径:「处理时长主要取决于系统当时的负载。系统繁忙时任务可能需要排队。」没有 SLA、没有吞吐量数据、没有排队时间上界,这一点我们同样记为 UNKNOWN。任务生命周期有 7 个状态(validating / in_progress / finalizing / completed / failed / expired / cancelled),其中 finalizing 和 in_progress 在控制台上共用「执行中」标签,没有独立展示文案——如果你的监控是靠状态标签做的,这里会漏掉结果文件写入阶段。
七、口径与未决项
本文的模型清单、价格与标记均以 2026-10-18 12:00 抓取的三份官方页面为准,价格为原价,未计入百炼控制台的活动优惠。命中的 18 个模型半价清单与 6 个缺口模型来自对定价表 1509 行表格的脚本解析,非抽样。
明确标注为未知的 5 项:
- 单行限制 1 MB 与 6 MB 哪一个是服务端实际执行值(未实测提交验证)。
- 定价表未标半价的 6 个模型实际是否仍享 Batch 折扣(未实测调用,比对账单)。
- 批量任务的排队时间与吞吐量(官方无 SLA,无数据)。
qwen-max究竟支持与否(文档孤行点名 vs 分类清单缺失 vs 定价表无标记,三处信号不一致)。- 文档正文与同页代码注释的单行限制不一致(1 MB vs 6 MB),哪一处是当前意图(官方未说明)。
另外提示一点方法论上的局限:定价表有华北2(北京)、美国(弗吉尼亚)、新加坡、德国(法兰克福)、日本(东京)五个地域分页,本文所有价格与标记只取北京地域。其他地域的行号与标记未逐个核对,跨地域的 Batch 可用性以文档为准(文档只列北京与新加坡)。