title: “百炼工具调用能力矩阵实测:63 个模型里,Qwen 全家不支持 tool_choice=\”required\”,思考模式下直接报错” slug: “bailian-function-calling-tool-choice-matrix-2026-10-17” category: “千问”
大多数团队接入 Function Calling,用的都是最省事的那条路:传 tools,等 tool_calls 回来,按 tool_call_id 回填结果,再让模型总结一遍。这条路在天气查询示例里跑得通,放到真实业务里却会撞上一连串没人提前告诉你的限制。
我们把阿里云百炼官方 Function Calling 文档整页拆下来逐条核对(2026-10-17 21:0x 采集,页面 472,325 字节),发现这份能力矩阵里藏着三件事:63 个模型条目中,最主力的一整条产品线在 tool_choice 上有明确缺口;同一个参数在思考/非思考两种模式下语义不同且会硬报错;工具描述本身要计费,所以工具不是越多越好。
下面是按官方文档原文核对出来的结论。
一、先把范围说清楚:63 个模型条目,36 个是千问
文档「支持的模型」一节共列出 63 个模型条目,全部唯一、无重复(按顿号与换行切分后逐条计数,脚本可复算)。其中千问自有模型 36 个,第三方模型 27 个。
千问 36 个的内部结构:
| 分组 | 条目数 | 具体条目 |
|---|---|---|
| Max | 5 | Qwen3.8-Max / 3.7-Max / 3.6-Max / 3-Max / Qwen-Max 系列 |
| Plus | 9 | 含 Qwen3.7~3.5-Plus、Qwen-Plus、Qwen3-VL-Plus、Qwen3.5-Omni-Plus、Qwen3.5-Omni-Plus-Realtime、Qwen-Audio-3.1/3.0-Realtime-Plus |
| Flash | 12 | 含 Qwen3.8~3.5-Flash、Qwen-Flash、Qwen3-VL-Flash、Qwen3.8-Omni-Flash、Qwen3.5/Qwen3-Omni-Flash 及 Realtime、Qwen-Audio-3.0-Realtime-Flash |
| Coder | 3 | Qwen3-Coder / Qwen2.5-Coder / Qwen-Coder 系列 |
| Turbo | 1 | Qwen-Turbo 系列 |
| 开源系列 | 6 | Qwen3.8 / 3.6 / 3.5 / 3 / 2.5 开源系列、Qwen3-VL 开源系列 |
第三方 27 个按厂商与托管方分成四组:DeepSeek 9 个(百炼部署 1 个、硅基流动 4 个、快手万擎 4 个)、GLM 4 个(glm-5.3 / 5.2 / 5.1 / 5)、Kimi 9 个(百炼部署 4 个、月之暗面部署 5 个)、MiniMax 5 个(百炼部署 1 个、稀宇科技部署 4 个)。
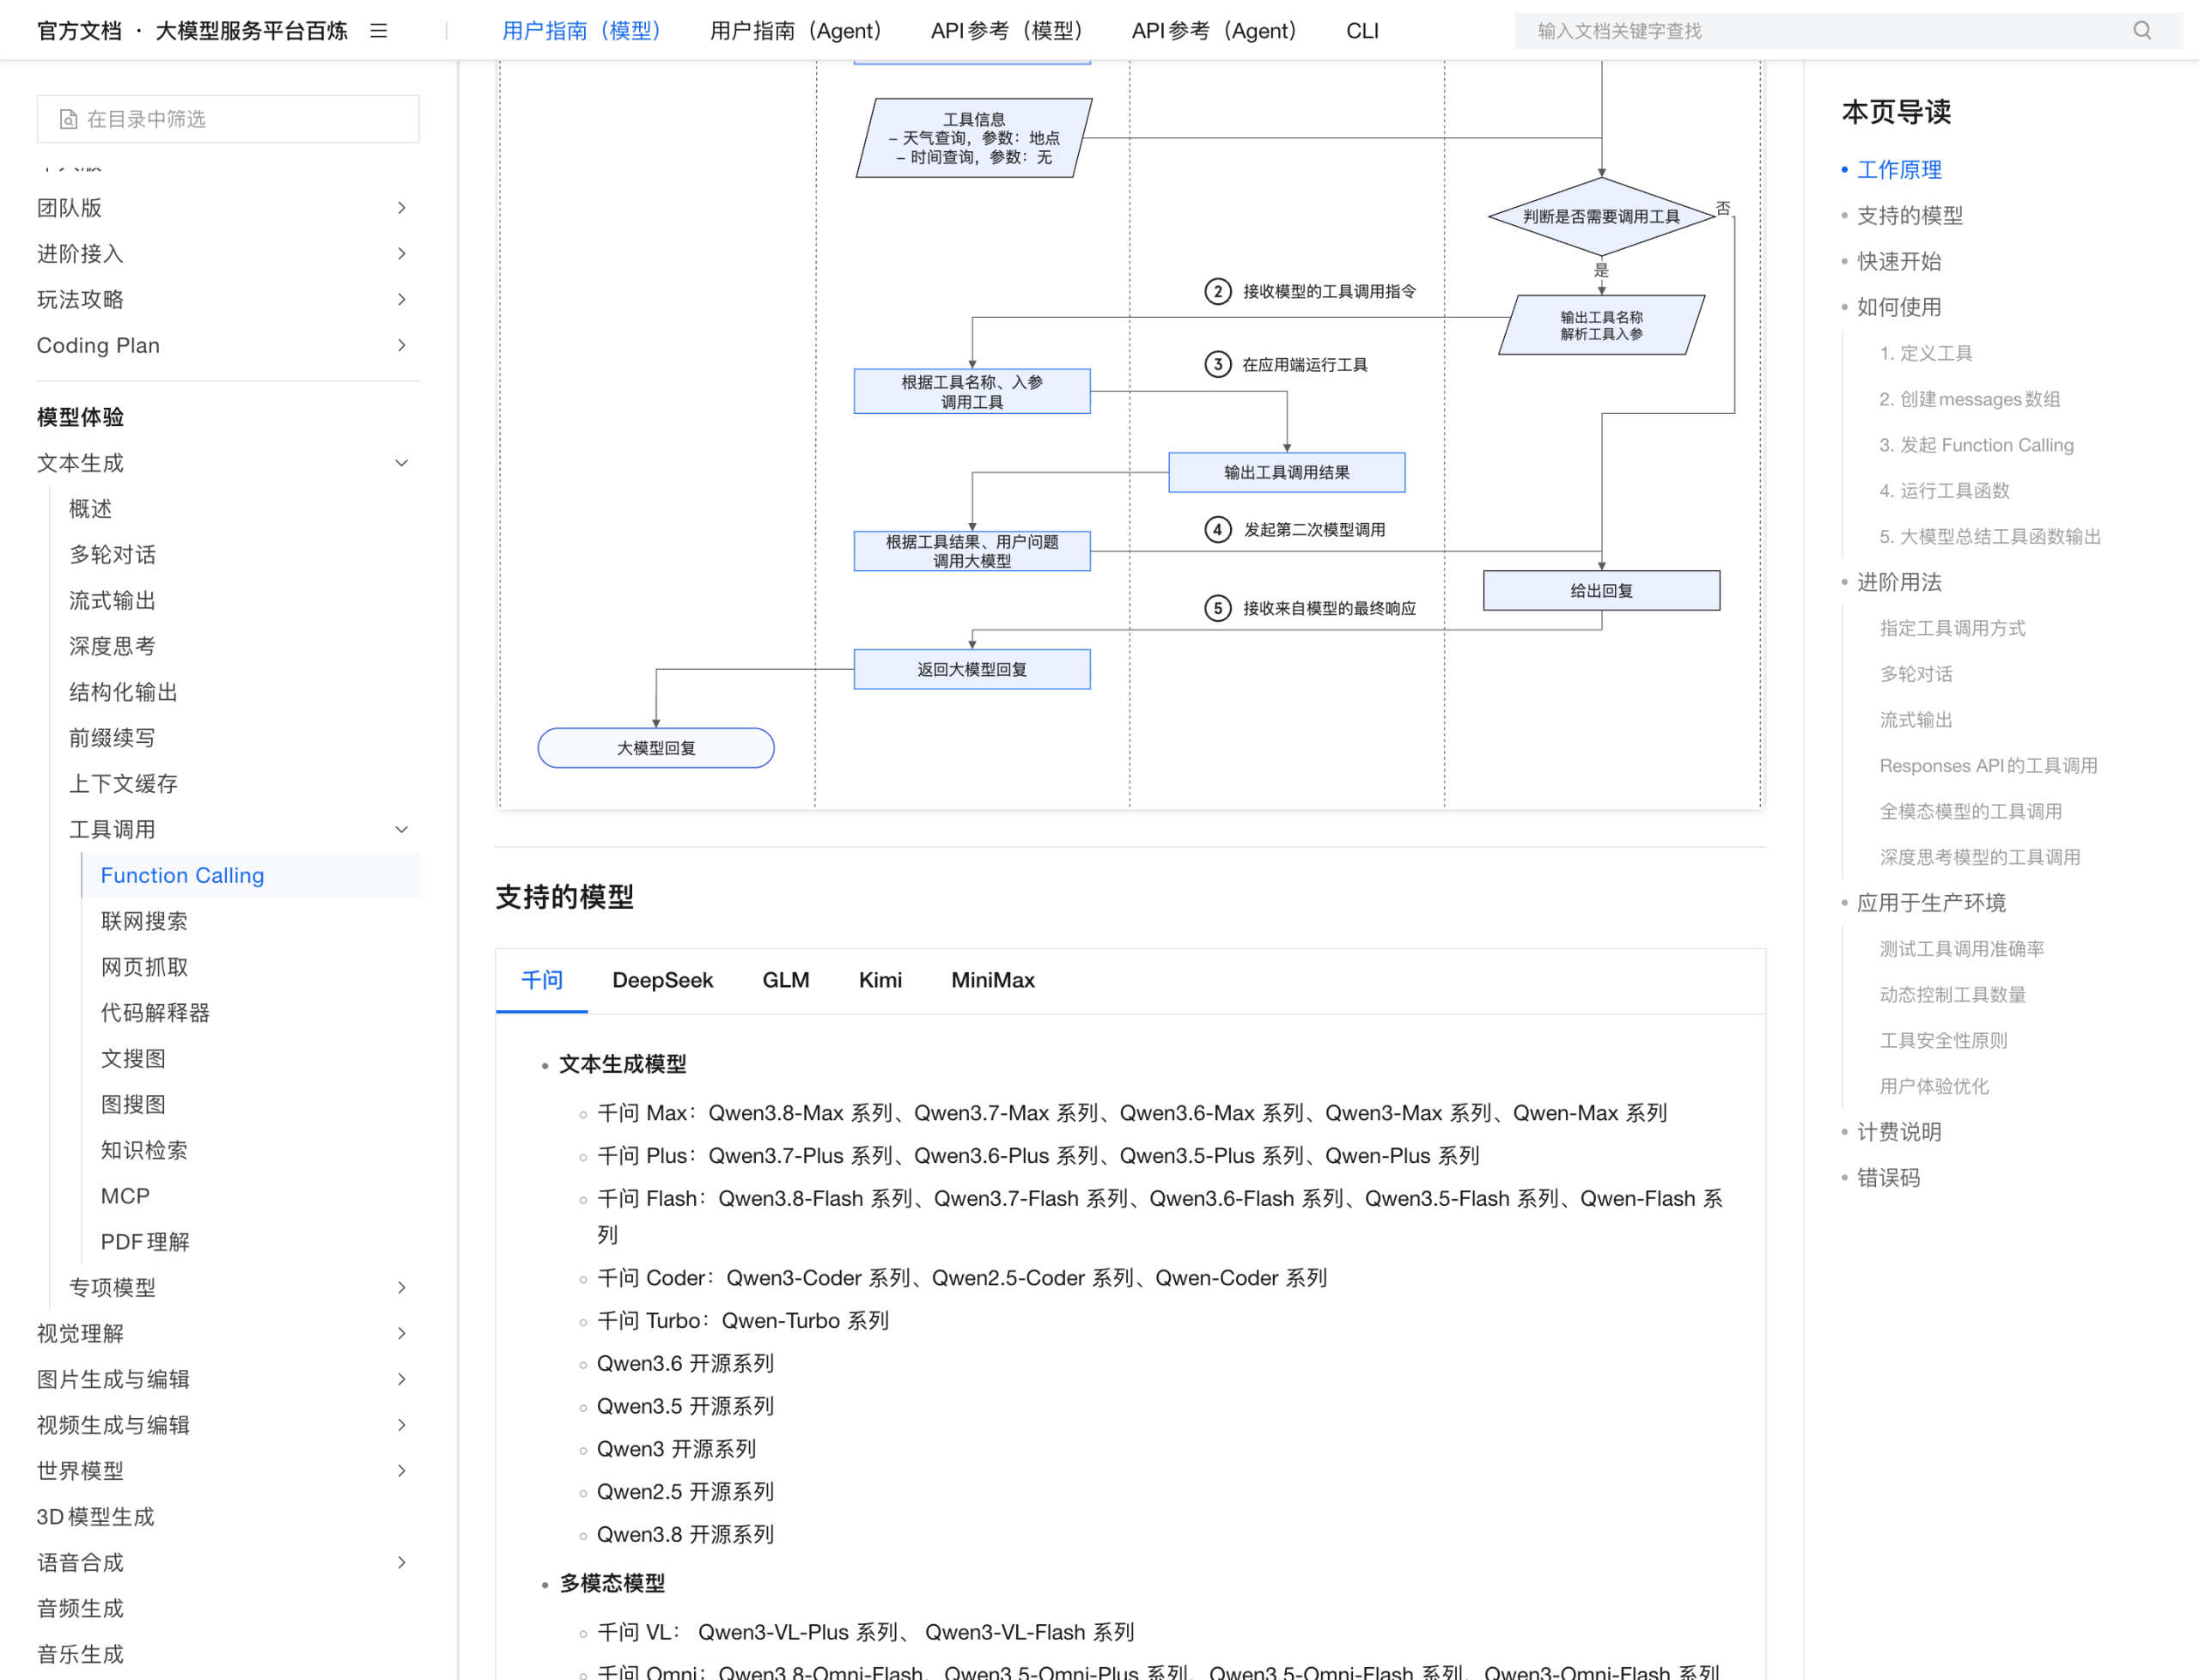
值得注意的是,这 27 个第三方条目里有 16 个并非阿里云自己部署——siliconflow/*、vanchin/*、kimi/*、MiniMax/* 这类带厂商前缀的模型,是由第三方托管后转发进来的。它们和 glm-5.3、kimi-k3 这种百炼直接部署的条目,在能力上并不等价,后面会具体讲到。
二、最重要的一个缺口:Qwen 全系列不支持 tool_choice=”required”
tool_choice 决定模型是否调用工具,默认值是 "auto",也就是由模型自己判断要不要调用。文档给出了另外两种强制策略:
- 强制使用某个工具:
tool_choice设为{"type": "function", "function": {"name": "..."}},模型不参与选择,只输出入参。 - 强制使用至少一个工具:
tool_choice设为"required",保证tool_calls不为空。
关键在这里。官方文档在讲 "required" 时,紧接着写了一句限定:
Qwen 系列模型暂不支持将 tool_choice 设为 “required”:非思考模式下 required 无法保证一定调用工具,思考模式下当前不支持 “required”。
也就是说,如果你在模型选型时优先考虑了 Qwen(这是最自然的选择,因为 Qwen 是百炼的主力产品线,36/63 个条目),那么 required 这个策略对你是不可用的。注意文档的措辞是「暂不支持」,这意味着未来可能支持——但今天的工程决策必须按不可用来做。
好在这并不意味着没有替代方案。如果你的场景确实需要「保证一定调用工具」,有两个方向:
- 用
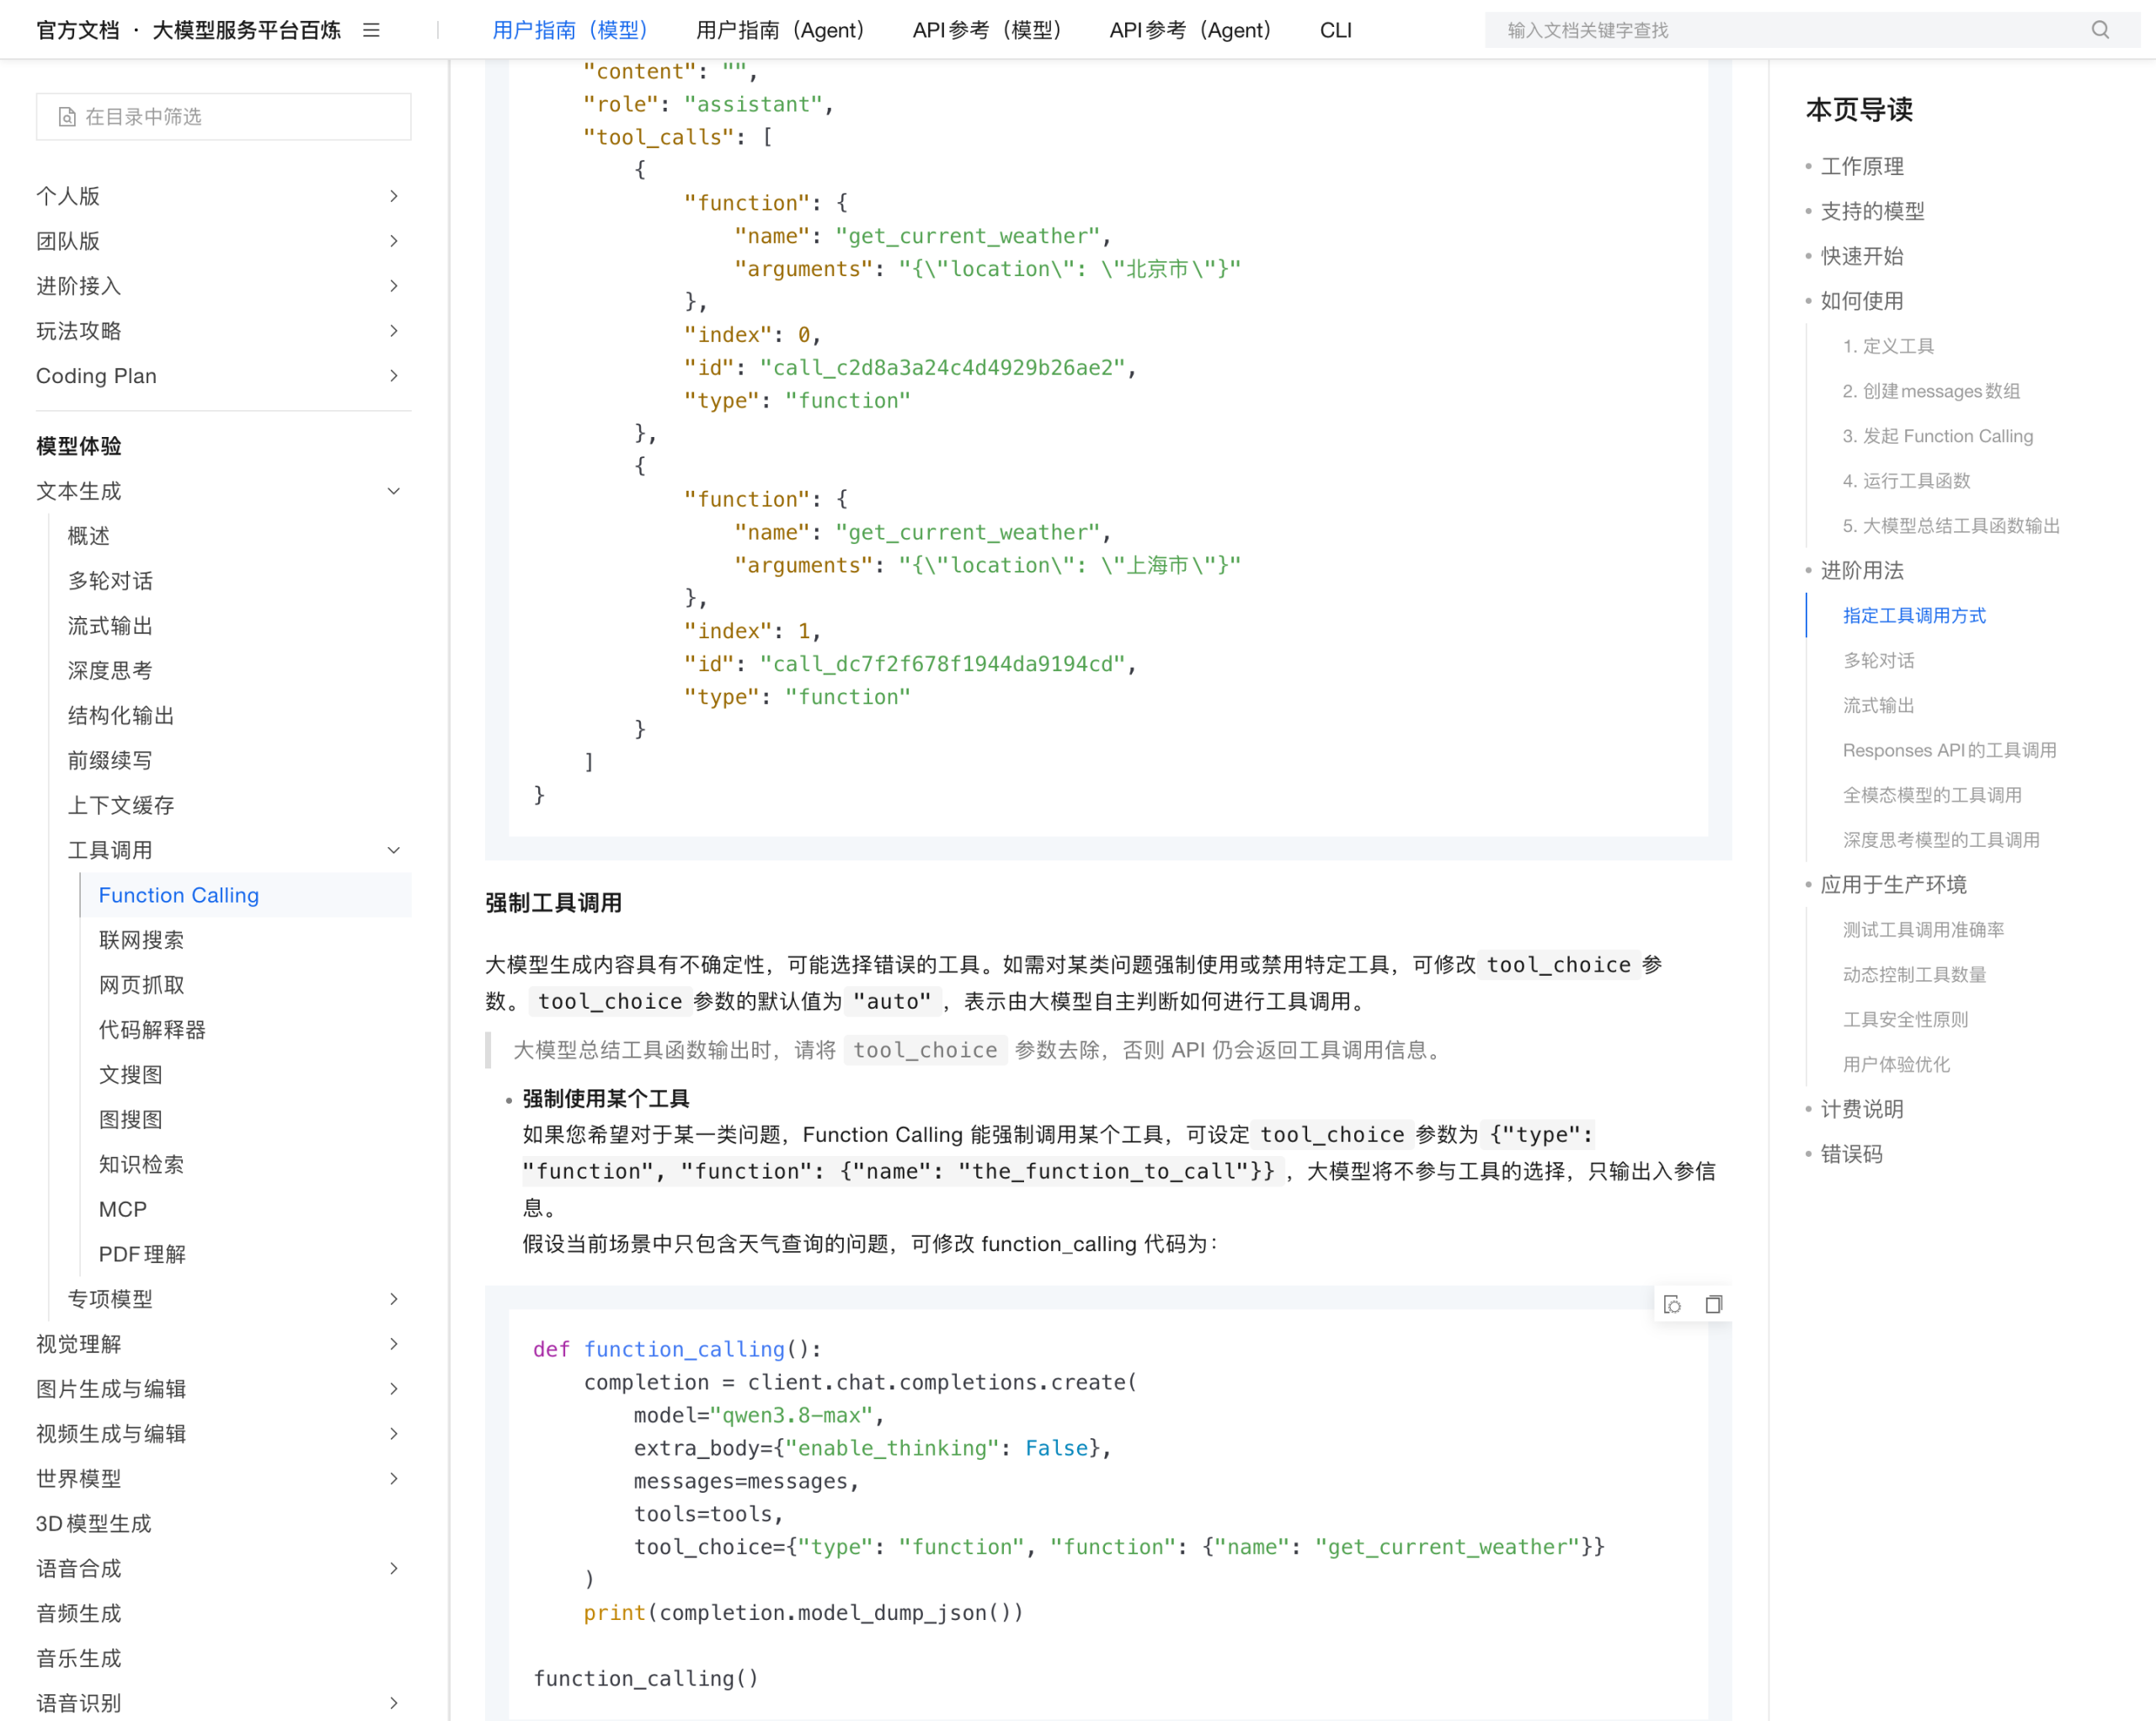
{"type":"function","function":{"name":"..."}}形式强制指定某一个具体工具。文档说明这种形式下「无论输入什么问题,返回对象的工具函数都会是 get_current_weather」。代价是你必须确定问题确实该走这个工具,官方也提示「使用该策略前请确保问题与选择的工具相关,否则可能返回不符合预期的结果」。 - 换个支持
required的模型。文档在 Kimi 部分明确写了:月之暗面部署的kimi/*系列中tool_choice支持"auto"(默认)与"none",且 只有kimi/kimi-k3还支持"required"。
还有一个很容易踩的坑,文档在强制工具调用小节顶部就给了警告:
大模型总结工具函数输出时,请将 tool_choice 参数去除,否则 API 仍会返回工具调用信息。
也就是说,你不能把 tool_choice 一路带到最后那个「让模型总结工具结果」的请求里。否则模型不会给你总结,而是再次返回工具调用指令,你的循环就停不下来了。
三、思考模式与 tool_choice 直接互斥,而且会报错
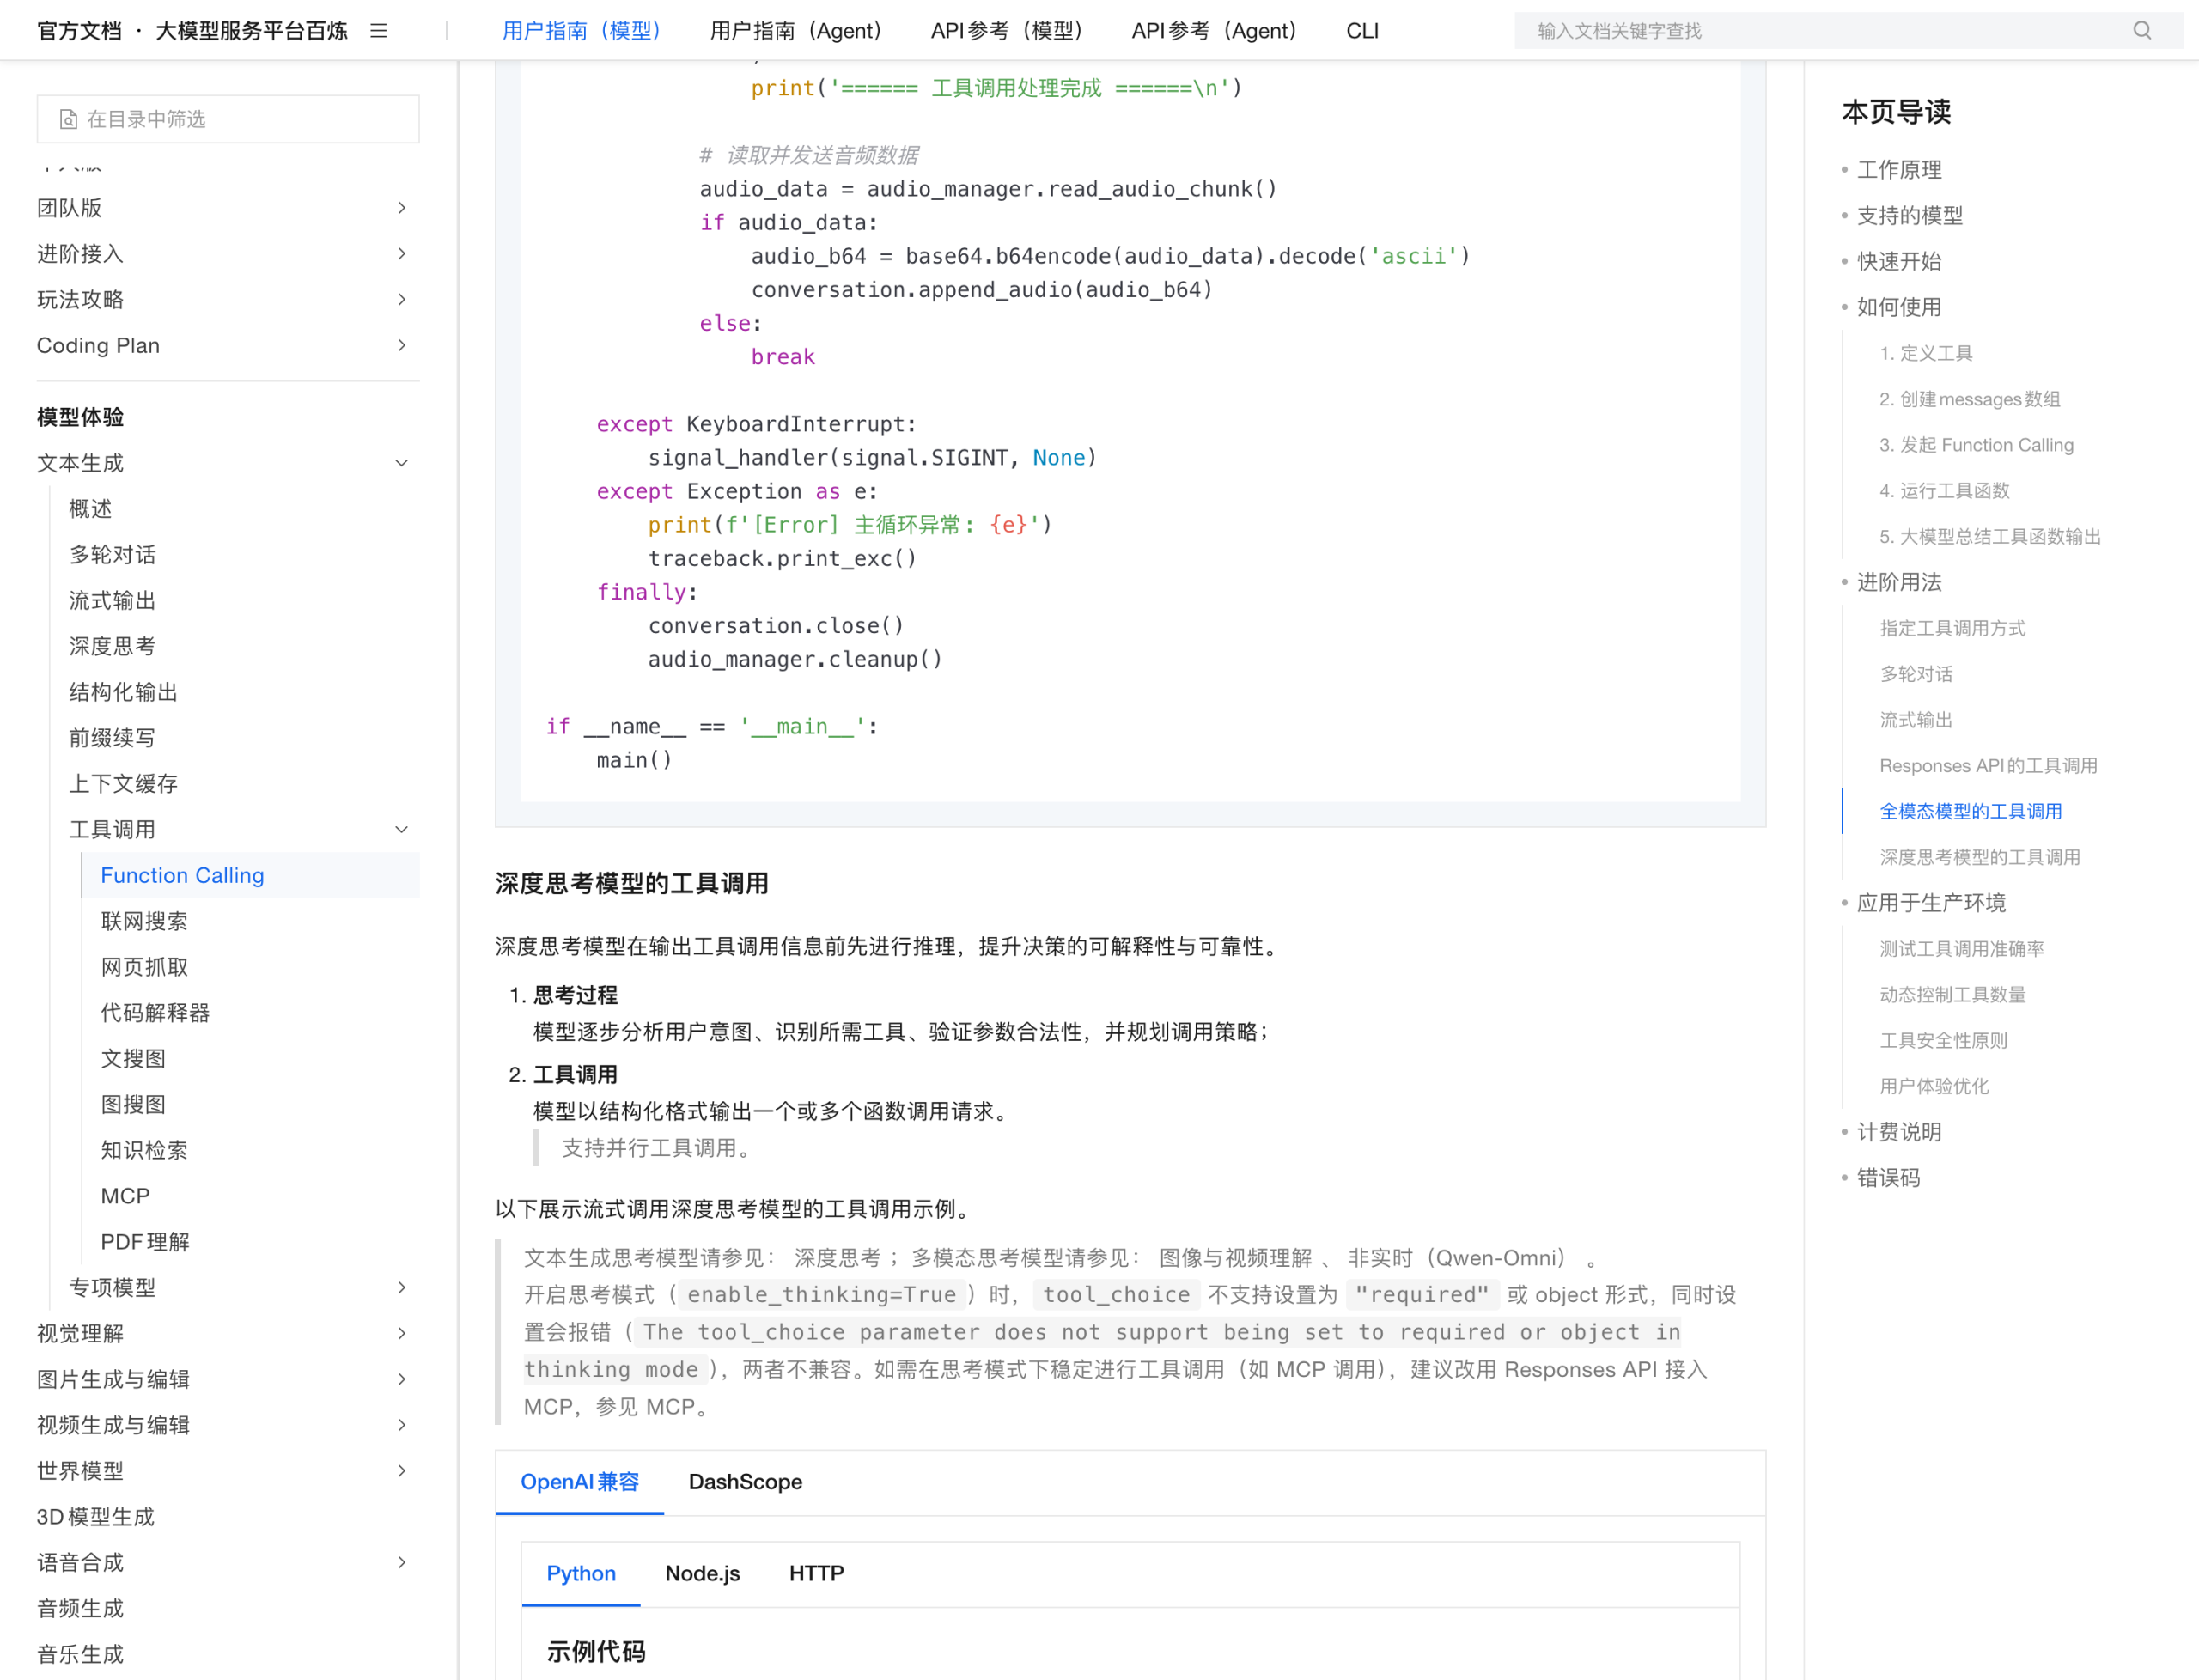
如果你用的是开启深度思考的模型(比如 qwen3.8-max 配 enable_thinking=True),这里有一个硬冲突。文档原文:
开启思考模式(enable_thinking=True)时,tool_choice 不支持设置为 “required” 或 object 形式,同时设置会报错(The tool_choice parameter does not support being set to required or object in thinking mode),两者不兼容。
这是报错而不是静默降级。配置写成 enable_thinking=True 加 tool_choice="required",请求会直接失败。对 MCP 这类需要稳定触发工具调用的场景,官方给的解法是改用 Responses API 接入 MCP。
所以「思考模式更强」和「工具调用要可控」这两个诉求,在 Chat Completions 接口下是互斥的。工程上的取舍是明确的:需要可控的工具触发就关掉思考,需要推理质量就接受 tool_choice 只能用 auto/none。
四、按厂商和部署方翻车的四种方式
同一份 tool_choice 文档,对不同模型的要求是不一样的。下面四种情况全部来自官方「支持的模型」一节的限定说明。
4.1 GLM:不传 tool_stream,工具调用静默失效
调用 GLM 系列模型的 Function Calling 时,需在请求中传入
extra_body={"tool_stream": True},否则模型不会返回 tool_calls,工具调用不生效。glm-5.3 的 tool_stream 默认值为 true,无需显式传入。
这条最隐蔽——不传不是报错,是不生效。glm-5.2、glm-5.1、glm-5 三个版本都必须显式传 tool_stream: True,只有 glm-5.3 改了默认值。如果你按官方 Quick Start 的代码跑 glm-5.2,看到的是 HTTP 200、tool_calls: null、content 正常返回,很容易误判成「模型判断不需要调用工具」。而 glm-5.3 因为默认已经是 true,同样的代码直接能跑通——这意味着从 5.3 回退到 5.2 会让工具调用无声失效,且没有任何错误提示。
4.2 Kimi(月之暗面部署):思考模式要手动保留 reasoning_content
在思考模式下,使用
kimi/kimi-k3、kimi/kimi-k2.7-code-highspeed、kimi/kimi-k2.7-code、kimi/kimi-k2.6、kimi/kimi-k2.5进行工具调用时,需在每轮 assistant 消息中保留 reasoning_content 字段。
这里的关键是「每轮」。如果你在多轮工具调用循环里像官方 Chat Completions 示例那样做 messages.append(completion.choices[0].message),通常会把 reasoning 字段一起带上;但只要中间做了消息裁剪、摘要或重新构造 assistant 消息,就可能丢掉它。
4.3 Qwen-Omni-Realtime:两个参数都不支持
Qwen-Omni-Realtime 系列不支持 tool_choice 和 parallel_tool_calls 参数。
实时语音模型这一条是直接封死,没有折中方案。要在语音场景做工具调用,只能走文档中 Realtime 的事件流(response.create、function_call_output)那套。
4.4 百炼部署 vs 第三方部署,同名不同要求
这是最容易在选型时被忽略的一层。kimi-k3 在百炼部署和月之暗面部署下是两个不同的条目:kimi-k3(百炼)列在 Kimi 百炼组,kimi/kimi-k3(月之暗面)带 reasoning_content 约束且支持 required。同理 MiniMax-M2.5 与 MiniMax/MiniMax-M2.5 是两条独立记录。选型表里如果只写模型名不写部署方,能力约束就会对不上。
五、并行工具调用默认是关的,且工具描述要计费
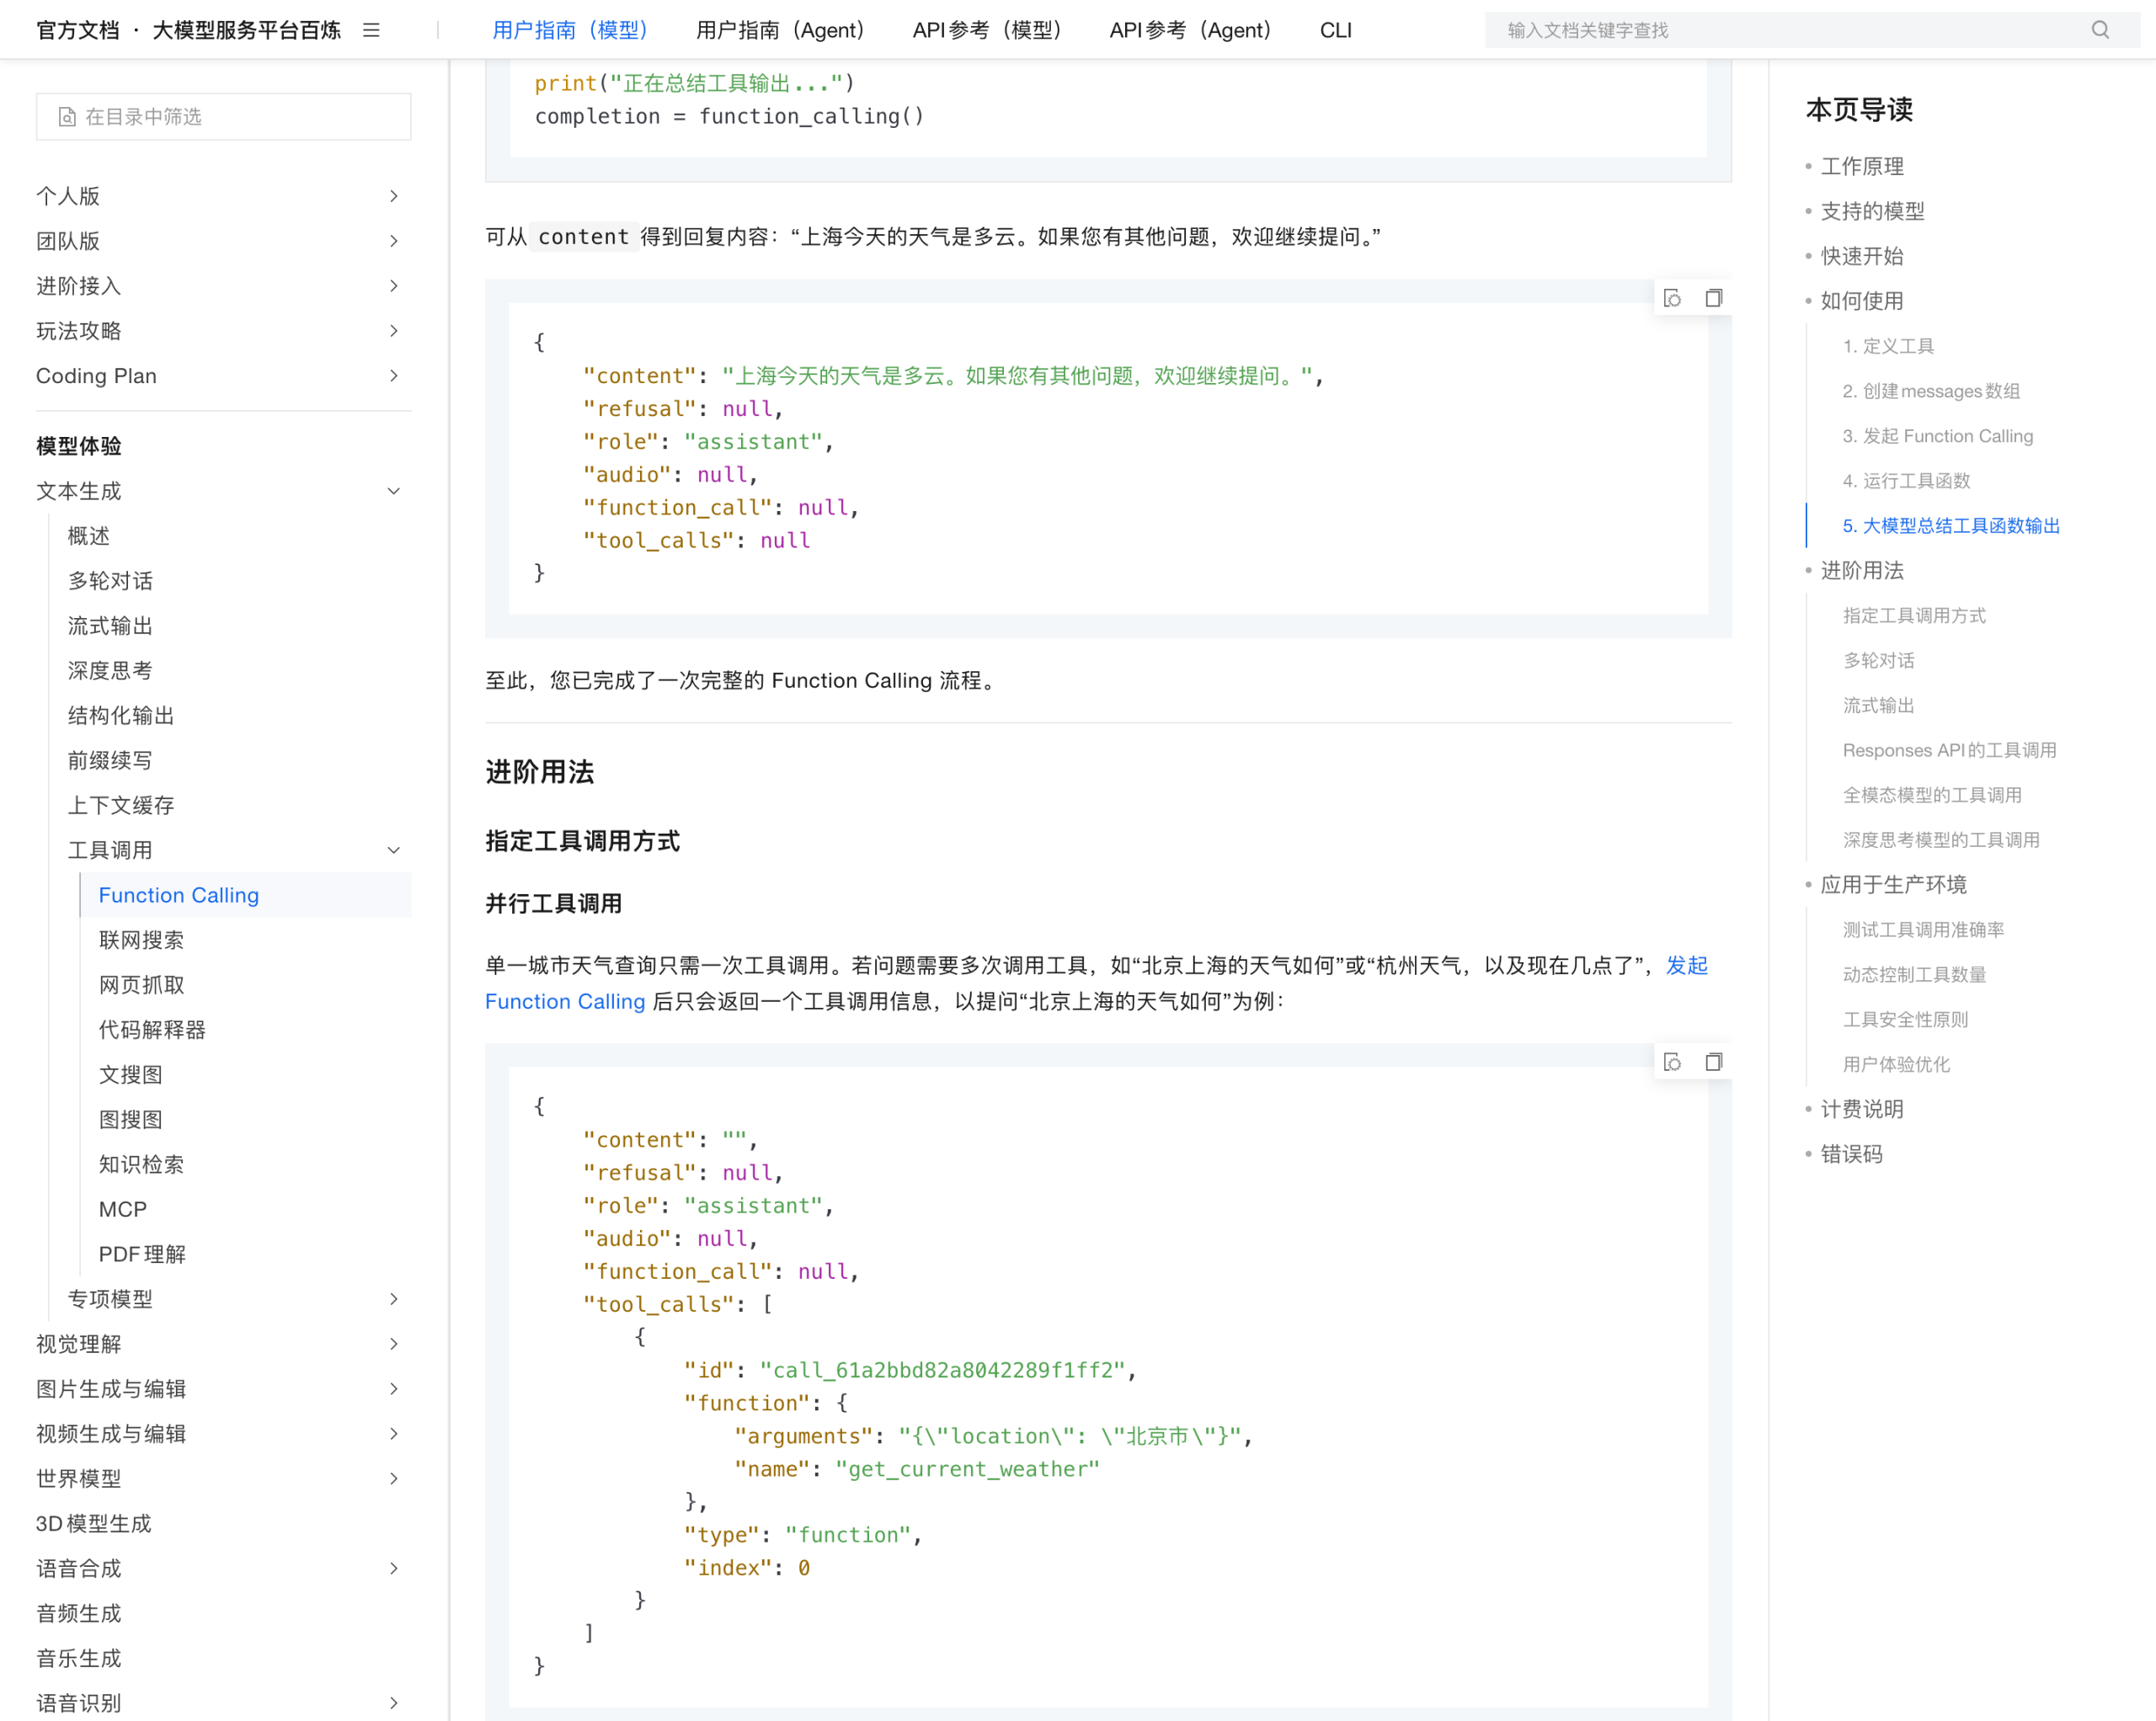
parallel_tool_calls 默认不开启。文档给的例子很直白:问「北京上海的天气如何」,默认情况下只会返回一个工具调用信息,入参里只有「北京市」,「上海市」被丢掉了。要拿到全部结果必须显式传 parallel_tool_calls=True。
文档同时给出了适用边界:并行适合任务之间无依赖的情况;若工具 A 的输入依赖工具 B 的输出(工具 A 的输入与工具 B 的输出结果有关),请用 while 循环实现串行调用。
流式场景还有一个实现细节容易写错:工具函数名在流式响应的第一个数据块返回,而入参 arguments 是分块返回的,必须按 index 累加拼接。官方 Python 示例打印出来的三个 chunk 就是这个形态,第一个 chunk 里 name 有值而 arguments 只有 {"location":,第二个 chunk 里 name=None 而 arguments 是 ' "杭州"}'——这意味着你在第一个 chunk 就去读 name、在最后一个 chunk 才去读 arguments 是可以的,但只要在中间某个 chunk 上直接判断 if tool_call.function.name 做业务分支,就会漏掉调用。
最后一个和成本直接相关的点,在「计费说明」一节:
除 messages 数组中的 Token 外,工具描述信息也作为输入 Token 计费。
这句话和下一节的建议是配套的。
六、工具数量建议不超过 20 个,因为工具描述要计费
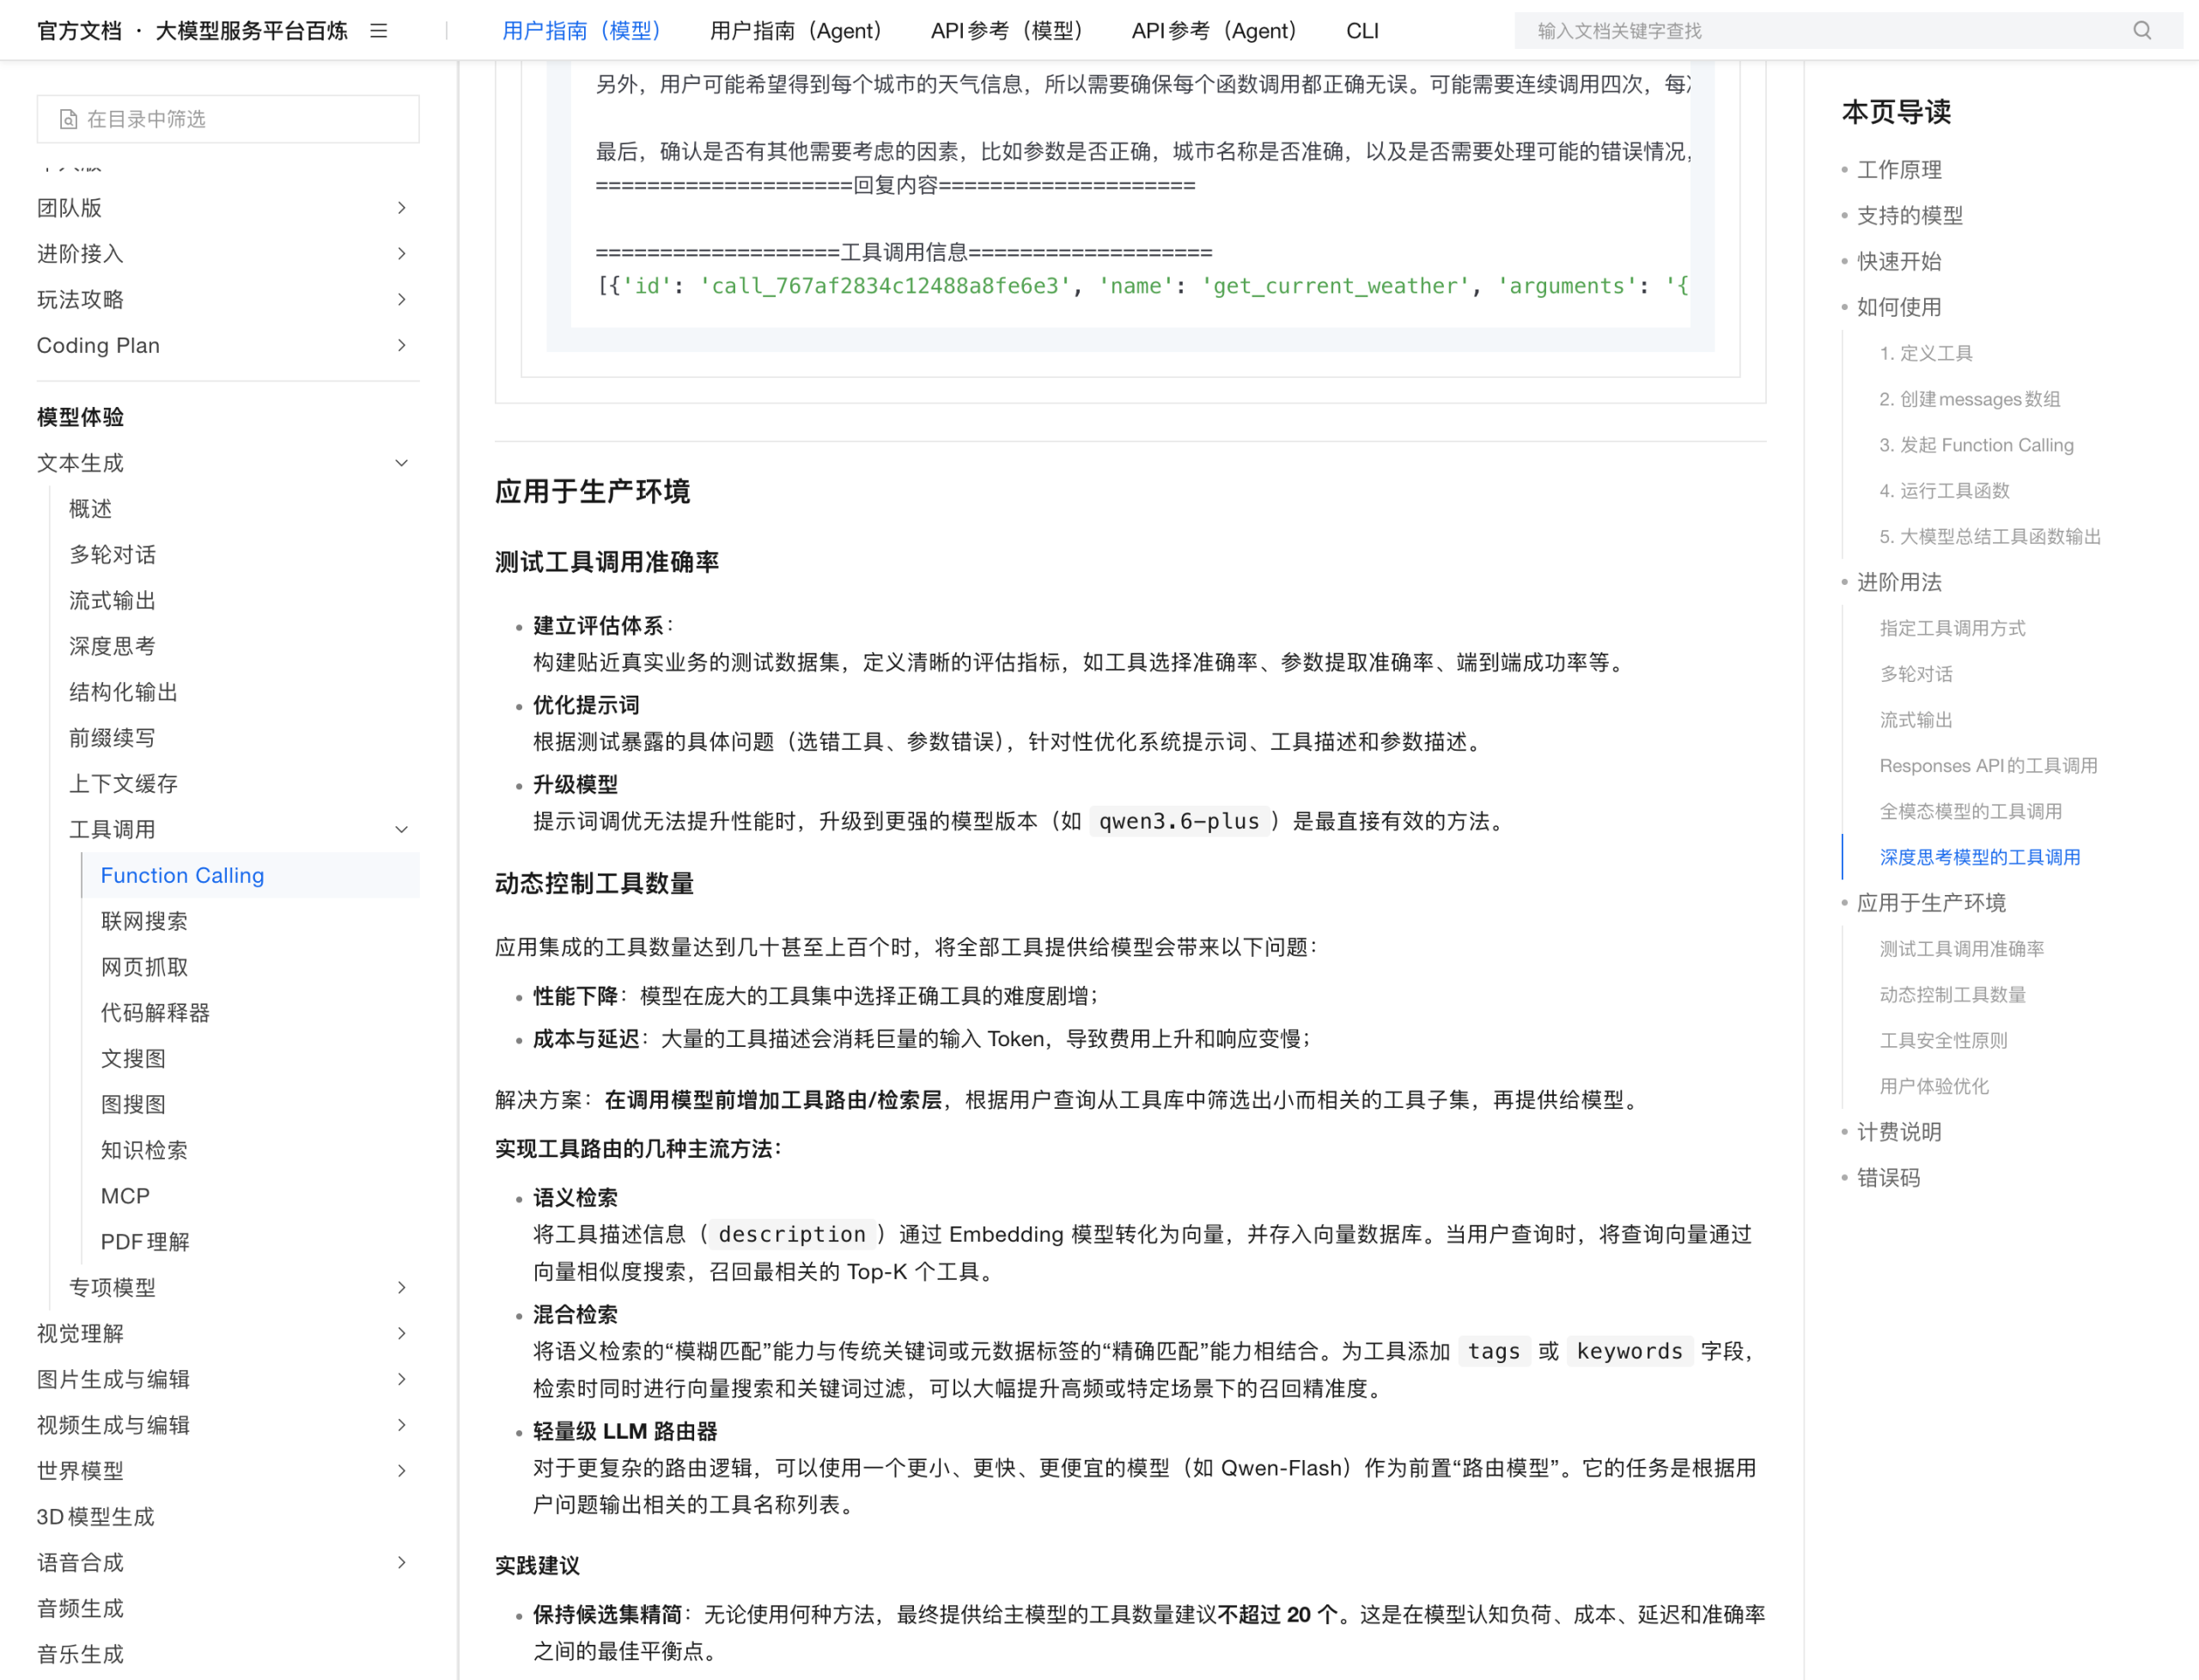
文档「动态控制工具数量」一节写得很直接:应用集成的工具数量达到几十甚至上百个时,把全部工具提供给模型会带来两个问题——性能下降(模型在庞大工具集中选择正确工具的难度剧增)与成本与延迟上升(大量的工具描述会消耗巨量的输入 Token,导致费用上升和响应变慢)。
官方给出的三种路由方案是语义检索(工具 description 过 Embedding 存入向量库,查询时向量相似度召回 Top-K)、混合检索(语义 + keywords/tags 精确过滤)、轻量级 LLM 路由器(用更小更便宜的模型如 Qwen-Flash 做前置路由,输出相关工具名列表)。
但真正该记住的是这句数字:
保持候选集精简:无论使用何种方法,最终提供给主模型的工具数量建议不超过 20 个。这是在模型认知负荷、成本、延迟和准确率之间的最佳平衡点。
20 个这个数字把上一节的计费规则串了起来:工具描述按输入 Token 计费,所以「工具塞得越多越全」这个直觉在成本上是反直觉的。10 个工具、每个 description 写 200 字,与 100 个工具、每个 description 写 50 字,总 Token 差 4 倍——而后者的准确率还会因为候选集过大而下降。
七、Chat Completions 与 Responses API 的四个字段差异
如果你同时维护两条链路,或者正考虑迁移到 Responses API,官方给了四个维度的对照:
| 维度 | Chat Completions | Responses API |
|---|---|---|
| 工具定义格式 | {"type":"function","function":{"name":...,"parameters":...}} |
{"type":"function","name":...,"parameters":...} |
| 工具调用输出 | response.choices[0].message.tool_calls |
response.output 中 type 为 function_call 的项 |
| 工具结果回传 | {"role":"tool","tool_call_id":...,"content":...} |
{"type":"function_call_output","call_id":...,"output":...} |
| 最终回复 | response.choices[0].message.content |
response.output_text |
最容易漏的是工具定义少了一层 function 包装——Responses API 把 name 和 parameters 直接提到 type 同级。这一层写错,报错信息未必指向定义格式。
两种 API 的工具结果都支持字符串和内容数组两种形式。Responses API 的 output 数组元素类型为 input_text 与 input_image,image_url 直接传 URL 或 Base64 Data URI,不使用嵌套对象——这与 Chat Completions 里 {"type":"image_url","image_url":{"url":...}} 的嵌套写法不同。
八、未知项(本文明确标注为未核实)
- 「暂不支持」的时间表未知:文档未给出 Qwen 支持
tool_choice="required"的时间点,也未给出计划。是否会支持、何时支持均属 UNKNOWN,本文只陈述当前状态。 parallel_tool_calls在思考模式下的行为未说明:文档只说思考模式「支持并行工具调用」,没有说明思考与非思考下行为是否一致。本文不做推断。- 未做真机调用验证:本轮仅对官方文档做文本级全量核对,未使用 API Key 发起任何实际请求,因此本文所有能力结论均为「文档如此声明」,而非实测调用结果。
- 各模型的实际工具选择准确率未测:文档建议用「工具选择准确率、参数提取准确率、端到端成功率」三个指标评估,但未给出各模型的基准数据。
tool_choice的 object 形式支持范围未知:文档只说明思考模式下不支持 object 形式,非思考模式下哪些模型支持 object 形式,文档未列举。- MCP 文档的模型清单与本文矩阵不同:MCP 文档的支持模型只列到 Qwen3.8/3.6/3.5 三档且带额外限定(如「Qwen3.6 开源系列(qwen3.6-27b 除外)」、「Qwen3.5 开源系列仅支持通过 Responses API 调用」),与 Function Calling 页的 36 个千问条目不是同一套清单,跨文档推断能力时需注意。
九、与站内其他千问文章的分工
- post 2808(OpenAI 兼容层协议面):讲 BASE_URL 迁移、跨地域 Key 401、协议不兼容——是接入层。
- post 2823(上下文缓存计费):讲缓存计价矩阵——是计费层的缓存维度。
- post 2761(限流)、post 2773(错误码):分别是配额层与错误面。
- 本文讲的是工具调用控制面:能力矩阵、
tool_choice语义、思考模式互斥、并行策略、工具数量与计费的耦合。
十、来源与采集口径
| 来源 | 用途 | 采集时间 | 体积 |
|---|---|---|---|
| qwen-function-calling(主源) | 能力矩阵、tool_choice 全部约束、并行/流式、生产建议、计费说明 |
2026-10-17 21:0x | 472,325 B |
| deep-thinking | 思考模式交叉核对(该页 tool_choice 命中 0 处) |
2026-10-17 21:0x | 303,636 B |
| mcp | 思考模式工具调用的官方解法核对 | 2026-10-17 21:0x | 90,484 B |
采集方式:curl 抓取全量 HTML 后本地解析,按顿号与换行切分模型清单,逐条计数得 63(36 千问 + 27 第三方,零重复)。配图为 2026-10-17 使用本机 Chrome 对官方文档页实拍,5 张均经逐张目视确认内容与正文一致,非占位图。
本文所有关于模型能力与参数限制的陈述,均可在上表第一份官方文档中逐字核对;凡官方未说明的,均在第八节标注为 UNKNOWN。深度思考模型的推理行为本身,参见官方 深度思考 文档;思考模式下稳定调用工具的 MCP 接入方式,参见官方 MCP 文档。