12 点这一轮,我把百炼的「实时」这一整条产品线翻了一遍。站内已经有的 14 篇 Qwen/百炼 文章,定价、限流、错误码、批量推理、缓存、Function Calling、视觉 Token、文本向量、OpenAI 兼容接口各占一篇,唯独没有任何一篇写过实时模型。而实时这条线上,藏着整个 Qwen 家族最容易被误解的一条计费规则。
先说结论:Qwen-Omni-Realtime 不是「一次问答计一次费」的模型。它的输入 Token 会随着对话轮次逐轮累积——第 30 轮的一次短回答,计费输入量里可能还压着前 29 轮的全部音频、图像和文本。
本文所有数字均来自阿里云百炼官方文档 Qwen-Omni-Realtime 实测抓取,文档页面标注更新时间 2026-10-16 11:58:08。
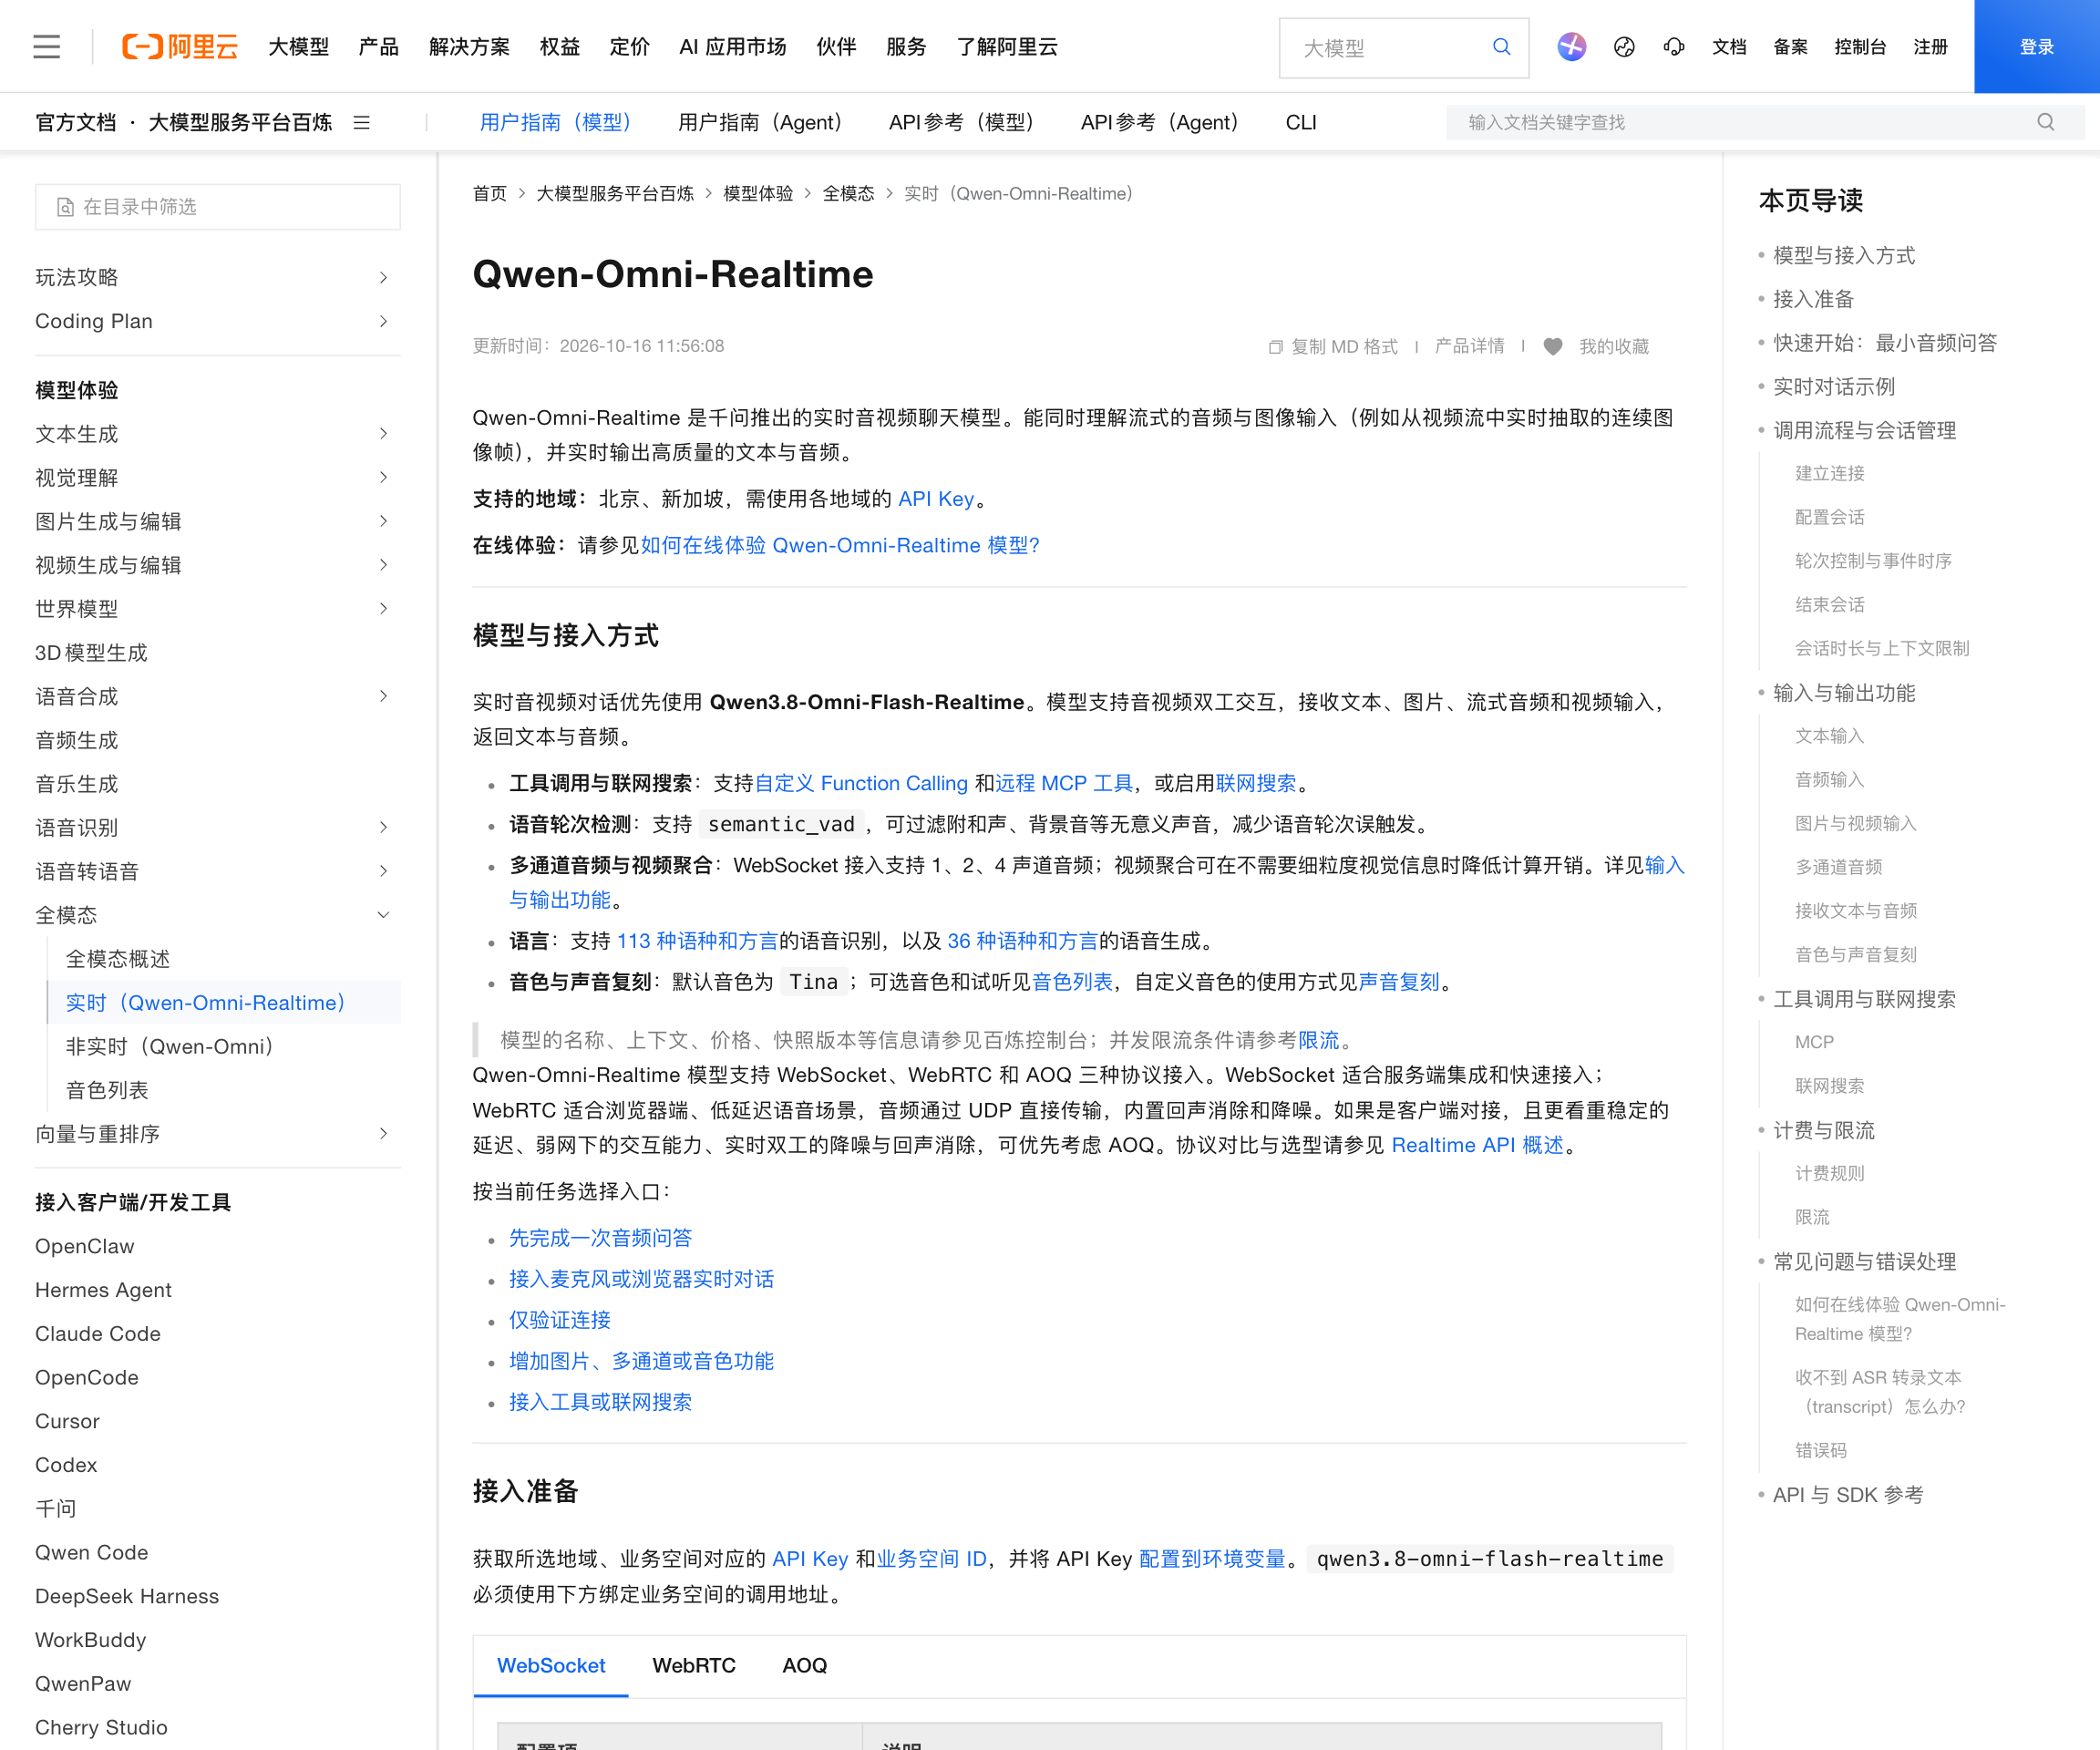
一、三个在售型号,上下文上限各不相同
文档把 Qwen-Omni-Realtime 拆成三个型号,它们的差别不只在价格和速度,还直接决定了你能撑多长的会话。
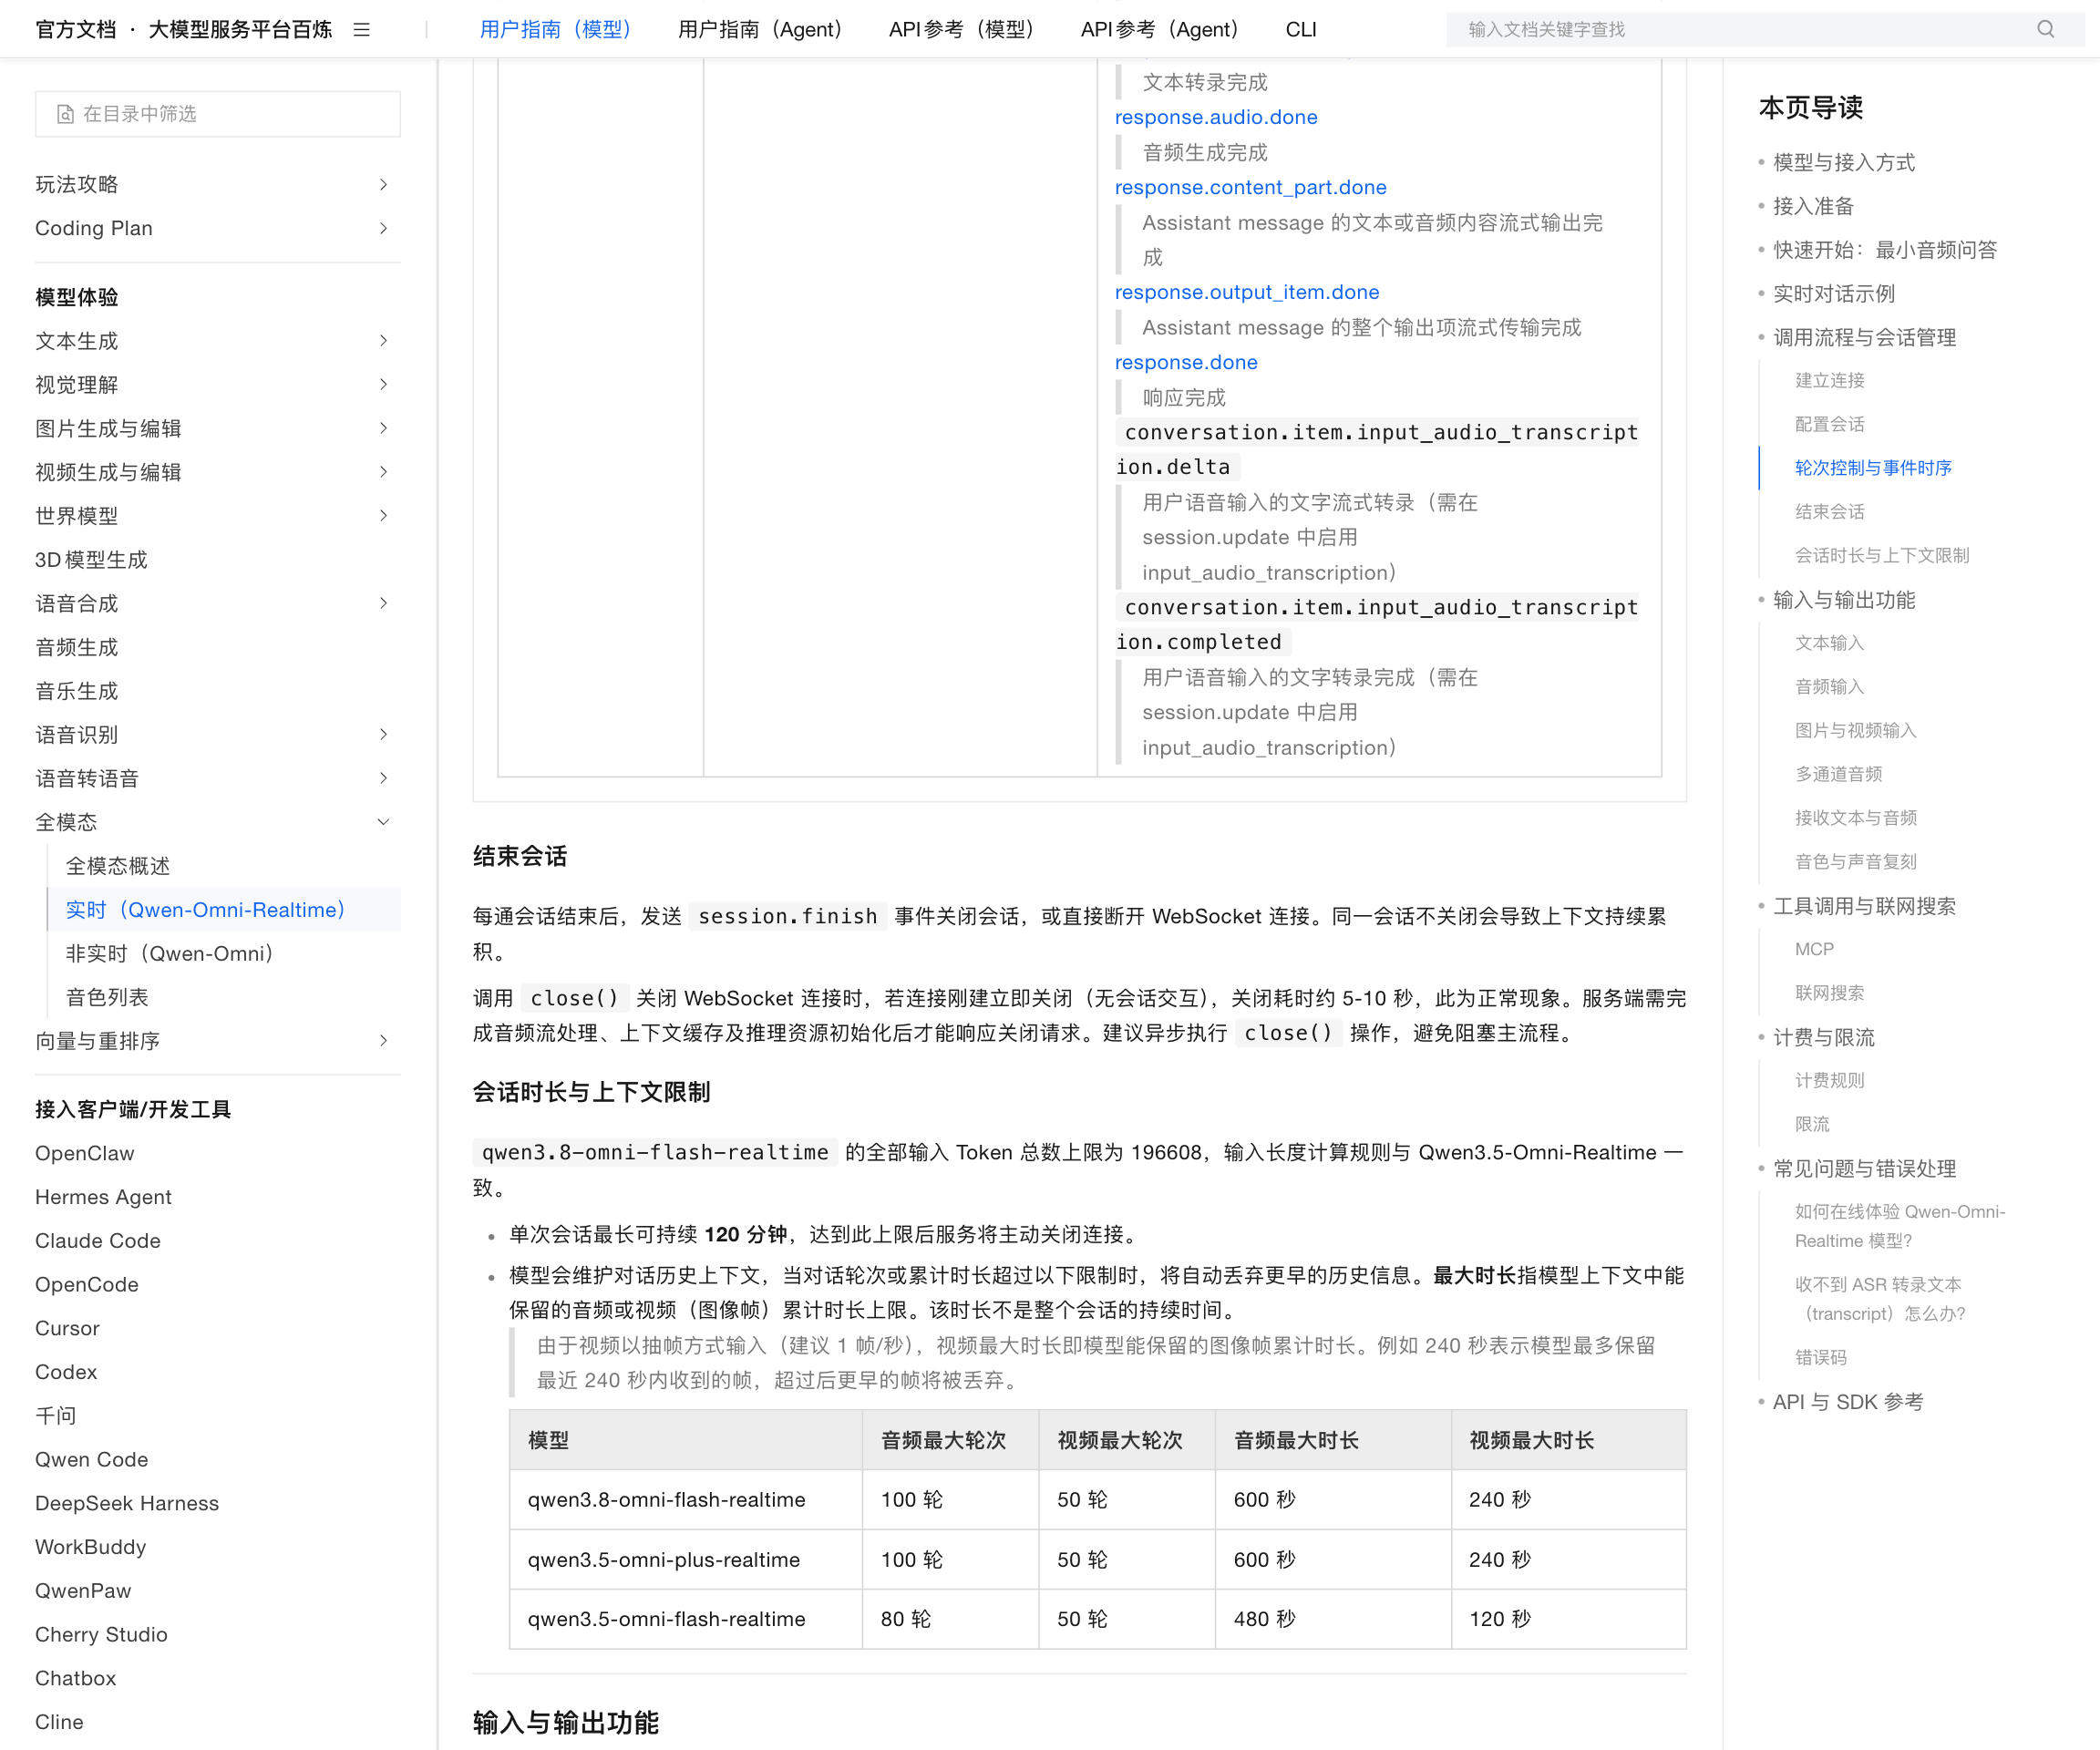
| 型号 | 音频最大轮次 | 视频最大轮次 | 音频最大时长 | 视频最大时长 |
|---|---|---|---|---|
| qwen3.8-omni-flash-realtime | 100 轮 | 50 轮 | 600 秒 | 240 秒 |
| qwen3.5-omni-plus-realtime | 100 轮 | 50 轮 | 600 秒 | 240 秒 |
| qwen3.5-omni-flash-realtime | 80 轮 | 50 轮 | 480 秒 | 120 秒 |
这张表是官方文档「会话时长与上下文限制」一节的原文数据。三点值得注意:
第一,Flash 和 Plus 的音频上限完全相同,但 Flash 的视频上限只有 Plus 的一半。 如果你的场景是摄像头视觉问答,用 3.5-plus 换来的是两倍的视觉记忆;如果只是纯语音,这两档没有区别。
第二,”最大时长”不是会话能开多久。 文档专门澄清了这个容易读错的地方:「最大时长」指模型上下文中能保留的音频或视频(图像帧)累计时长上限,该时长不是整个会话的持续时间。会话本身的硬上限是另一个数字——单次会话最长可持续 120 分钟,达到后服务将主动关闭连接。
第三,视频时长怎么算,取决于抽帧频率。 文档说明视频以抽帧方式输入(建议 1 帧/秒),因此「视频最大时长 240 秒」实际含义是模型最多保留最近 240 秒内收到的帧,超过后更早的帧将被丢弃。所以 240 秒不是 4 分钟视频,是 240 帧。
另外,qwen3.8-omni-flash-realtime 的全部输入 Token 总数上限为 196608,输入长度计算规则与 Qwen3.5-Omni-Realtime 一致。
二、最关键的一条:输入 Token 逐轮累积,不是只算新增
这是我认为整份文档里最该被单独拎出来讲的一句话,也是实时模型和站内其他百炼文章里所有按量接口最不一样的地方。
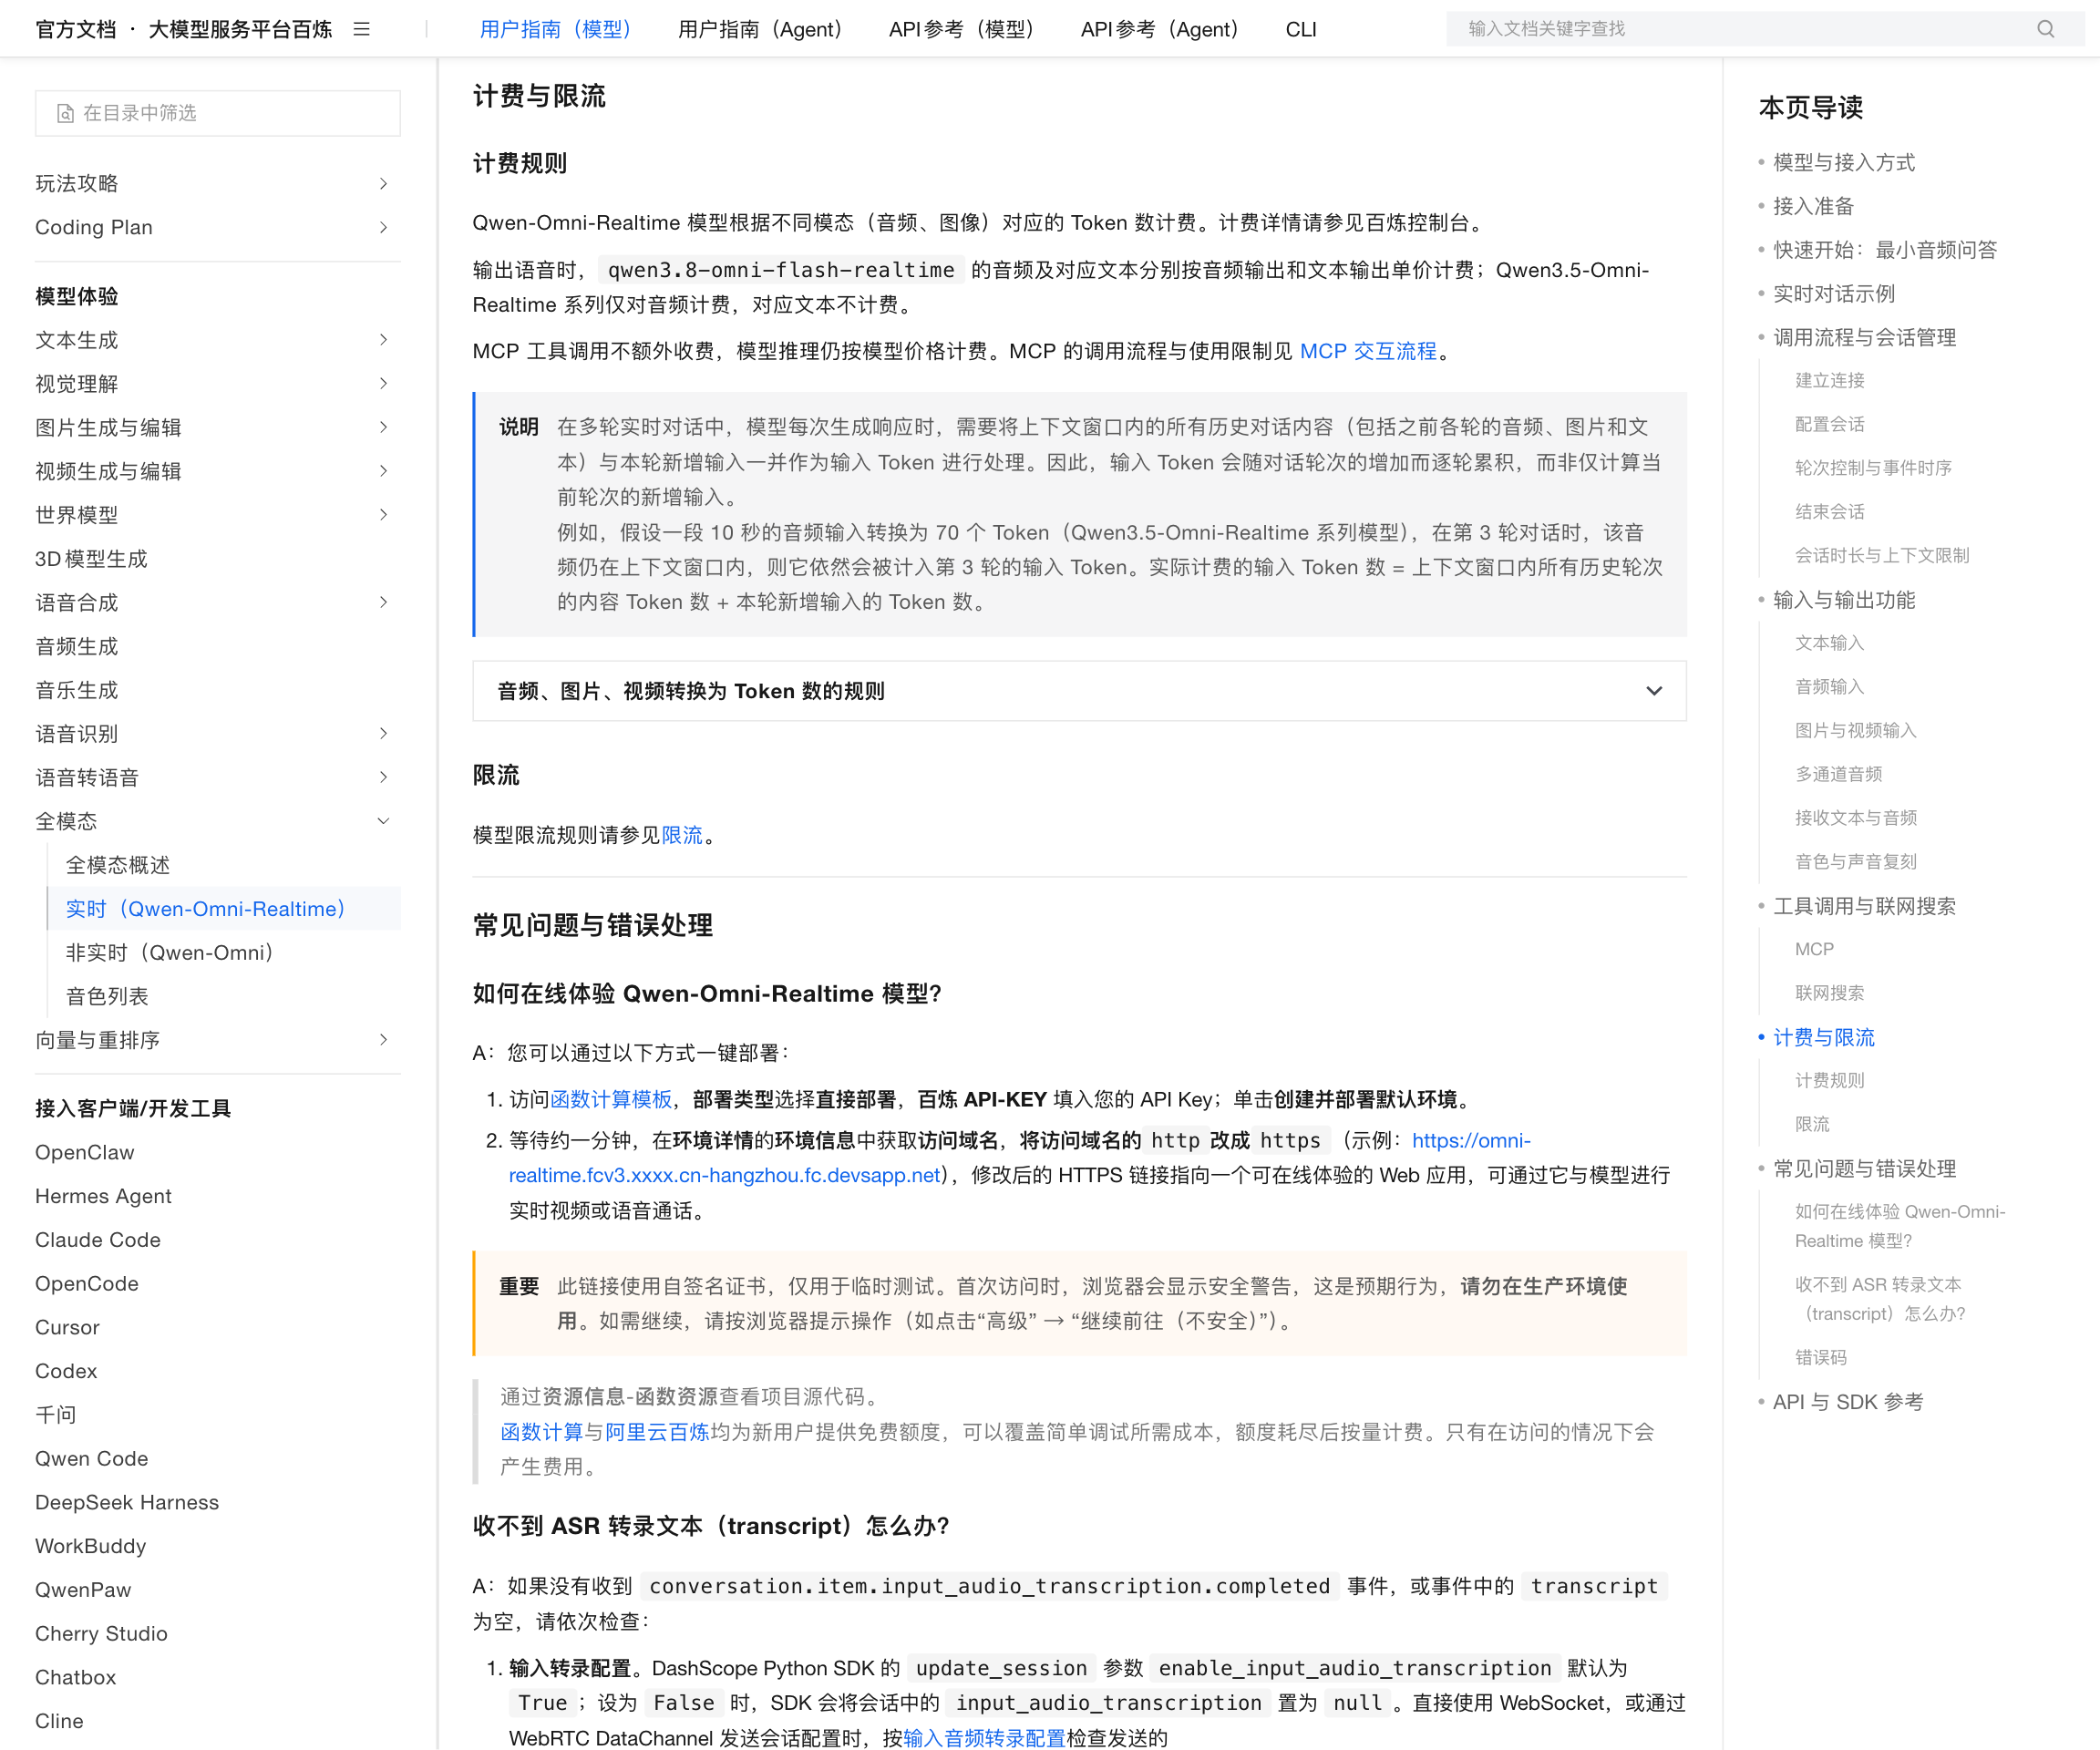
文档「计费规则」下的「说明」框原文写明:在多轮实时对话中,模型每次生成响应时,需要将上下文窗口内的所有历史对话内容(包括之前各轮的音频、图片和文本)与本轮新增输入一并作为输入 Token 进行处理。因此,输入 Token 会随对话轮次的增加而逐轮累积,而非仅计算当前轮次的新增输入。
文档还给了一个具体的算例:假设一段 10 秒的音频输入转换为 70 个 Token(Qwen3.5-Omni-Realtime 系列模型),在第 3 轮对话时,该音频仍在上下文窗口内,则它依然会被计入第 3 轮的输入 Token。
于是实际计费的输入 Token 数 = 上下文窗口内所有历史轮次的内容 Token 数 + 本轮新增输入的 Token 数。
把这个算例外推一下就很直观。10 秒音频 = 70 Token,做一场 20 轮、平均每轮 10 秒的语音对话:
- 总输入音频约 1400 Token
- 但计费的输入 Token 总量是 70 + 140 + 210 + … + 1400,约 15400 Token
- 放大倍数超过 10 倍
这个放大效应在长会话里会更陡。第 80 轮时,同样一段 10 秒音频已经被重复计费 80 次。
这也解释了文档为什么把音频最大时长限制在 480~600 秒——上下文保留上限本身就是成本控制手段。超过上限后更早的内容被丢弃,反而让计费输入量停止增长。
如果你需要对照其他百炼接口的计费口径,可以看站内这篇 百炼上下文缓存实测:显式缓存命中率会显著改变输入 Token 的单价,而实时模型这条文档里没有提到任何缓存机制。
三、音频、图像、视频怎么折算成 Token
计费既然按 Token 走,转换规则就是成本估算的基础。文档给的是硬公式。
| 模态 | 适用型号 | 计算公式 |
|---|---|---|
| 输入音频 | Qwen3.8-Omni-Flash-Realtime、Qwen3.5-Omni-Realtime 系列 | 总 Token 数 = 音频时长(秒)× 7 |
| 输出音频 | Qwen3.8-Omni-Flash-Realtime、Qwen3.5-Omni-Realtime 系列 | 总 Token 数 = 音频时长(秒)× 12.5 |
| 输入与输出音频 | qwen3-omni-flash-realtime-2025-09-15 | 均为 总 Token 数 = 音频时长(秒)× 12.5 |
| 图片 | 上述三个型号一致 | 每 32×32 像素对应 1 个 Token |
| 视频 | 同上 | 建议 1 帧/秒,按帧数计入图像 Token |
两个容易被忽略的细节:
输出音频的单价倍率明显高于输入。 输入是每秒 7 个 Token,输出是每秒 12.5 个。模型说得越多、说得越长,输出侧 Token 涨得比输入快。这个差异在长时间语音播报类场景里比输入侧累积更值得先算一遍。
音频不足 1 秒按 1 秒计算。 文档写明「若音频时长不足 1 秒,则按 1 秒计算」。短促的确认音「嗯」「对」不会因此变成零成本。
把上面的公式和累积规则放在一起,可以得到一张粗略的成本对照表。下表按「一轮 10 秒音频、输出 10 秒语音」的假设,估算单个型号单轮的 Token 产出量(不含历史累积),用来感受量级:
| 项目 | Token 计算 | 单轮数量 | 备注 |
|---|---|---|---|
| 输入音频 | 10 秒 × 7 | 70 | 官方算例给出的数值 |
| 输出音频 | 10 秒 × 12.5 | 125 | 单价为输入侧的约 1.8 倍 |
| 输入 + 输出小计 | 70 + 125 | 195 | 未含历史轮次累积 |
| 开启空间音频后输入 | 70 × 2 | 140 | 仅 Qwen3.8-Omni-Flash-Realtime |
| 一张 512×512 图 | (512/32) × (512/32) | 256 | 每 32×32 像素 1 个 Token |
图片那一行可以解释前面提到的上下限:512×512 的方图正好落在 4~1280 个 Token 的区间内,而一张远超此尺寸的照片会被截断到 1280 的上限。
图片方面,每张图最少 4 个 Token,最多支持 1280 个 Token——上下限差 320 倍,所以图片分辨率对成本的影响是实打实的,一张高分辨率截图和多一个小图标可能差出一两个数量级。
还有一个只在 qwen3.8-omni-flash-realtime 上存在的规则:开启空间音频输入时,音频输入 Token 数为普通音频的 2 倍,2 通道和 4 通道的倍数相同。换句话说,如果你为了降噪或方向性采集而上了多通道阵列,输入侧 Token 直接翻倍。
四、输出语音时,两个系列只有一半要计费
计费规则里还有一条不对称的优惠,文档写得比较靠后,很容易被略过:
输出语音时,qwen3.8-omni-flash-realtime 的音频及对应文本分别按音频输出和文本输出单价计费;Qwen3.5-Omni-Realtime 系列仅对音频计费,对应文本不计费。
也就是说,同样输出语音,3.8 系列要为音频和转写文本付两份钱,3.5 系列只付音频这一份。这解释了为什么 3.8 虽然更新、上下文更大,语音场景下未必比 3.5-plus 更划算。
另外,MCP 工具调用不额外收费,模型推理仍按模型价格计费——工具本身免费,推理不免费。
五、三种协议怎么选,AOQ 是个容易被跳过的选项
Qwen-Omni-Realtime 支持 WebSocket、WebRTC 和 AOQ 三种协议接入,文档对三者的定位写得很清楚:
- WebSocket:适合服务端集成和快速接入
- WebRTC:适合浏览器端、低延迟语音场景,音频通过 UDP 直接传输,内置回声消除和降噪
- AOQ:如果是客户端对接,且更看重稳定的延迟、弱网下的交互能力、实时双工的降噪与回声消除,可优先考虑 AOQ
多数教程只讲前两个。但按官方自己的描述,AOQ 恰恰是唯一正面解决「弱网」和「双工降噪回声消除」的选项,而这两项恰恰是实时语音在真实网络环境里最容易翻车的地方。
接入地址需要绑定业务空间 ID,qwen3.8-omni-flash-realtime 必须使用绑定业务空间的调用地址:
- WebSocket(华北 2 北京):
wss://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/api-ws/v1/realtime - WebSocket(新加坡):
wss://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api-ws/v1/realtime - WebRTC:
POST https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/api/v1/webrtc/realtime,Content-Type 为application/sdp,请求体是客户端生成的 Offer SDP,响应成功时 HTTP 200 返回服务端 Answer SDP,失败返回 HTTP 4xx 加 JSON 错误信息
音频输出方式的差异也很实际:WebSocket 下音频通过 response.audio.delta 事件获取 Base64 编码数据;WebRTC 下音频通过 RTP 轨道实时接收和播放,无需走事件。选 WebRTC 就能省掉 Base64 编解码和一大段缓冲逻辑。
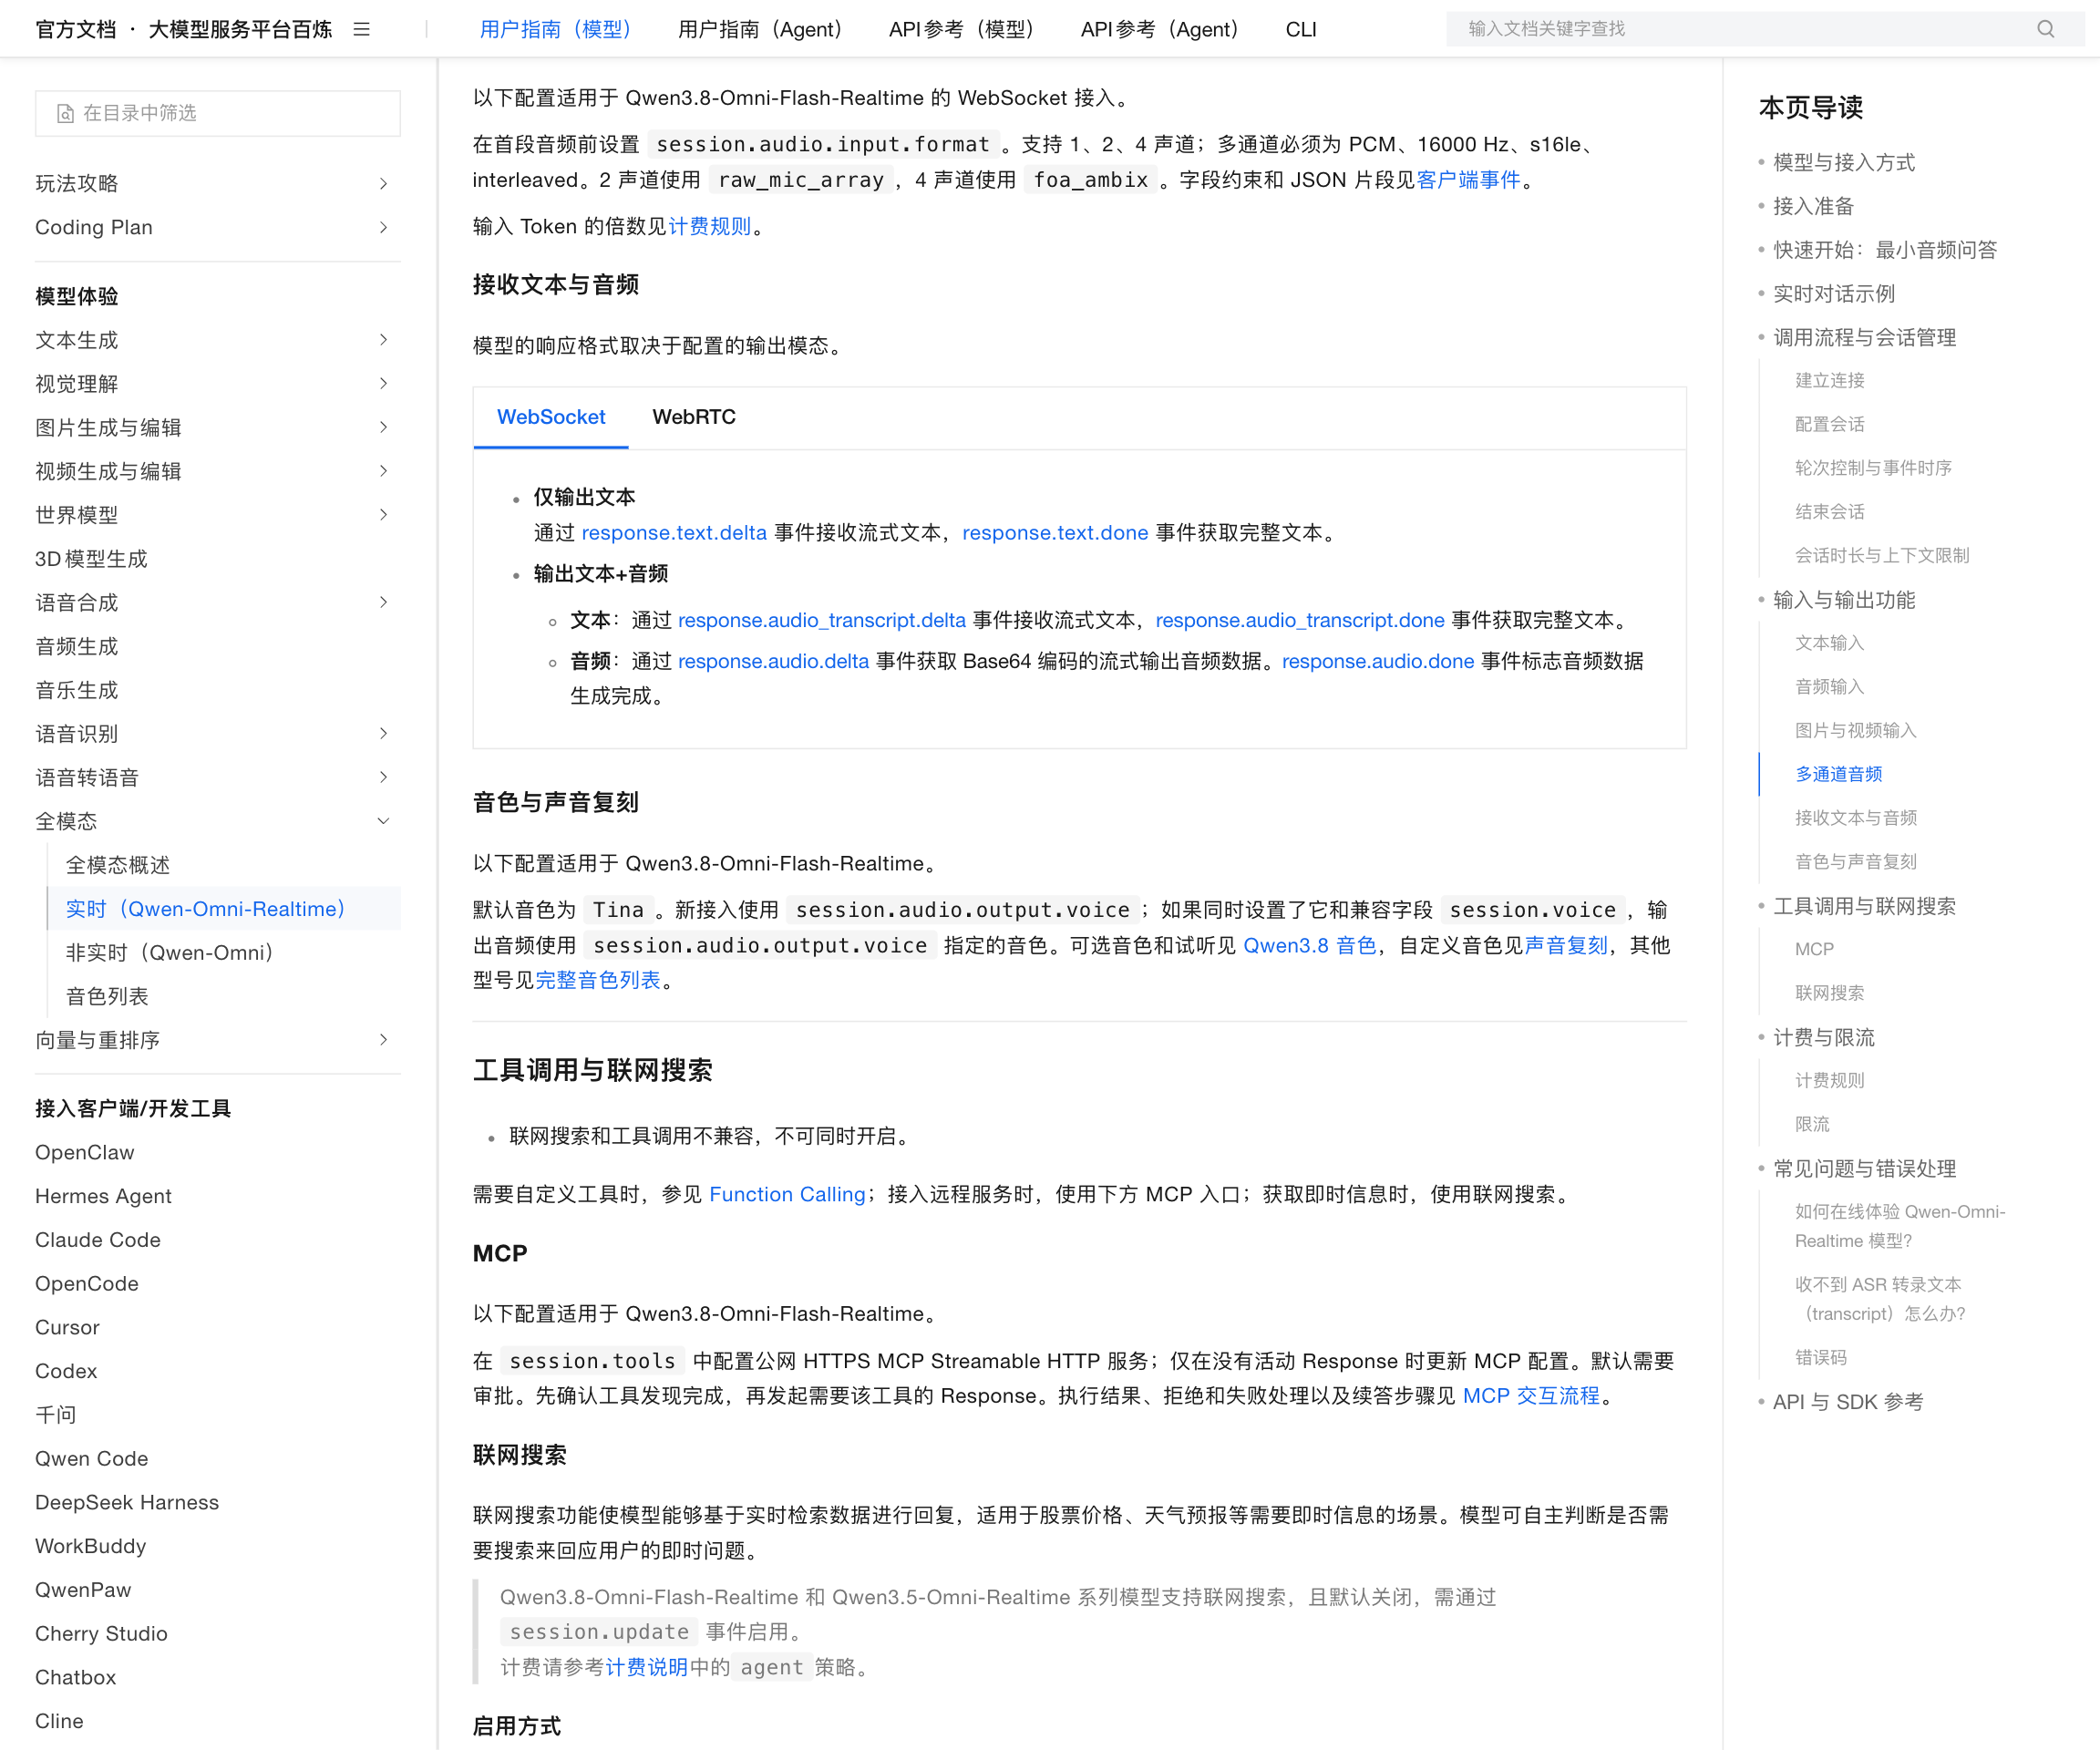
六、工具调用和联网搜索,二选一
文档在「工具调用与联网搜索」小节的第一句就写明:联网搜索和工具调用不兼容,不可同时开启。
需要自定义工具时参见 Function Calling;接入远程服务时使用 MCP 入口;获取即时信息时使用联网搜索。这是一条硬约束,不是配置建议。
MCP 的配置有三个额外限制,文档标注「以下配置适用于 Qwen3.8-Omni-Flash-Realtime」:在 session.tools 中配置公网 HTTPS MCP Streamable HTTP 服务;仅在没有活动 Response 时更新 MCP 配置;默认需要审批。先确认工具发现完成,再发起需要该工具的 Response。
联网搜索则默认关闭,需通过 session.update 事件启用,参数为 enable_search(设为 true)以及 search_options.enable_source(设为 true 返回搜索结果来源列表)。Qwen3.8-Omni-Flash-Realtime 和 Qwen3.5-Omni-Realtime 系列模型支持联网搜索。
关于实时模型的工具调用与站内既有文章的对照,可以参考 百炼 Function Calling 工具选择矩阵实测;实时场景下的联网搜索计量会出现在 response.done 的 usage.plugins.search 里,含 count 和 strategy 字段,官方示例中 strategy 为 agent。
七、多通道音频和音色,一个只对新型号开放
多通道音频部分文档同样标注「以下配置适用于 Qwen3.8-Omni-Flash-Realtime 的 WebSocket 接入」。在首段音频前设置 session.audio.input.format,支持 1、2、4 声道;多通道必须为 PCM、16000 Hz、s16le、interleaved。2 声道使用 raw_mic_array,4 声道使用 foa_ambix。
音色方面,文档写明「以下配置适用于 Qwen3.8-Omni-Flash-Realtime」。默认音色为 Tina。新接入使用 session.audio.output.voice;如果同时设置了它和兼容字段 session.voice,输出音频使用 session.audio.output.voice 指定的音色。
这个优先级关系写得很明确,但实际接入时两个字段都填、后填的覆盖前面的开发者不在少数——按文档规则,新字段优先。
模型支持语音方面,文档在首页能力列表写明支持 113 种语种和方言的语音识别,以及 36 种语种和方言的语音合成。识别与合成的语种覆盖并不相同,这一差异文档没有进一步解释。
八、两个容易踩的坑:关闭会话和 ASR 转录
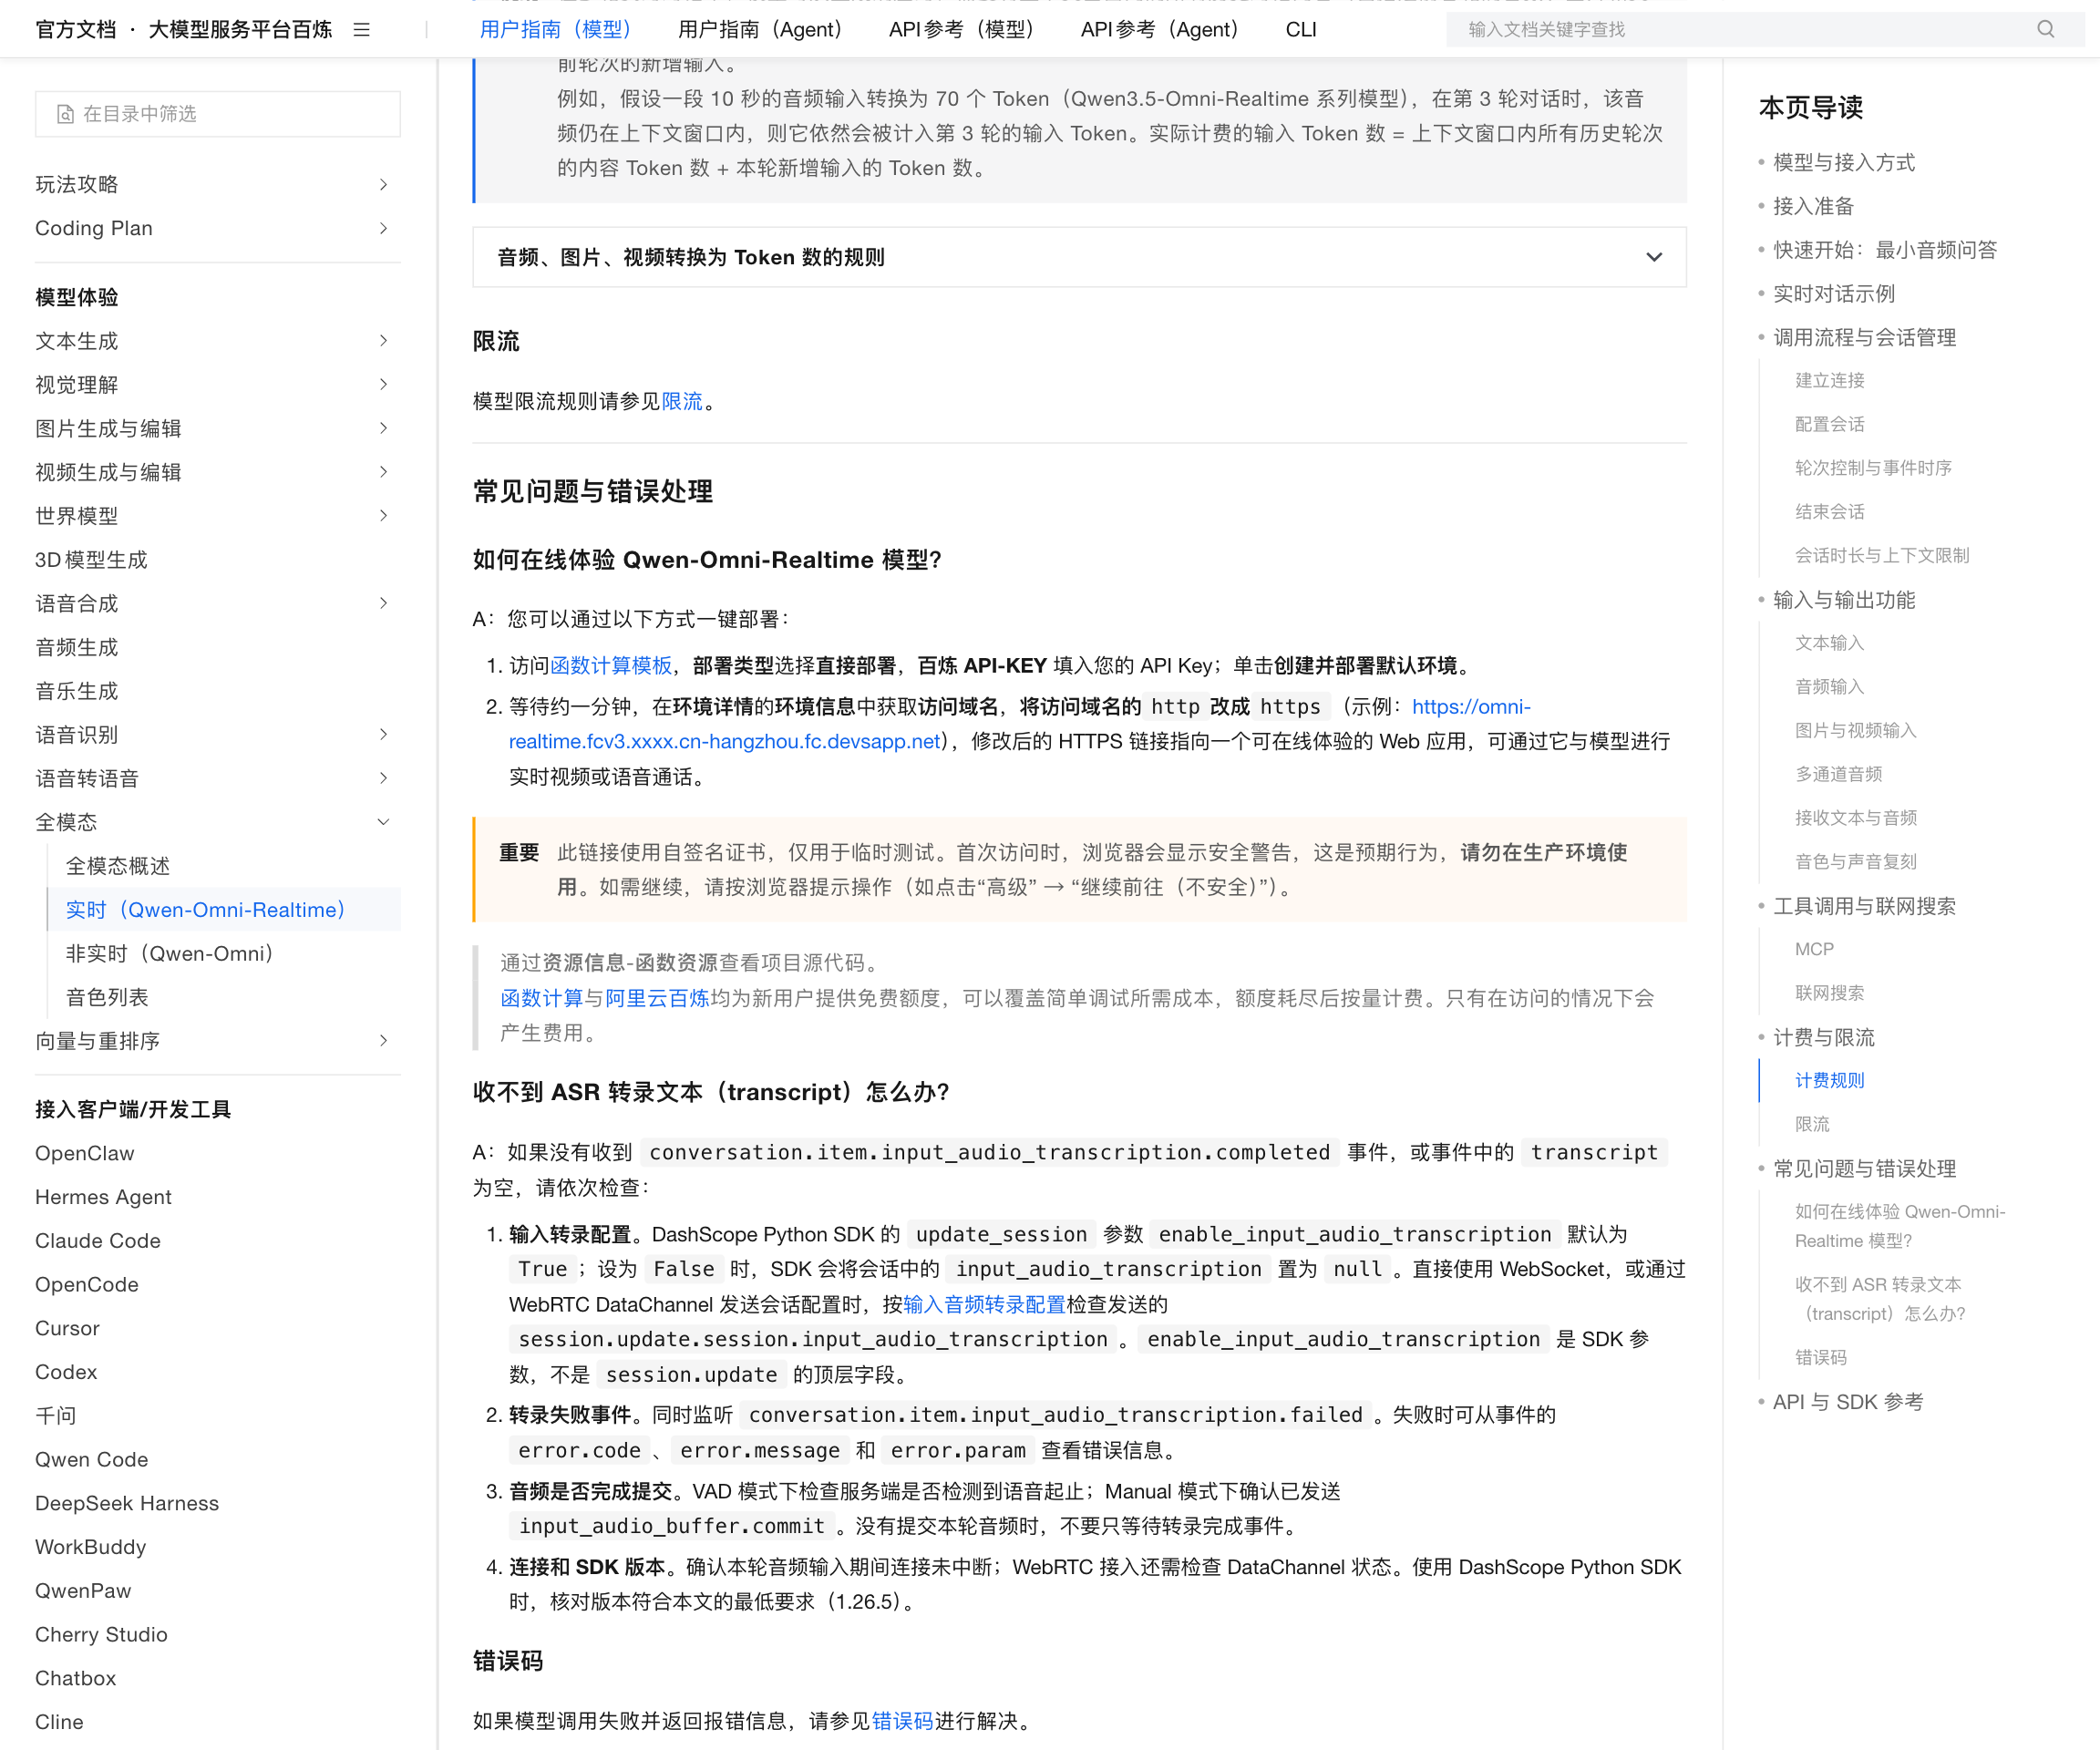
坑一:不关闭会话,上下文会一直累积。 文档在「结束会话」一节写明:每通会话结束后,发送 session.finish 事件关闭会话,或直接断开 WebSocket 连接。同一会话不关闭会导致上下文持续累积。
还有一个反直觉的表现:调用 close() 关闭 WebSocket 连接时,若连接刚建立即关闭(无会话交互),关闭耗时约 5-10 秒,此为正常现象。服务端需完成音频流处理、上下文缓存及推理资源初始化后才能响应关闭请求。文档建议异步执行 close() 操作,避免阻塞主流程。
新手往往会把「刚建连就断开要等 5-10 秒」当成 bug,实际是资源初始化的正常开销。
坑二:收不到 ASR 转录文本,文档给了四步排查顺序。
如果没收到 conversation.item.input_audio_transcription.completed 事件,或事件中的 transcript 为空,依次检查:
- 输入转录配置。DashScope Python SDK 的
update_session参数enable_input_audio_transcription默认为True;设为False时,SDK 会将会话中的input_audio_transcription置为null。文档特别指出:enable_input_audio_transcription是 SDK 参数,不是session.update的顶层字段。 - 转录失败事件。同时监听
conversation.item.input_audio_transcription.failed,失败时可从事件的error.code、error.message和error.param查看错误信息。 - 音频是否完成提交。VAD 模式下检查服务端是否检测到语音起止;Manual 模式下确认已发送
input_audio_buffer.commit。文档特别提醒:没有提交本轮音频时,不要只等待转录完成事件。 - 连接和 SDK 版本。确认本轮音频输入期间连接未中断;WebRTC 接入还需检查 DataChannel 状态。使用 DashScope Python SDK 时,核对版本符合本文的最低要求(1.26.5)。
第 1 条的「SDK 参数不是 session.update 顶层字段」是最容易踩的一个:直接在 WebSocket 报文顶层写 enable_input_audio_transcription 不会生效,字段层级错了。
关于错误码本身,实时模型没有独立的错误码页,文档直接指向百炼通用的错误码文档,站内这篇 百炼错误码 128 组跨状态码冲突实测 可以对照看。
九、在线体验用的是自签名证书,别搬进生产
文档给了一个不依赖本地环境的在线体验方式:访问函数计算模板,部署后等待约一分钟,在环境详情的环境信息中获取访问域名,把访问域名的 http 改成 https,修改后的 HTTPS 链接指向一个可在线体验的 Web 应用。
但文档紧接着给了黄色警示框,原文是:
重要:此链接使用自签名证书,仅用于临时测试。首次访问时,浏览器会显示安全警告,这是预期行为,请勿在生产环境使用。如需继续,请按浏览器提示操作(如点击”高级” → “继续前往(不安全)”)。
看到浏览器安全警告时不要以为是环境坏了,也不要把跳过警告的操作搬进生产链路。
计费方面文档说明:函数计算与阿里云百炼均为新用户提供免费额度,可以覆盖简单调试所需成本,额度耗尽后按量计费。只有在访问的情况下会产生费用。
「只有在访问的情况下会产生费用」值得展开:纯挂着的空闲会话,如果模型没有生成响应,是否仍在持续计费,文档没有明确说明。这一条属于官方未展开的边界,不做推断。
十、迁移文档中的两个版本号差异
文档「API 与 SDK 参考」一节把实时模型的参考链接全部外链,没有给出内联的完整参数表,而是指向 Realtime API 概述(WebRTC 协议说明)、客户端事件、服务端事件、Python SDK、Java SDK 等页面。
这意味着实时模型的参数细节分散在多个文档页里。站内此前的百炼文章多数基于单页文档解析,实时这一块需要跨页对照。限流条件也要单独查 百炼限流说明,本文只引用本文档明确写出的上下文上限,不做推算。
十、写在最后:三个最容易踩的点
把三个最容易踩的点归纳一下:
- 输入 Token 逐轮累积,长会话的实际输入成本可能是音频总量的 10 倍以上,估算时必须按轮次加权。
- 上下文上限本身就是成本闸门,音频 480~600 秒、视频 120~240 秒的限制会直接决定你的会话设计上限。
- 输出音频 Token 单价(每秒 12.5)明显高于输入(每秒 7),而 3.5 系列输出语音时对应文本不计费——型号选择本身就是一道成本决策。
实时模型这一条线目前文档仍在快速迭代(本文抓取时更新时间 2026-10-16),上述数字建议以官方文档当前版本为准。站内关于百炼限流全表的实测可以看这篇 百炼限流 500 倍 RPM 差距实测。
信息来源与核对说明
- 本文数据来源:阿里云百炼官方文档《Qwen-Omni-Realtime》,实测抓取时间 2026-10-19 12:03–12:07(Asia/Shanghai),页面标注更新时间 2026-10-16 11:58:08。
- 型号上下文上限、Token 换算公式、协议地址、FAQ 排查步骤均为该页原文,未做换算或改写。
- 配图 5 张均为该文档页面的实际截图,未使用任何示意图或占位图。
- 限流、错误码、Function Calling 等内容本文只引用不展开,站内另有专门实测文章,链接见正文。
- 本文涉及的音频单价、额度与商业条款以百炼控制台当前展示为准,本文不复述控制台报价。
UNKNOWN(官方文档未明确,不做推断)
- UNKNOWN:空闲挂起、不产生响应的会话是否持续计费——文档只写「只有在访问的情况下会产生费用」,未区分产生响应与否
- UNKNOWN:识别支持 113 种语种、合成为 36 种语种,两者范围差异的原因——文档并列列出,未解释
- UNKNOWN:「限流」小节仅指向独立页面,实时模型的并发与 RPM 具体数值——不在本文档内,本文不做推算
- UNKNOWN:搜索计量
strategy=agent是否有其他取值及其触发条件——官方示例只出现这一个值 - UNKNOWN:上下文丢弃更早历史时,是否有对应的费用调整说明——只写了丢弃行为,未写计费联动
- UNKNOWN:三个型号的具体音频/文本报价——本文只复述换算公式,未引用控制台价格
- UNKNOWN:qwen3-omni-flash-realtime-2025-09-15 的会话时长与上下文上限——旧型号未列入本文第一节表格
- UNKNOWN:
session.audio.output.voice与兼容字段session.voice同时设置时,旧客户端是否一律按新字段解析——文档只给出新字段优先的规则,未说明旧客户端行为 - UNKNOWN:MCP 工具「默认需要审批」的具体审批交互形态与超时行为——只说明需审批并指向独立的 MCP 交互流程文档