百炼上下文缓存实测:显式缓存创建要付 125% 的”预付费”,同一个模型换个缓存模式,单价能差 25 倍
一、缓存不是折扣,是先加价再打折
大多数人对”上下文缓存”的印象来自一句话:命中缓存的输入 Token 更便宜。这句话没错,但它省略了决定账单的那一半。
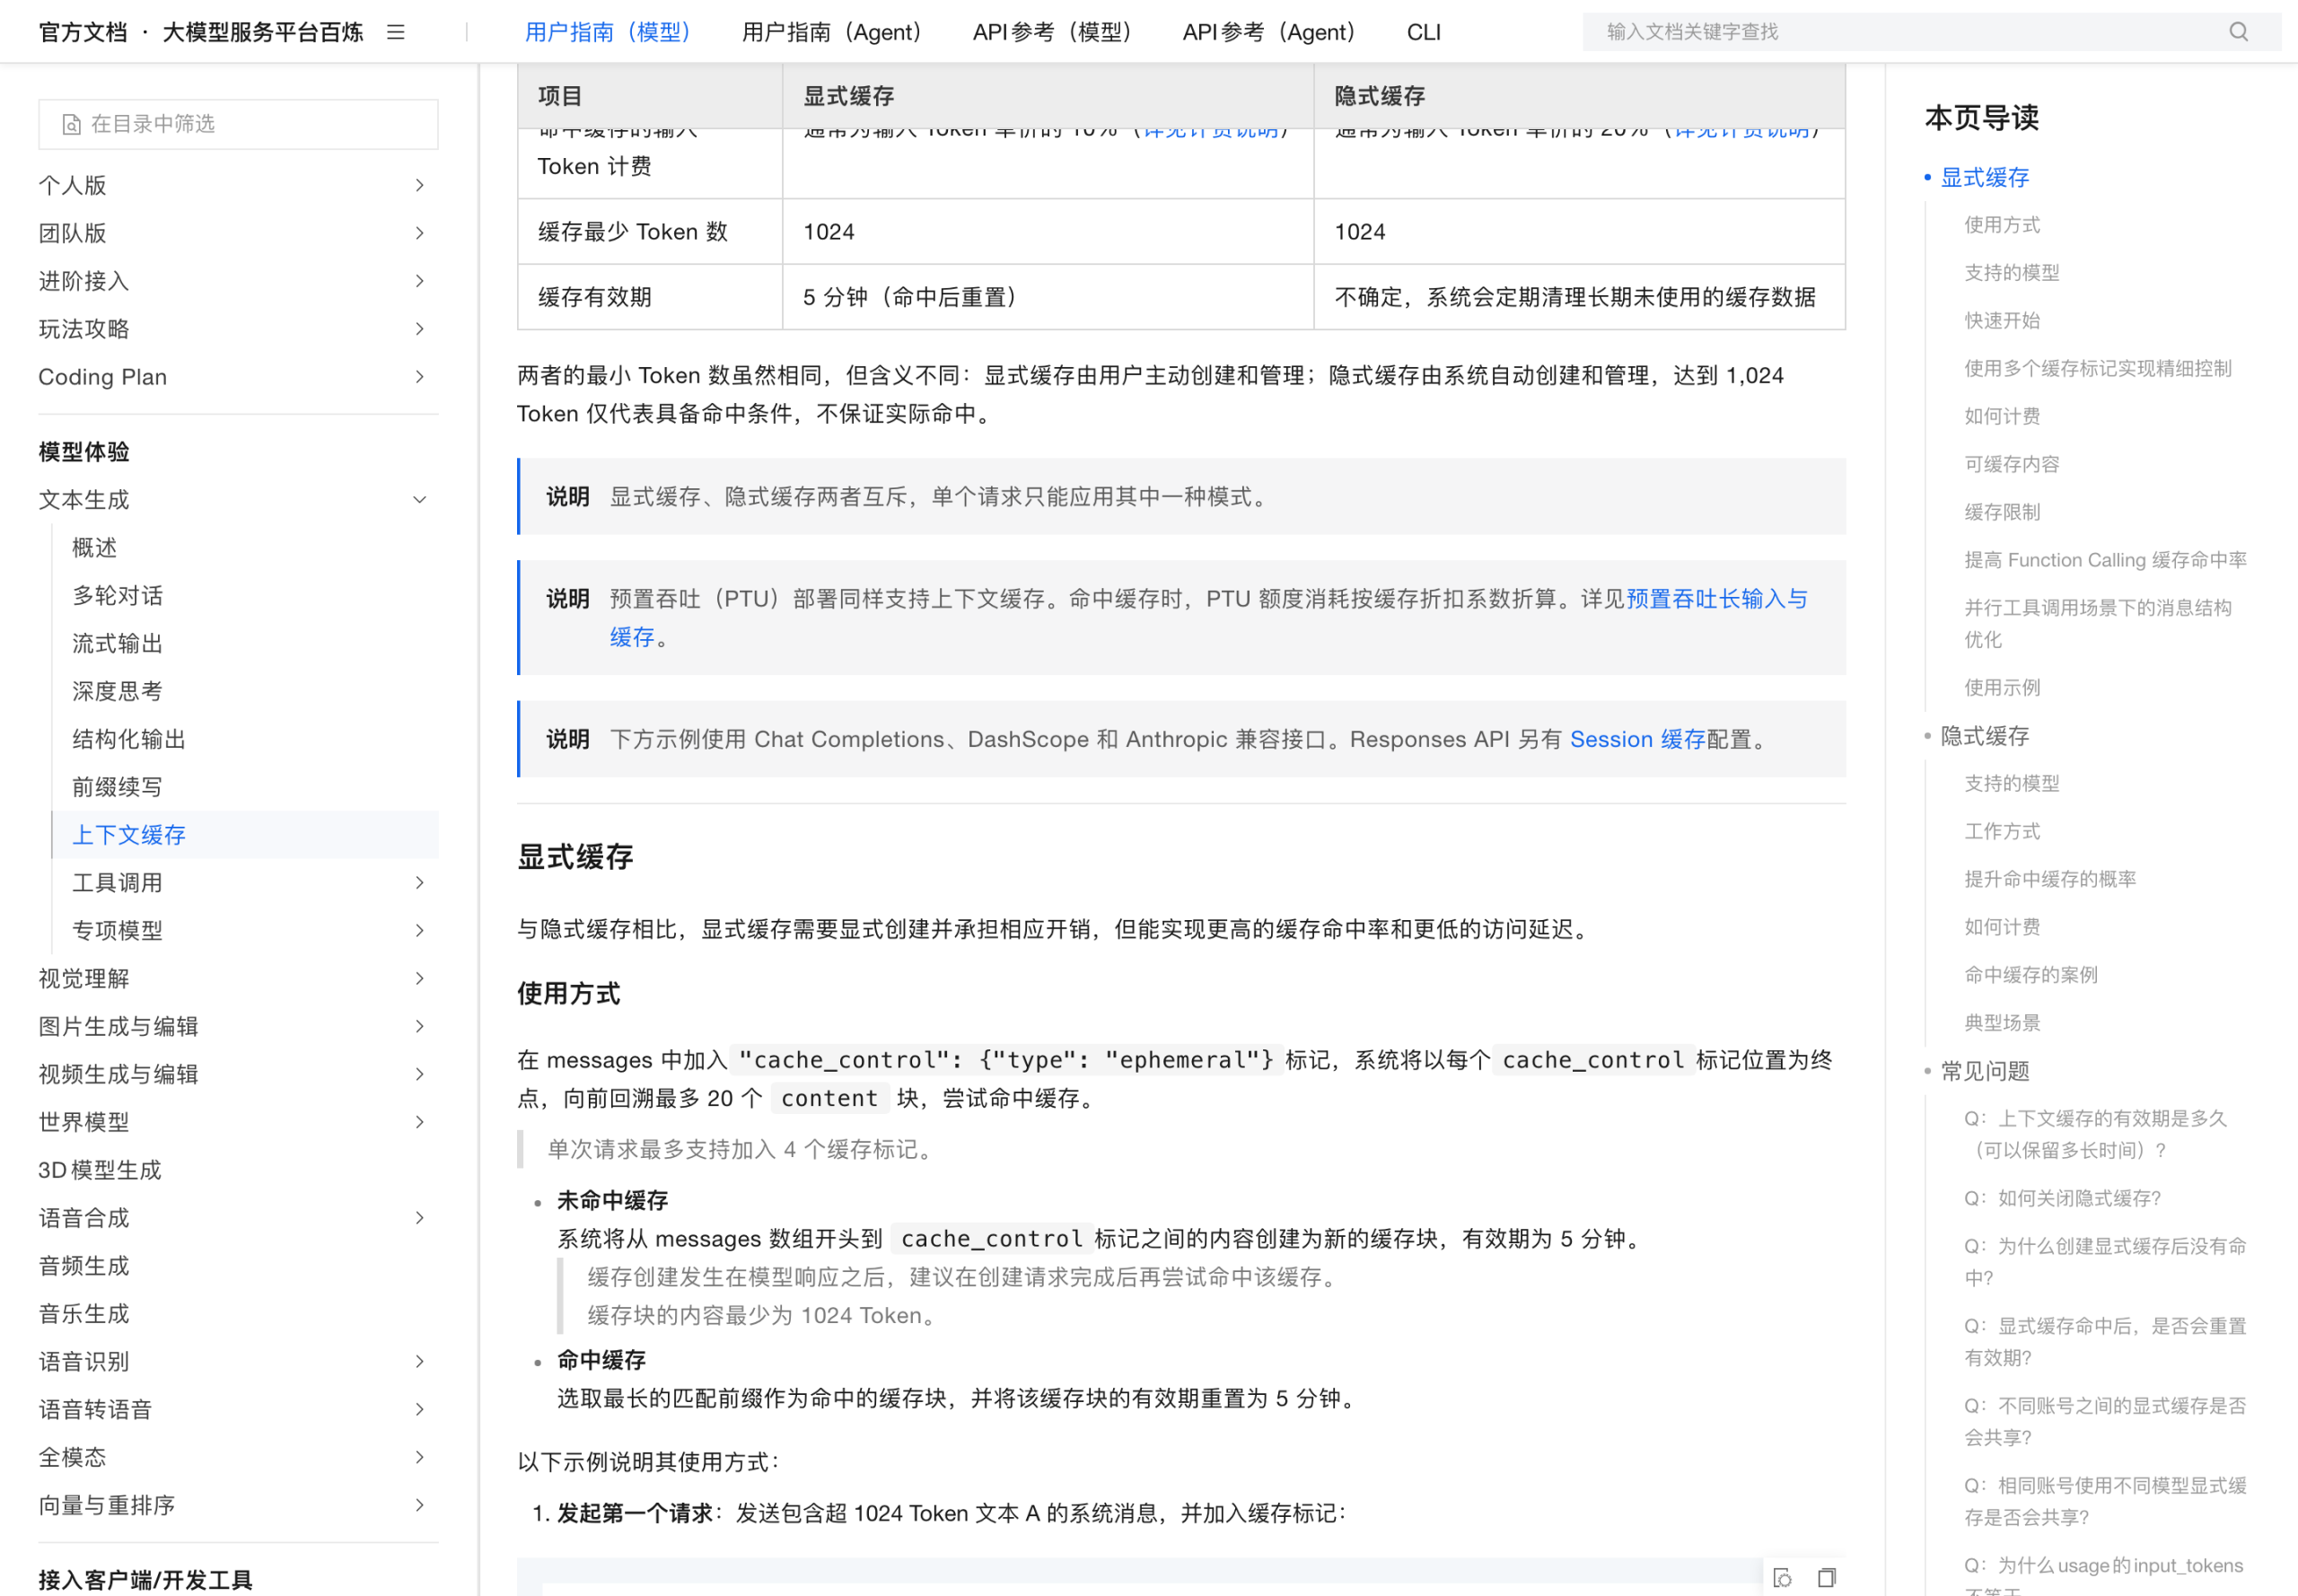
阿里云百炼《上下文缓存》文档在两种工作模式之间划了一条线(采集时间 2026-10-17 12:05,页面 HTTP 200 / 48,858 B):
| 项目 | 显式缓存 | 隐式缓存 |
|---|---|---|
| 是否影响回复效果 | 不影响 | 不影响 |
| 用于创建缓存 Token 计费 | 通常为输入 Token 单价的 125% | 输入 Token 单价的 100% |
| 命中缓存的输入 Token 计费 | 通常为输入 Token 单价的 10% | 通常为输入 Token 单价的 20% |
| 缓存最少 Token 数 | 1024 | 1024 |
| 缓存有效期 | 5 分钟(命中后重置) | 不确定,系统会定期清理长期未使用的缓存数据 |
| 是否可关闭 | 可(不标记即不创建) | 无法关闭 |
关键差异在第二行:显式缓存先按 125% 收你一次钱建立缓存,之后每次命中才回落到 10%。这在所有主流大模型厂商的缓存策略里都不常见——大多数厂商要么只做隐式折扣,要么对创建缓存本身不额外加价。百炼是少数把”建立缓存”明确标价为一笔 25% 溢价成本的产品。
文档同时点明两种模式互斥:单个请求只能应用其中一种。
二、显式缓存的实际账:第 2 次调用才开始回本
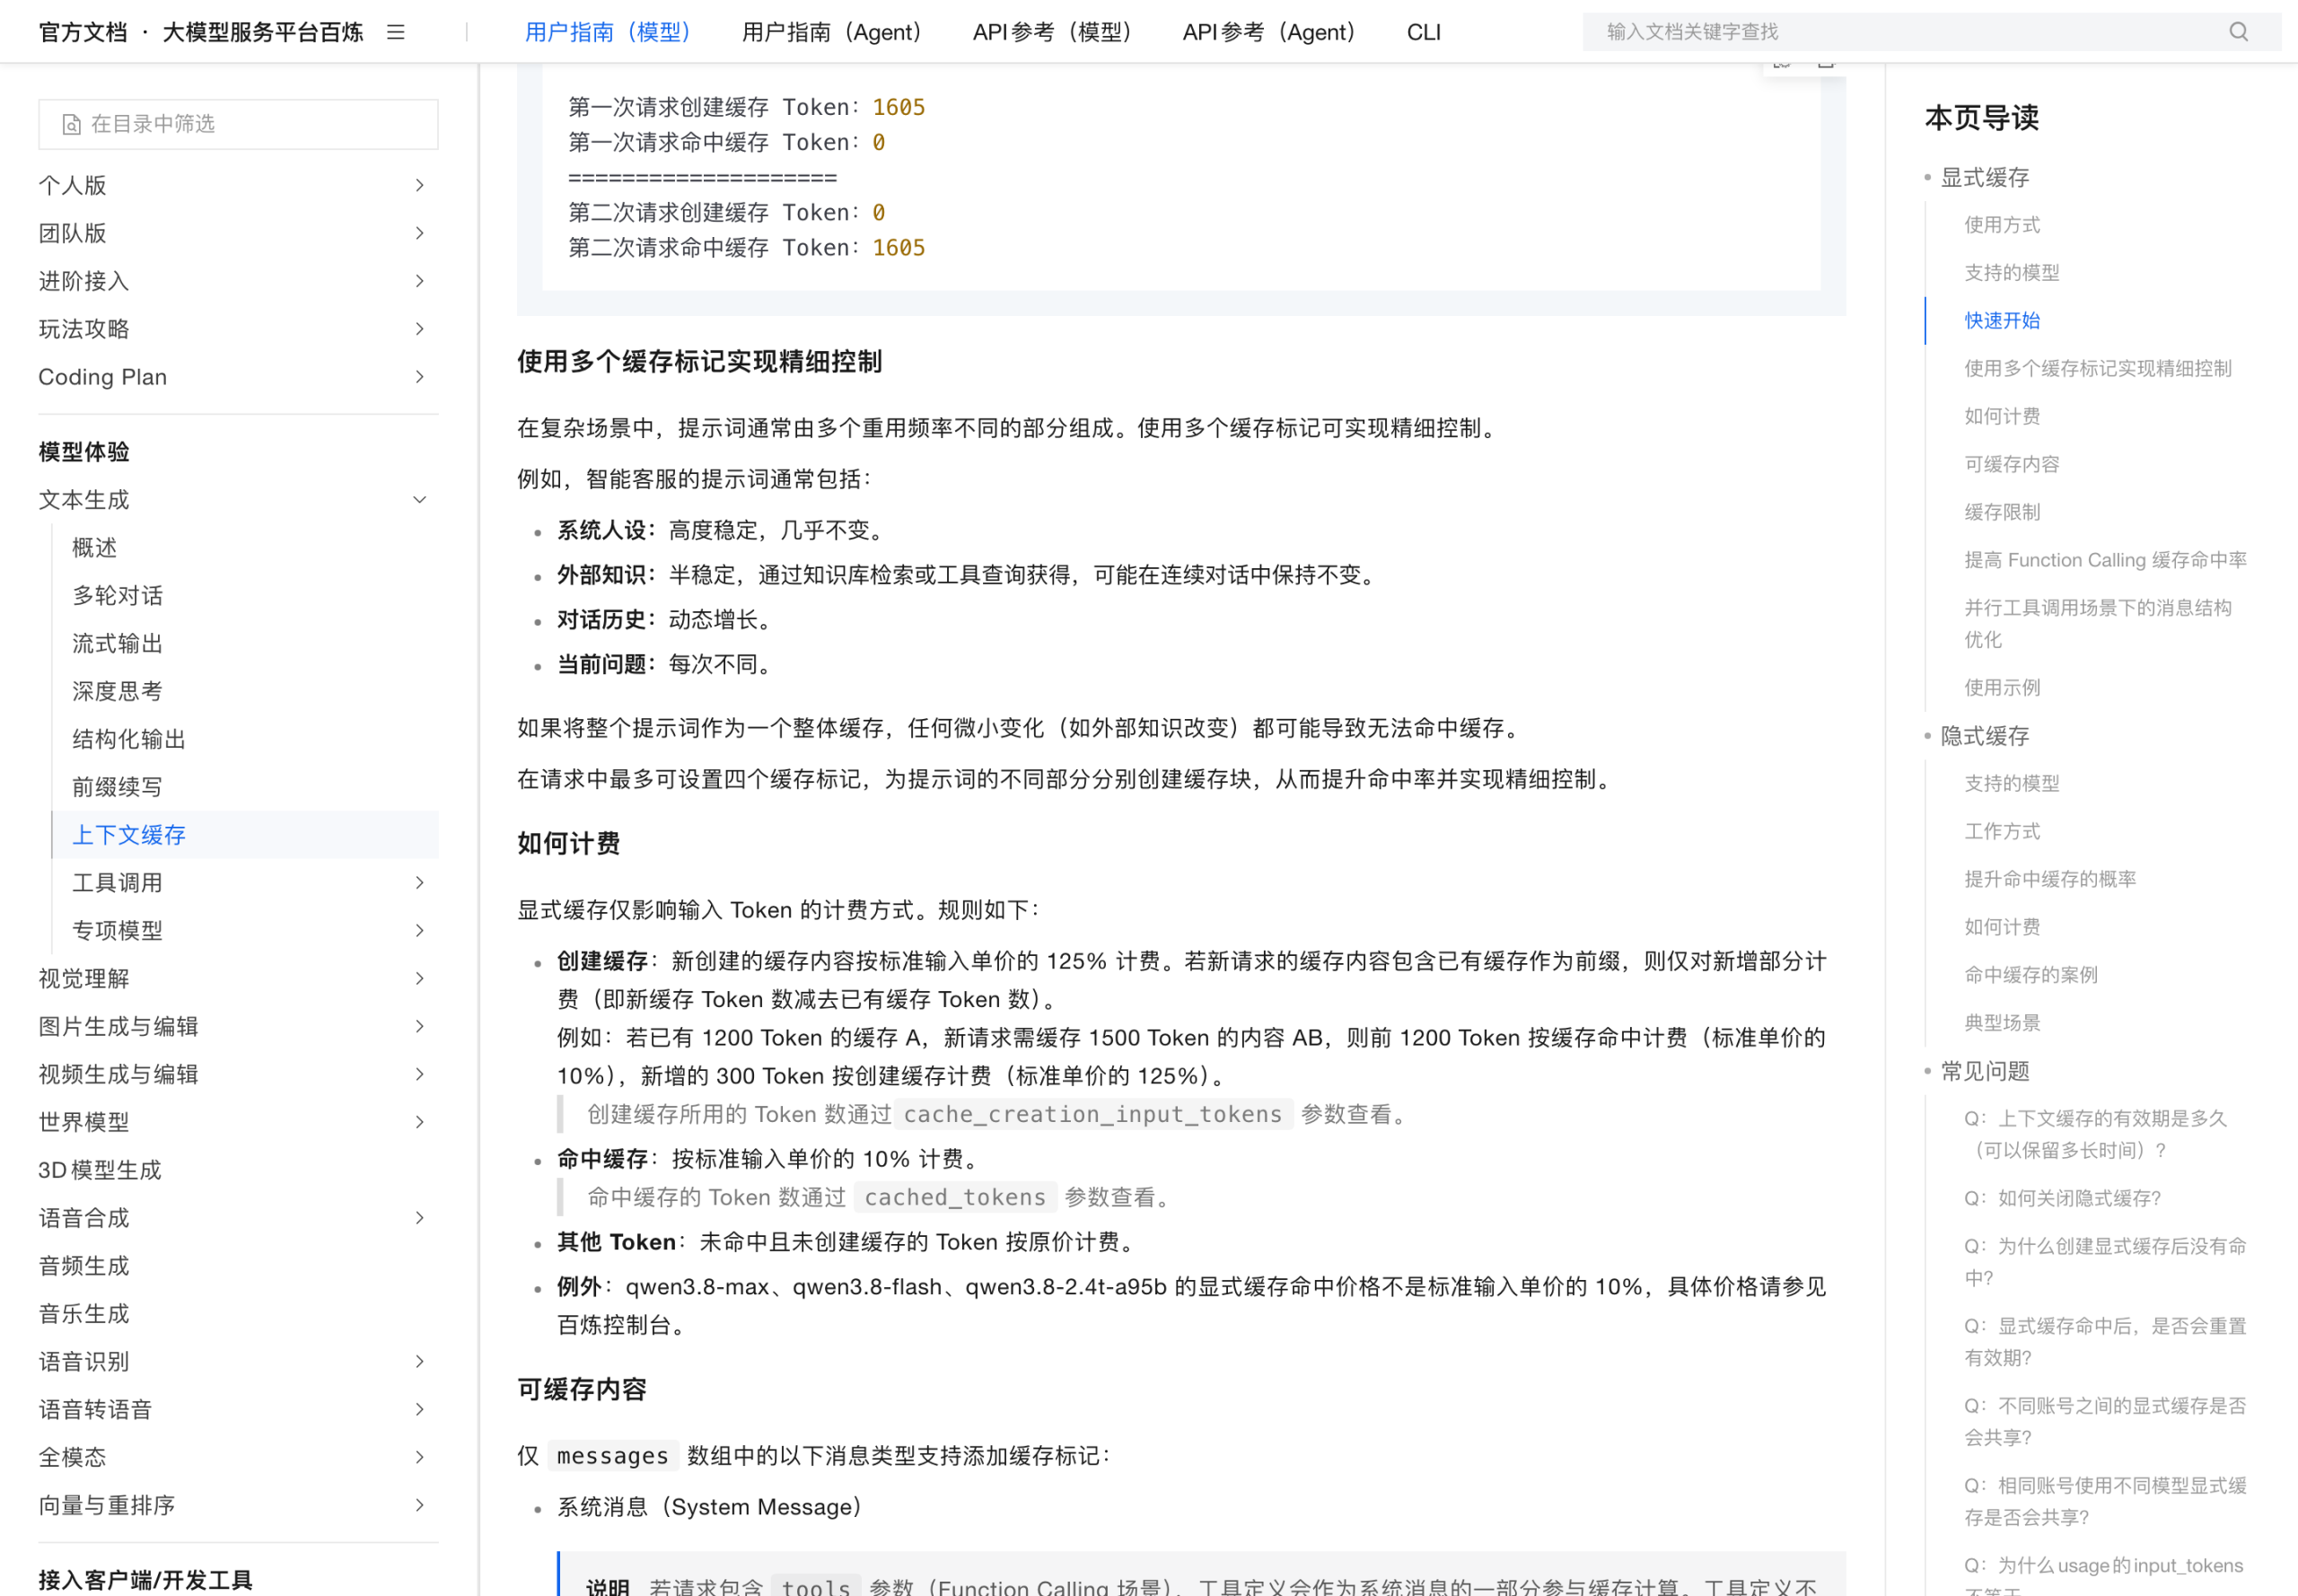
用官方给的示例做一次完整算术。假设已有 1,200 Token 的缓存 A,新请求要缓存 1,500 Token 的内容 AB:
- 前 1,200 Token 属于已有缓存前缀 → 按命中的 10% 计费
- 新增的 300 Token → 按创建的 125% 计费
所以显式缓存的成本结构是”增量计价”,不是整块重算。这一点容易被忽略:新请求不会因为带缓存标记就把全部 1,500 Token 按 125% 收一遍。
把它抽象成一般的复用次数 N(以标准输入单价为 1):
- 无缓存:N 次调用 = N
- 显式缓存:1 次创建 1.25 + (N−1) 次命中 × 0.10
| 复用次数 N | 显式缓存 | 无缓存 | 差额 |
|---|---|---|---|
| 1 | 1.25 | 1.00 | 贵 0.25 |
| 2 | 1.35 | 2.00 | 省 0.65 |
| 3 | 1.45 | 3.00 | 省 1.55 |
| 4 | 1.55 | 4.00 | 省 2.45 |
| 5 | 1.65 | 5.00 | 省 3.35 |
结论是只复用一次的话,显式缓存会让你多付 25%;从第 2 次开始转正,回本门槛极低。这解释了官方示例为什么强调”缓存创建发生在模型响应之后,建议在创建请求完成后再尝试命中”——第一次请求注定是纯支出。
至于第 2 次调用能省多少绝对金额,取决于模型单价。以 qwen3.8-max 华北 2(北京)输入 12 元/百万 Token 为例(采集自《模型调用价格》表,页面标注更新时间 2026-10-13 15:44:40):
- 官方示例的 1,200 Token 命中部分:1,200 ÷ 1,000,000 × 1.2 元 = 0.00144 元
- 新增 300 Token 创建部分:300 ÷ 1,000,000 × 15 元 = 0.0045 元
- 若同样 1,500 Token 完全不走缓存:1,500 ÷ 1,000,000 × 12 元 = 0.018 元
也就是说官方这个例子省下的绝对金额是分级钱级别。缓存的价值不在绝对金额,而在于单次请求达到数十万 Token 时的规模效应——这也是官方把”最小可缓存提示词长度 1024 Token”设得这么低的原因。
三、隐式缓存:一个 60% 的定值,和一张写明”另算”的例外表
隐式缓存不需要任何配置,也无法关闭。计费方式简单得多:命中的输入 Token 按 cached_token 计费,未命中的按标准 input_token 计费,输出 Token 一律原价。
百炼部署的模型(deepseek-v4.1-flash、deepseek-v4-pro、qwen3.8-max、qwen3.8-flash、qwen3.8-2.4t-a95b、qwen3.8-omni-flash 除外)统一按 input_token 单价的 20% 计费。
文档给出的算例是:某请求 10,000 个输入 Token,其中 5,000 命中缓存。
- 未命中 5,000:50% × 100%
- 命中 5,000:50% × 20%
- 合计相当于无缓存模式的 60%
但真正值得工程上注意的是例外清单——折扣比例完全按模型来源分裂:
| 模型来源 | cached_token 相对 input_token 单价 |
|---|---|
| 阿里云百炼部署(多数 qwen/deepseek) | 20% |
| 阿里云百炼 deepseek-v4.1-flash | 10% |
| 阿里云百炼 kimi-k3 | 10% |
| 阿里云百炼 glm-5.3 / glm-5.2 / glm-5.2-fast-preview | 25% |
| 阿里云百炼其余 glm 系列 | 20% |
| 月之暗面部署 kimi/kimi-k2.6 | 16.9% |
| 月之暗面部署 kimi/kimi-k2.5 | 17.5% |
| 稀宇部署 MiniMax-M3 / M2.7 | 20% |
| 稀宇部署 MiniMax-M2.5 / M2.1 | 10% |
| 智谱部署 ZHIPU/GLM-5.3 系列 | 25% |
| 智谱部署 ZHIPU/GLM-5.3-FlashX | 28.5% |
| 快手万擎 vanchin/deepseek-v3.1-terminus、r1、v3 | 40% |
| 快手万擎 vanchin/deepseek-v4.1-flash | 2% |
| 快手万擎 vanchin/deepseek-v4-pro | 8.33% |
| 快手万擎 vanchin/deepseek-v3.2-think | 10% |
这张表的最短路径只有 2%(万擎 deepseek-v4.1-flash),最长是 40%(万擎 deepseek v3 系列),同一类缓存折扣在百炼货架上跨度 20 倍。qwen3.8-max、qwen3.8-flash、qwen3.8-2.4t-a95b 三个模型官方明确写着”cached_token 单价不是 input_token 单价的 20%,具体价格请参见百炼控制台”——这三者的实际折扣比例在公开文档里不可知。
同样地,显式缓存侧也有例外:”qwen3.8-max、qwen3.8-flash、qwen3.8-2.4t-a95b 的显式缓存命中价格不是标准输入单价的 10%”。
四、最容易踩的三个坑
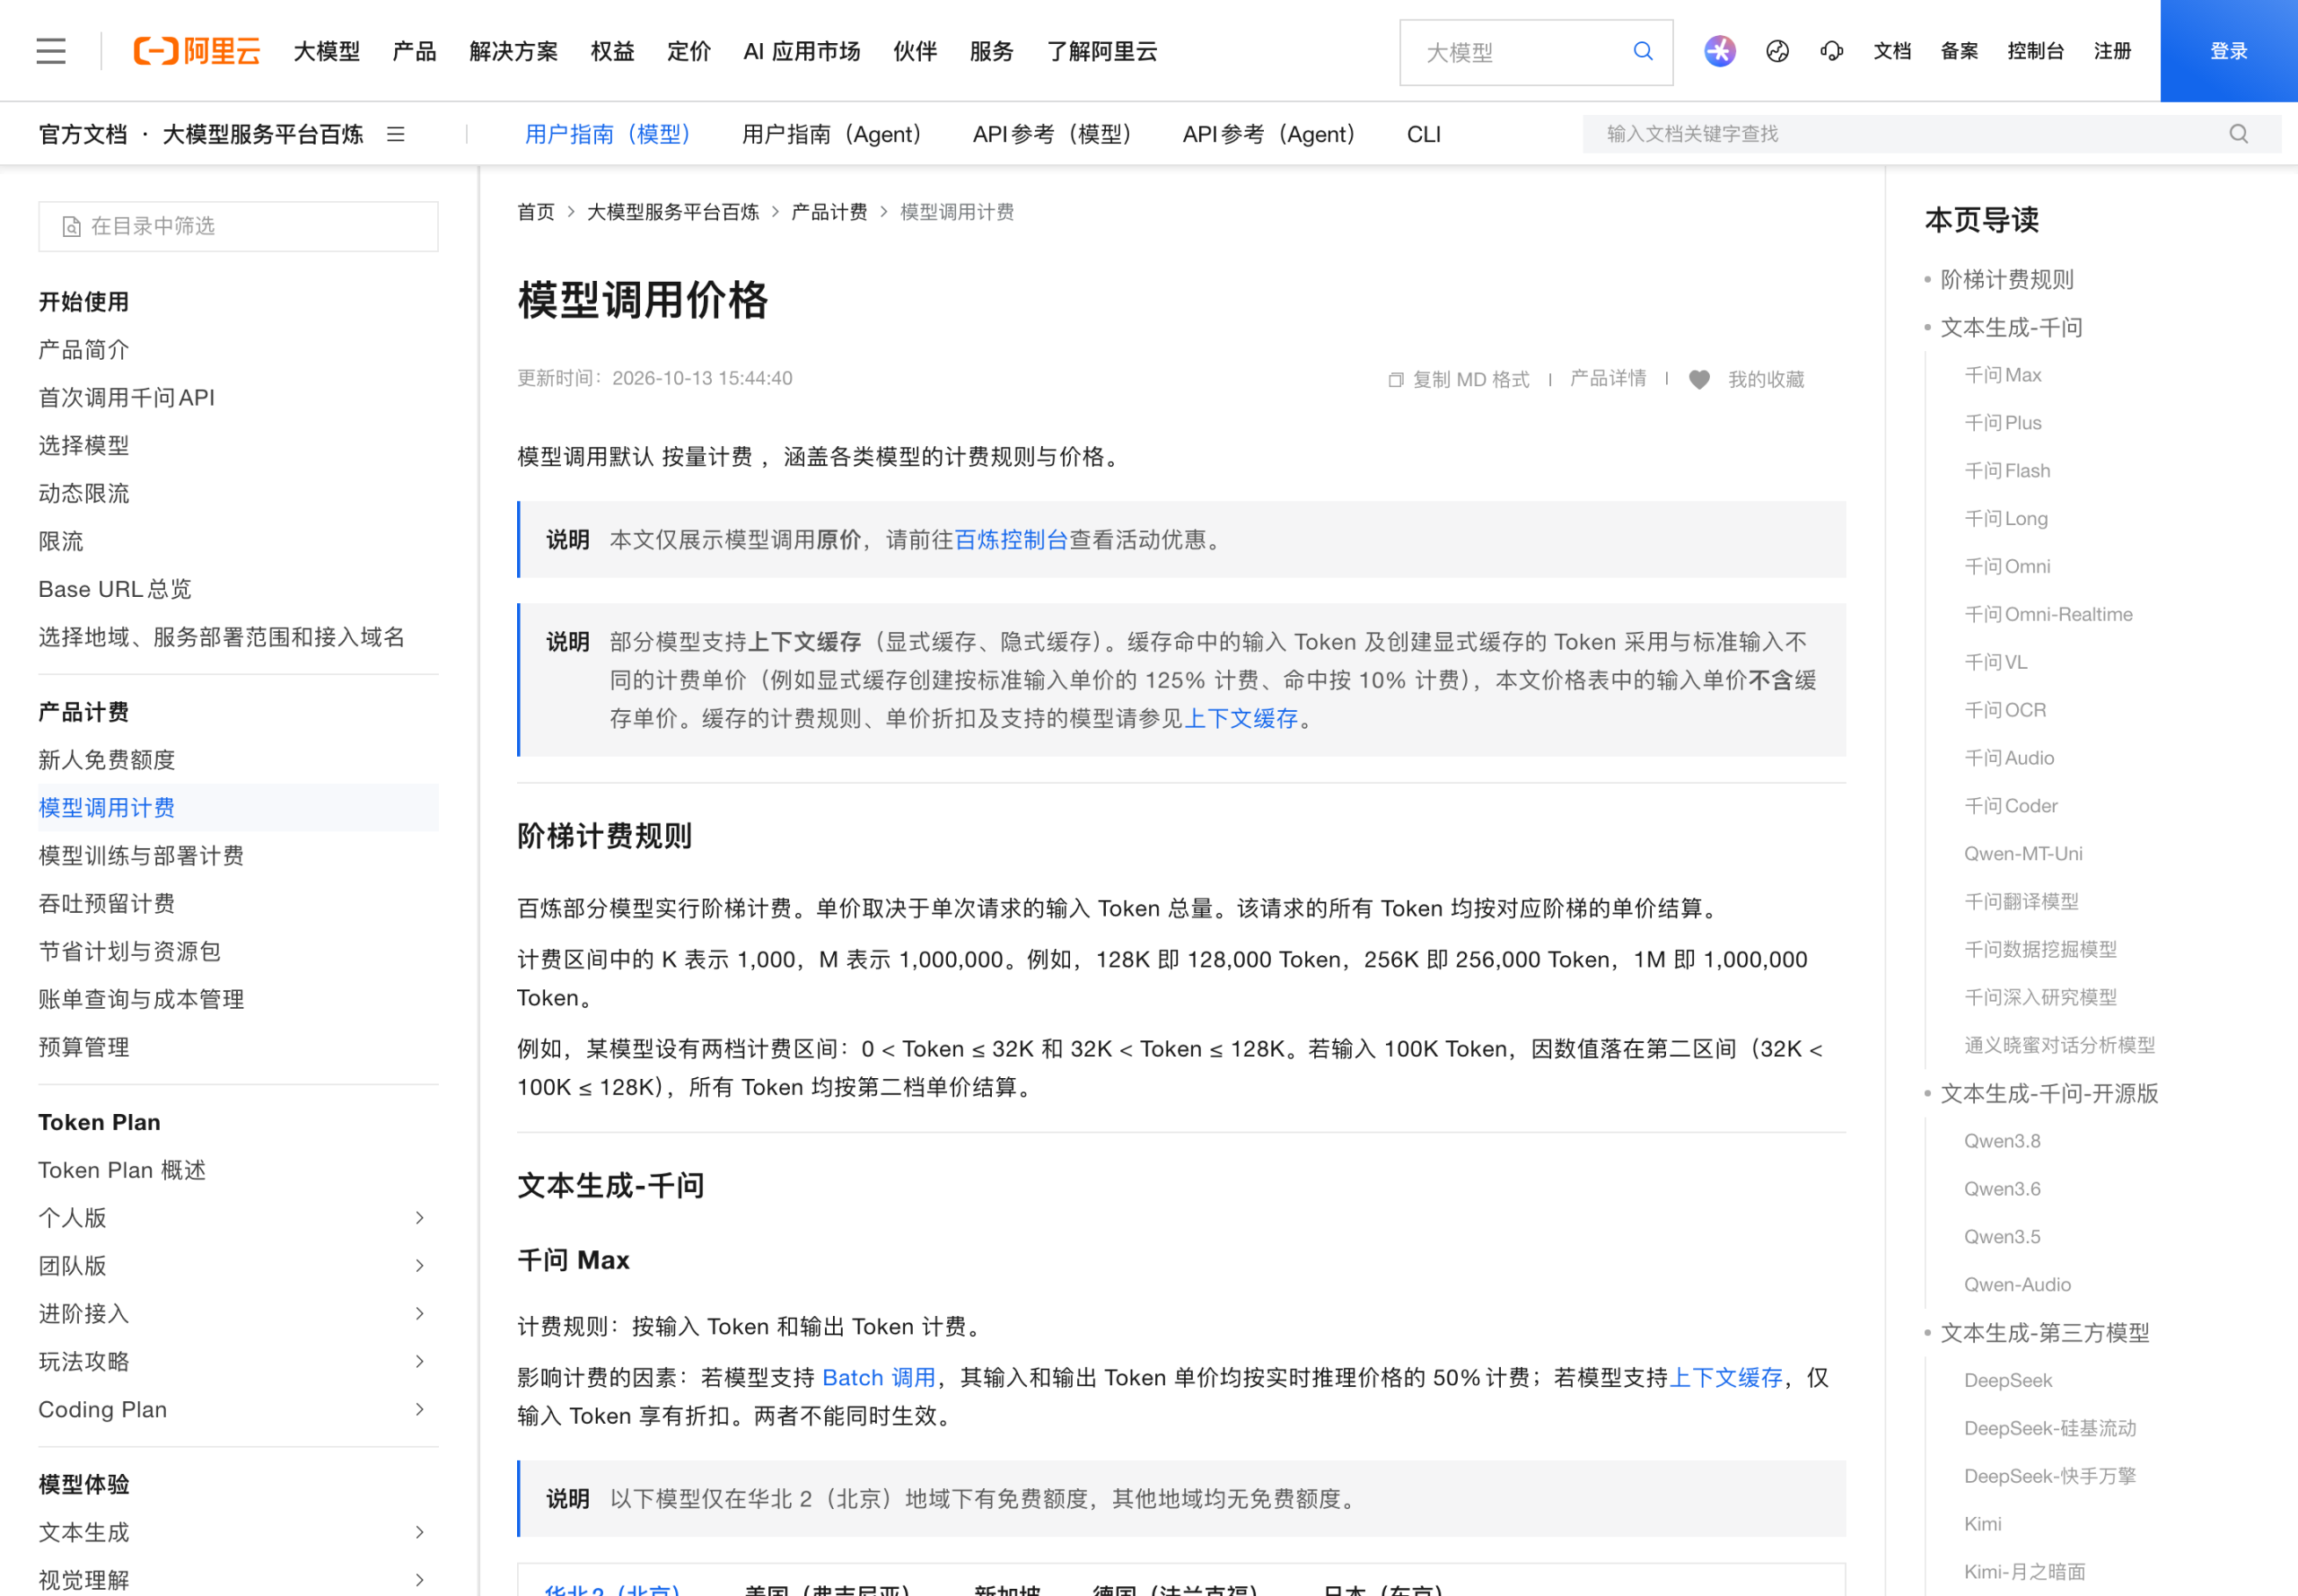
坑 1:Batch 半价与缓存折扣不能同时生效。 《模型调用价格》文档在千问 Max 的计费规则里写得很明确:”若模型支持 Batch 调用,其输入和输出 Token 单价均按实时推理价格的 50% 计费;若模型支持上下文缓存,仅输入 Token 享有折扣。两者不能同时生效。” 换句话说,一个走 Batch 的请求不能叠加缓存折扣。哪个更划算取决于任务时延要求——Batch 是 50% 全量折扣,缓存只在输入侧给到 10%~20%。
坑 2:input_tokens 不等于 cache_creation_input_tokens + cached_tokens。 官方解释是后端会在提示词之后追加少量 Token(通常在 10 以内),这些 Token 位于 cache_control 标记之后,不会被计入缓存创建或读取,但会计入总 input_tokens。所以对账时不要用等式校验,否则每次都会差几个 Token。
坑 3:显式缓存的后向回溯窗口只有 20 个 content 块。 系统以每个 cache_control 标记位置为终点,向前回溯最多 20 个 content 块尝试命中。单次请求最多支持 4 个缓存标记,若标记多于 4 个则”最后四个生效”。在多轮对话或并行工具调用场景下,连续同角色消息会各自占据一个 content 块位置,很容易悄悄越过 20 块窗口导致缓存静默失效。官方给的解法是把连续同角色的 tool 消息合并为”一条消息 + 多个 content 块”。
Function Calling 场景另有一层陷阱:工具定义会被序列化成 JSON 字符串参与缓存计算,官方要求 tools 数组顺序、同一个 tool 的 JSON 字段顺序、字段结构三者完全一致,否则缓存失效。工具定义不支持独立缓存,把 cache_control 加在工具定义里会被直接忽略。
五、支持范围与地域差异
显式缓存和隐式缓存支持的模型清单不同,且按部署地域分别列举(采集自同一文档”支持的模型”章节):
- 华北 2(北京):千问 Max 5 个版本、千问开源 2 个、千问 Plus 5 个、千问 Flash 6 个、千问 Coder 1 个、千问 VL 1 个、千问 Character 1 个,外加 Kimi 3 个、GLM 1 个
- 美国(弗吉尼亚):仅 Max 2 个、Plus 1 个、Flash 3 个,且区分”全球”与”美国”两种服务部署范围
- 新加坡:覆盖 Max/Open/Plus/Flash/Coder/VL 六类,国际部署范围
- 德国(法兰克福):区分全球服务部署范围与欧盟服务部署范围,欧盟范围里只有
qwen-plus、qwen3.5-flash、qwen3-vl-plus三个模型 - 中国香港:同样区分全球范围与中国香港范围
模型相同,地域不同,缓存折扣比例和可用模型都可能不一样。这一点在多地域架构里尤其容易被漏掉——同一份代码切换地域后,缓存命中率与单价都会变。
价格表里也能看到同一模型跨地域的输入单价差:qwen3.8-max 全球范围 12 元/百万 Token,美国部署范围 14.988 元;qwen3.7-max 全球 12 元,美国 18.736 元。缓存折扣是在标准输入单价基础上计算的,所以地域单价差会被缓存放大或缩小。
六、怎么选:一张决策表
| 你的情况 | 建议 | 依据 |
|---|---|---|
| 同一前缀确定复用 ≥ 2 次,且需要确定性命中 | 用显式缓存 | 第 2 次调用即回本,命中率可控 |
| 只是想省点钱,不想改代码 | 保持隐式缓存 | 自动开启、无法关闭、无额外成本 |
| 单次请求就结束的前缀 | 不要建显式缓存 | 必然多付 25% |
| 对时延敏感 | 显式缓存 | 官方称其”能实现更高的缓存命中率和更低的访问延迟” |
| 需要 Batch 离线跑 | 二选一 | Batch 50% 与缓存折扣不可叠加 |
| 长文本多次问答、代码补全、Few-shot | 隐式缓存优先 | 官方列举的 5 类典型场景均以前缀复用为前提 |
| 视觉/视频重复提问 | 调整内容顺序 | 同对象多问题 → 图/视频在前;同问题换对象 → 文本在前 |
无论显式还是隐式,官方给的核心建议只有一句:把重复内容放在提示词开头,差异内容放在末尾。
七、口径与未知项
本文所有数字均来自阿里云帮助中心官方文档,未使用任何第三方来源,也未实际调用 API 产生账单。
官方明示:125% 创建单价、10% 命中单价、20% 隐式命中单价、1024 Token 下限、5 分钟有效期、20 个 content 块回溯窗口、4 个缓存标记上限、60% 算例、各模型与各第三方部署的命中折扣比例表、Batch 与缓存折扣互斥、input_tokens 与两个缓存字段不构成等式。
我的换算(基于官方单价,标注为推算):第二节的复用次数盈亏平衡表(N≥2 才有收益)、官方示例的绝对金额(0.00144 / 0.0045 / 0.018 元)、第三节”2% 与 40% 相差 20 倍”的跨度结论、第五节 12 元 vs 14.988 元 vs 18.736 元的地域价差。
UNKNOWN:
- qwen3.8-max、qwen3.8-flash、qwen3.8-2.4t-a95b 三个模型的显式缓存命中价与隐式缓存命中价,官方明确指向百炼控制台,公开文档不可知,本文所有涉及这三个模型的单价均为标准输入价,不代表其缓存折扣
- qwen3.8-omni-flash 命中缓存按”固定单价计费”,各地域单价需查模型价格页,本文未取具体值
- deepseek-v4-pro 的 cached_token 单价同样指向控制台
- 隐式缓存的命中率官方明确表示”并非 100%”且”具体命中概率由系统判定”,未公布任何命中率数据,所以本文不做命中率相关推算
- 隐式缓存”有效期不确定,系统会定期清理”,官方未给出清理周期
- 本文未实际调用 API,所有金额为按官方单价静态计算,未包含缓存预热期间的并发影响
八、来源与采集口径
| 来源 | 用途 | 采集时间 |
|---|---|---|
| 上下文缓存文档 | 显式/隐式缓存规则、计费比例、限制、支持的模型、FAQ | 2026-10-17 12:05(HTTP 200 / 48,858 B) |
| 模型调用价格 | 千问 Max / Plus / Flash 输入输出单价、阶梯计费、Batch 与缓存互斥声明 | 2026-10-17 12:06(HTTP 200 / 80,362 B,页面标注更新时间 2026-10-13 15:44:40) |
| 文本生成 | 千问 Max 调用接口说明、Token 计算方式 | 2026-10-17 12:05(HTTP 200 / 48,043 B) |
本文的三张配图均为上述官方文档页面的实机截图,拍摄于 2026-10-17 12:05-12:07,视口 1440 px。