百炼文本向量 Embedding 全台账:9 档向量维度、两个同名参数互相打架,还有 3 个模型官方自己前后不一
如果你在阿里云百炼上做 RAG、语义搜索或者以图搜文,迟早会撞上同一个问题:文档里那张”向量维度”表到底该怎么用?可选项为什么这么多?dimensions 和 dimension 到底哪个对?稀疏向量到底能不能用?
这篇把百炼通用文本向量(Embedding)这一层的 6 个在售模型逐项拆开,全部数字来自 2026-10-18 21:0x 抓取的阿里云官方文档原始 HTML,用脚本解析表格后重算,不做估算。文末标注了每一条的证据等级和未知项。
一、先说结论:选型其实只有两条路
如果你只想知道该用哪个模型,可以直接看这个结论,详细依据在后面几节。
路线一:追求吞吐和成本,选 qwen3.7-text-embedding-flash。 它是全表唯一便宜到可以”随手调用”的模型,单价是同门 qwen3.7-text-embedding 的四分之一(0.000125 元 vs 0.0005 元每千输入 Token),限流配额却完全一样(24,000 RPM / 1,000,000 TPM)。两者都支持 20 行批量、128,000 Token 超长单行,flash 只是把最大维度砍到 1,024。
路线二:需要 2,560 维的精细区分度,只剩 qwen3.7-text-embedding 一个选择。 2,560 这个档位全平台仅此一家,text-embedding-v4 最高只能到 2,048。
其余四个 text-embedding-v1/v2/v3/v4 都是过渡期资产:v1 和 v2 参数完全相同(1,536 维、25 行、2,048 Token),v3 和 v4 在批量和单行长度上也完全相同(10 行、8,192 Token)。买新项目时,除了 v4 之外都没有理由再选。
二、北京地域六款模型的完整台账
下表是北京地域在售的六个模型,数值全部来自官方”模型概览”表。免费额度一列是本文档页面自己的标注。
| 模型 | 可选向量维度 | 最大行数 | 单行最大 Token | 单价(每千输入 Token) | Batch 单价 | 支持语种 | 免费额度 |
|---|---|---|---|---|---|---|---|
| qwen3.7-text-embedding | 2560、2048、1536、1024(默认)、768、512、256 | 20 | 128,000 | 0.0005 元 | 0.00025 元 | 201 种 | 各 100 万 Token |
| qwen3.7-text-embedding-flash | 1024(默认)、768、512、256 | 20 | 128,000 | 0.000125 元 | 0.000063 元 | 201 种 | 各 100 万 Token |
| text-embedding-v4 | 2048、1536、1024(默认)、768、512、256、128、64 | 10 | 8,192 | 0.0005 元 | 0.00025 元 | 100+ 种 | 各 100 万 Token |
| text-embedding-v3 | 1024(默认)、768、512、256、128、64 | 10 | 8,192 | 0.0005 元 | 0.00025 元 | 50+ 种 | 各 100 万 Token |
| text-embedding-v2 | 1536 | 25 | 2,048 | 0.0007 元 | 0.00035 元 | 9 种 | 各 50 万 Token |
| text-embedding-v1 | 1536 | 25 | 2,048 | 0.0007 元 | 0.00035 元 | 6 种 | 各 50 万 Token |
这张表里有几个容易被忽略的细节:
维度档位总数是 9 个,不是 6 个。 六个模型各自支持的维度合起来是 2560、2048、1536、1024、768、512、256、128、64 共 9 档。单个模型支持最多的 text-embedding-v4 有 8 档,而支持最少的 text-embedding-v1 和 text-embedding-v2 只有 1 档(固定 1,536)。
默认的 1024 维有两个模型拿不到。 官方参数说明写”默认值为 1024″,但 v1 和 v2 的维度是写死的 1,536。如果你沿用一套按 1024 维写死的向量库代码,迁到 v1/v2 上会直接维度不匹配。
qwen3.7-text-embedding-flash 的 Batch 折扣不是精确半价。 其余模型的 Batch 单价都是原价的精确 0.5 倍,flash 是 0.000125 → 0.000063,比值是 0.504。差价虽然只有每百万 Token 0.063 元,但在亿级 Token 的批量入库场景里是可以算出来的零头。
价格和限流是脱钩的。 flash 便宜四倍但限流与 qwen3.7 完全相同;而 text-embedding-v1/v2/v3/v4 这四个老模型单价更贵(v1/v2 的 0.0007 元是最贵的),限流却只有 1,800 RPM,比 qwen3.7 的 24,000 RPM 低了整整 13.3 倍。换句话说,省钱的老模型反而更慢也更贵——贵在单价,慢在限流。新项目没有理由碰它们。
价格与限流这两张表分属不同文档(模型价格页 与 限流页),本文所有数字都从这两页解析重算,并与 API 文档概览表交叉核对过:六个模型的每百万 Token 单价除以 1000 后,与 API 文档的每千 Token 单价六个全部精确相等。
三、dimensions 和 dimension 是两个不同的参数名
这是最容易踩的坑:官方在同一页文档里用了两个拼写。
OpenAI 兼容接口的请求体里,参数名是 dimensions(带 s),取值 2560、2048、1536、1024、768、512、256、128、64,默认 1024。而 DashScope 原生接口把这个参数放在 parameters 对象里,名字是 dimension(不带 s)。
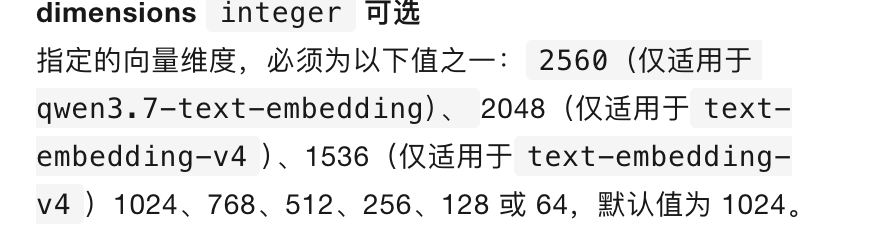
如果你从 OpenAI 的代码库迁移过来,参数名恰好是 dimensions,能对上;但如果你照着 DashScope 的示例写原生调用,用 dimensions 就是无效字段——服务端不一定会报错,有可能静默忽略并按默认 1024 返回。这是本文档无法从公开材料判定的部分,标记为未知项。
更麻烦的是,同一段参数说明里对模型的适用性判断,与上面概览表对不上。原文写:
2560(仅适用于 qwen3.7-text-embedding)、2048(仅适用于 text-embedding-v4)、1536(仅适用于 text-embedding-v4)1024、768、512、256、128 或 64
按这句话,2048 和 1536 只属于 text-embedding-v4。但概览表里 qwen3.7-text-embedding 那一行明确写着支持 2560、2048、1536、1024、768、512、256。同一个页面里,两处对”哪个模型能用 2048 和 1536″的结论不一致。
实际影响:调 qwen3.7-text-embedding 并显式传 dimensions=2048 或 1536 之前,建议先用小样本实测一次返回向量长度,别直接信任一处的文字。这一点本文未做实测,记为未知项。
四、encoding_format 的 base64 能不能拿到,取决于你落在哪个网关
第二个容易踩的坑是 encoding_format。官方支持传 float 或 base64,base64 理论上能把传输体积压掉四分之一,但它的实际行为被网关分片决定:
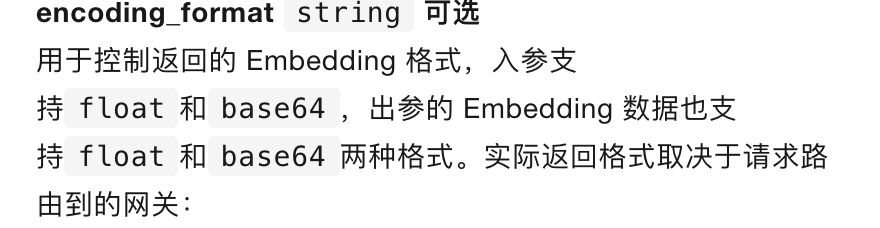
原文写得很清楚:
- 老网关:无论
encoding_format设成float还是base64,都只返回 float,不支持输出 base64。 - 新网关:短请求按
encoding_format设置的格式返回。 - 新网关的长请求:内部路由到老网关,仅返回 float。
也就是说,base64 能不能生效,不由你传的参数决定,而由你的请求恰好被路由到哪个网关、以及这个请求算不算”长请求”决定。一个 1,024 维的向量,float32 是 4,096 字节,base64 之后约 5,464 个字符——省不下来的原因就在这里。
如果你已经用 OpenAI SDK 并把 dimensions 设成 1,024,可以粗算一下十选维度对存储的影响:按 float32 计算,10 万条文本在 2,560 维下是约 976.6 MiB,1,024 维是约 390.6 MiB,256 维是约 97.7 MiB,64 维是约 24.4 MiB。维度砍到 256,存储直接省到十分之一。这是选维度时最实在的一个动机,比精度讨论更能说服预算。
五、稀疏向量:请求参数说支持,响应结构说不支持
第三个坑在稀疏向量(sparse embedding)上,而且这次是官方自相矛盾。
请求参数章节写:
用户指定输出离散向量表示只适用于 qwen3.7-text-embedding、“text-embedding-v3 与 text-embedding-v4 模型,取值在 dense、sparse、dense&sparse 之间,默认取 dense
但同一页的响应结构章节写:
属性 sparse_embedding array 对应字符串的算法输出离散向量表示(sparse embedding 仅适用于 text-embedding-v3 与 text-embedding-v4)
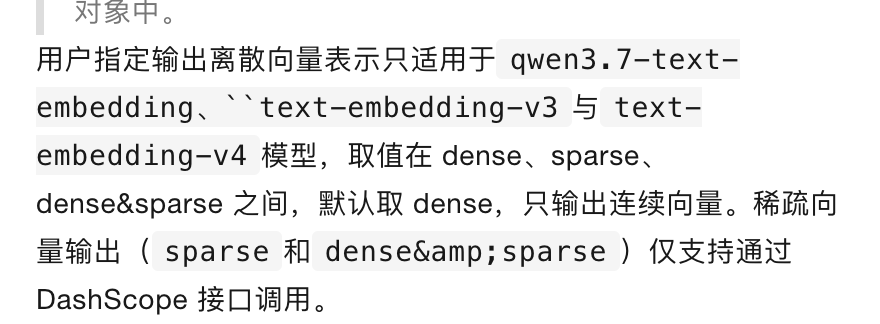
对比两处:参数章节把 qwen3.7-text-embedding 列进了支持范围,响应章节没有。这两段文字描述的是同一个能力(能不能输出稀疏向量),却给出了两个不同的模型集合。官方未说明以哪一处为准。
还有一层限制值得注意:稀疏向量输出仅支持通过 DashScope 接口调用,OpenAI 兼容接口用不了。也就是说,用稀疏向量这条路的团队,就没法同时享受 OpenAI SDK 的兼容性——这本身就是一个架构取舍。
对 qwen3.7-text-embedding 而言,这道选择题的答案是:先实测,别照文档下单。
六、限流:同一个模型,三个地域三套配额,且北京与国际不同
限流页的表格结构是分地域分组的,直接读容易看串。解析后完整台账如下:
| 模型 | 部署范围 | RPM(每分钟调用次数) | TPM(每分钟 Token) |
|---|---|---|---|
| qwen3.7-text-embedding | 北京 | 24,000 | 1,000,000(仅输入 Token) |
| qwen3.7-text-embedding-flash | 北京 | 24,000 | 1,000,000(仅输入 Token) |
| text-embedding-v1/v2/v3/v4 | 北京 | 1,800 | 1,200,000(仅输入 Token) |
| qwen3.7-text-embedding | 国际 | 24,000 | 1,000,000(含输入与输出) |
| text-embedding-v4 | 国际 | 1,800 | 1,000,000(含输入与输出) |
| text-embedding-v3 | 国际 | 6,000 | 24,000,000(含输入与输出) |
| text-embedding-v4 | 中国香港 | 1,800 | 1,200,000(含输入与输出) |
| text-embedding-async-v1/v2 | 北京 | 60 | 排队中+运行中不超过 50 个作业,并发最多 3 个 |
这里有两处容易踩的坑。
第一,北京与国际的 TPM 口径不同。 北京那一组表头写的是”仅输入 Token”,国际和香港写的是”含输入与输出 Token”。虽然文本向量确实没有生成内容,但官方明确把两组的计费口径标成了不同,说明两套网关的后端统计方式并不统一。
第二,同为 text-embedding-v3,北京和国际的限流差了一个数量级。 北京是 1,800 RPM / 1,200,000 TPM,国际是 6,000 RPM / 24,000,000 TPM——RPM 是 3.33 倍,TPM 是整整 20 倍。而 text-embedding-v4 在国际的 TPM(1,000,000)反而低于北京(1,200,000)。
这组数字很反直觉:如果你的应用要部署在新加坡/国际站,text-embedding-v3 反而是限流最宽松的选择,而 v4 并不是。这个结论完全来自表格数值本身,与”新版应该更好”的直觉相反。
第三,Batch 调用明确不受限流限制。 表里对 v1/v2/v3/v4 都注明了”用 Batch API 调用服务时,不受限流限制”。这对大规模离线入库是个重要优势——不过本文没有实测 Batch 调用的实际吞吐,记为未知项。
第四,两个异步模型在限流页和价格页都存在,但在 API 文档里完全查不到。 text-embedding-async-v1 和 text-embedding-async-v2 有价格(0.7 元每百万 Token,免费额度高达 2,000 万 Token,是同步模型的 20~40 倍)和限流记录,但本文采集的”通用文本向量同步接口 API 详情”页里,async 一词出现 0 次。它们的调用方式、请求参数、异步作业的取回流程,在这份同步接口文档里没有任何说明。要用这两个模型,得另外找文档。
七、免费额度两页不一致:v3 是 100 万还是 50 万?
价格页和 API 文档概览表对同一件事给出了不同答案。
API 文档概览表写:text-embedding-v3 免费额度”各 100 万 Token 有效期:百炼开通后 90 天内”。按 rowspan 继承解析,v3 继承了 text-embedding-v4 那组的 100 万额度。
价格页写:text-embedding-v3 免费额度 50 万 Token,并且额外附了一句说明:
免费额度用完后不可调用,推荐使用 text-embedding-v4 作为替代模型,免费额度提升至 100 万 Token
这句话本身透露了更多信息:v3 的免费额度用完后不是扣钱继续用,而是直接不可调用。这一点和其他”免费额度用完按量付费”的表述完全不同,也解释了为什么官方要推荐迁移到 v4。
不过这句”提升至 100 万 Token”又把数字绕回了 100 万——和 v4 的额度一样。三处数字(概览表 100 万、价格页表格 50 万、说明句 100 万)互相打架,本文按”以价格页表格为准”理解,但这是推断而非官方结论,记为未知项。
顺带确认另外五个模型两页一致:qwen3.7-text-embedding、qwen3.7-text-embedding-flash、text-embedding-v4 均为 100 万 Token,text-embedding-v2 和 text-embedding-v1 均为 50 万 Token。
八、地域差异:新加坡站的模型更少,v3 的维度还少了三档
新加坡地域的表只有 3 个模型,qwen3.7-text-embedding、text-embedding-v4、text-embedding-v3。flash、v2、v1 在新加坡不在列,本文采集的这份文档没有说明它们是”不支持”还是”未在上架”,记为未知项。
更需要注意的是 text-embedding-v3 的维度差异:
| 模型 | 北京可选维度 | 新加坡可选维度 | 差异 |
|---|---|---|---|
| qwen3.7-text-embedding | 2560、2048、1536、1024、768、512、256 | 同左 | 无差异 |
| text-embedding-v4 | 2048、1536、1024、768、512、256、128、64 | 同左 | 无差异 |
| text-embedding-v3 | 1024、768、512、256、128、64 | 1024、768、512 | 少了 256、128、64 三档 |
如果你在北京把库建成 128 维或 64 维,然后整体迁移到新加坡,同一个 text-embedding-v3 模型名会静默降到最低的 512 维——同一个模型名,不同地域的维度能力不一样。跨地域部署时这条必须提前确认。
新加坡地域的免费额度也不一样:qwen3.7-text-embedding 和 text-embedding-v4 标注”无免费额度”,但 text-embedding-v3 仍然有 50 万 Token(北京是 100 万)。也就是说新加坡站既少了三个模型,又砍掉了两个模型的免费额度,只留下 v3 一家还能免费试算。
九、选型建议与成本速算
综合上面七节,如果现在要动手,我的建议是:
- 默认从
qwen3.7-text-embedding-flash起步。 单价四分之一、限流与旗舰版相同、支持 201 种语种、20 行批量。只有当你实测发现 1,024 维区分度不够时,才换到qwen3.7-text-embedding并指定 2,560 维——这是全平台唯一的 2,560 维选项。 - 不要新选 v1/v2。 它们单价最贵(0.0007 元)、限流最低(1,800 RPM)、维度写死 1,536 无法调整,且新加坡站没有。
- v3 只在一种情况下选:你需要国际站的最大吞吐(6,000 RPM / 24,000,000 TPM,20 倍于北京)。除此之外一律选 v4。
- 先定维度,再定模型。 维度决定存储(2,560 维 vs 256 维差 10 倍体积)和检索精度,且大部分模型支持运行时切换——但 v1/v2 除外。换模型比换维度容易,换维度要重建全库。
成本速算:按 flash 的 0.000125 元每千输入 Token,100 万 Token 约 0.125 元;按旗舰版 0.0005 元算是 0.5 元;v1/v2 的 0.0007 元是 0.7 元。100 万 Token 的差距只有几毛钱,所以真正该算的不是 Token 单价,而是存储成本和限流对吞吐的限制——后者往往是真正的瓶颈。
十、证据口径与未知项
本文所有数值均来自阿里云官方文档 2026-10-18 21:01—21:0x 的实时抓取,方法如下:
- 模型概览、价格、限流三张表:抓取原始 HTML 后用脚本解析。本文发现这三张表大量使用
rowspan表达”多行同值”,朴素提取会把这些单元格整个丢掉——例如不解析 rowspan 时,text-embedding-v3和text-embedding-v1的维度、价格、免费额度会整列为空,看起来像”官方没标价”。本文的所有行数据均来自带 rowspan 继承的解析结果,并已对每个模型的维度集合用脚本重算。 - 交叉核对:API 文档概览表的每千 Token 单价,与价格页的每百万 Token 单价逐一换算比对,六个模型全部精确相等。
- 倍数关系:flash 与旗舰版 4 倍单价差(0.000125 / 0.0005)、qwen3.7 与老模型 13.3 倍 RPM 差(24,000 / 1,800)、国际与北京 v3 的 3.33 倍 RPM 差和 20 倍 TPM 差、128,000 与 8,192 的 15.6 倍单行长度差,均由脚本按原始数值计算。
本文未做实测,以下为未知项,不作为结论使用:
- 向
qwen3.7-text-embedding显式传dimensions=2048或1536是否真能返回对应长度的向量(文档两处表述不一致)。 - OpenAI 兼容接口传
dimensions(非dimension)时服务端是否报错或静默忽略。 qwen3.7-text-embedding是否真的支持稀疏向量输出(参数章节与响应章节矛盾)。encoding_format=base64在新网关的”短请求”边界具体是多少。- Batch API”不受限流限制”下的实际吞吐上限。
text-embedding-async-v1/v2的调用方式与参数(同步接口文档中 0 次提及)。- 新加坡站 flash/v2/v1 是不可用还是未上架。
text-embedding-v3免费额度最终以 100 万还是 50 万为准。
十一、站内相关文章分工
站内已有几篇与本文相邻的百炼文章,分工如下,避免重复阅读:
- 百炼上下文缓存:显式 125% 预付、命中回落 10% 讲的是缓存计费,本文讲的是向量接口本身的参数与限流,两者不重叠。
- 百炼 Function Calling 工具调用能力矩阵 讲生成模型的工具调用控制面,与文本向量的检索面无关。
- 百炼批量推理:1MB 与 6MB 限制和 18 个模型 讲 Batch 推理的文件体积限制,本文第六节只引用了”Batch 调用不受限流”这一条。
- 百炼限流全表:500 项 RPM 缺口 是限流页的全景扫描,本文第六节只取文本向量这一组做地域对比。
十二、来源
- 通用文本向量 同步接口 API 详情 — 主源,模型概览表(6 模型 × 7 列)、请求体参数(
dimensions/dimension、encoding_format、output_type、instruct、text_type)、响应结构(sparse_embedding);采集于 2026-10-18 21:01,HTML 168,152 字节。 - 阿里云百炼模型价格 — 文本向量价格表 9 行(含两个 async 模型)、新加坡表 4 行;采集于 2026-10-18 21:02,HTML 1,458,859 字节。
- 限流 — 文本向量限流三表(北京 10 行、国际 5 行、中国香港 3 行);采集于 2026-10-18 21:02,HTML 681,730 字节。
- 重排序 Reranking API — 检索链路中的排序环节,与本文的向量召回互补;采集于 2026-10-18 21:01,HTML 75,536 字节。