本文是 2026-10-16 12:00 千问时段的实测记录。所有数字来自阿里云帮助中心《图像与视频理解》单页(页面标注更新时间 2026-10-10 18:26:24,2026-10-16 12:0x 抓取)。本文只做官方文档的规则解析与算术核验,没有调用任何 API、没有登录百炼控制台、没有消耗一分钱,凡属我的推算都会明确标注。
做视觉理解接入时,大多数人第一反应是”选个模型、把图传进去、看返回结果”。真正决定成本和准确率的,是一条几乎没人先读、却藏在文档最深处的一句话:
图像 Token = h_bar × w_bar / token_pixels + 2
这一行式子里,token_pixels 只有两个值:32×32 和 28×28。它们不是精度参数,是计价单位。选错模型系列,同一张图的实际开销会差出 30%。更反直觉的是第二个参数:同一个模型,默认设置下会被静默压缩到只剩 1/6.4 的像素。
本文把百炼视觉输入层完整拆开,共 9 节、6 张表、10 个一手来源。
一、先说结论:视觉 Token 的三个关键量
官方给出的图像 Token 公式是 h_bar × w_bar / token_pixels + 2,其中 h_bar、w_bar 是预处理缩放后的长宽。这意味着”我传了一张 4000×3000 的图”这个事实本身不决定账单,决定账单的是缩放之后的结果。
三个必须先分清的概念:
| 概念 | 含义 | 谁决定 |
|---|---|---|
| 每 Token 对应像素 | 一个视觉 Token 覆盖多少像素 | 模型系列(32×32 或 28×28) |
| max_pixels | 输入图像的像素阈值,默认 2621440 | 调用方参数 |
| Token 上限 | 单图编码后的视觉 Token 硬顶,固定 16384 | 模型系列 |
+2 是固定开销,对大图可忽略,对极小图(4 Token 下限)则显著。官方在 smart_resize 示例代码里明确写了 Token 下限:4 个 Token(min_pixels = 4 × factor × factor)。
二、两个 token_pixels:32×32 与 28×28 的真实价差
Qwen3.8 / 3.7 / 3.6 / 3.5 / Qwen3-VL 系列用 32×32,QVQ 及其他 Qwen2.5-VL 模型用 28×28。
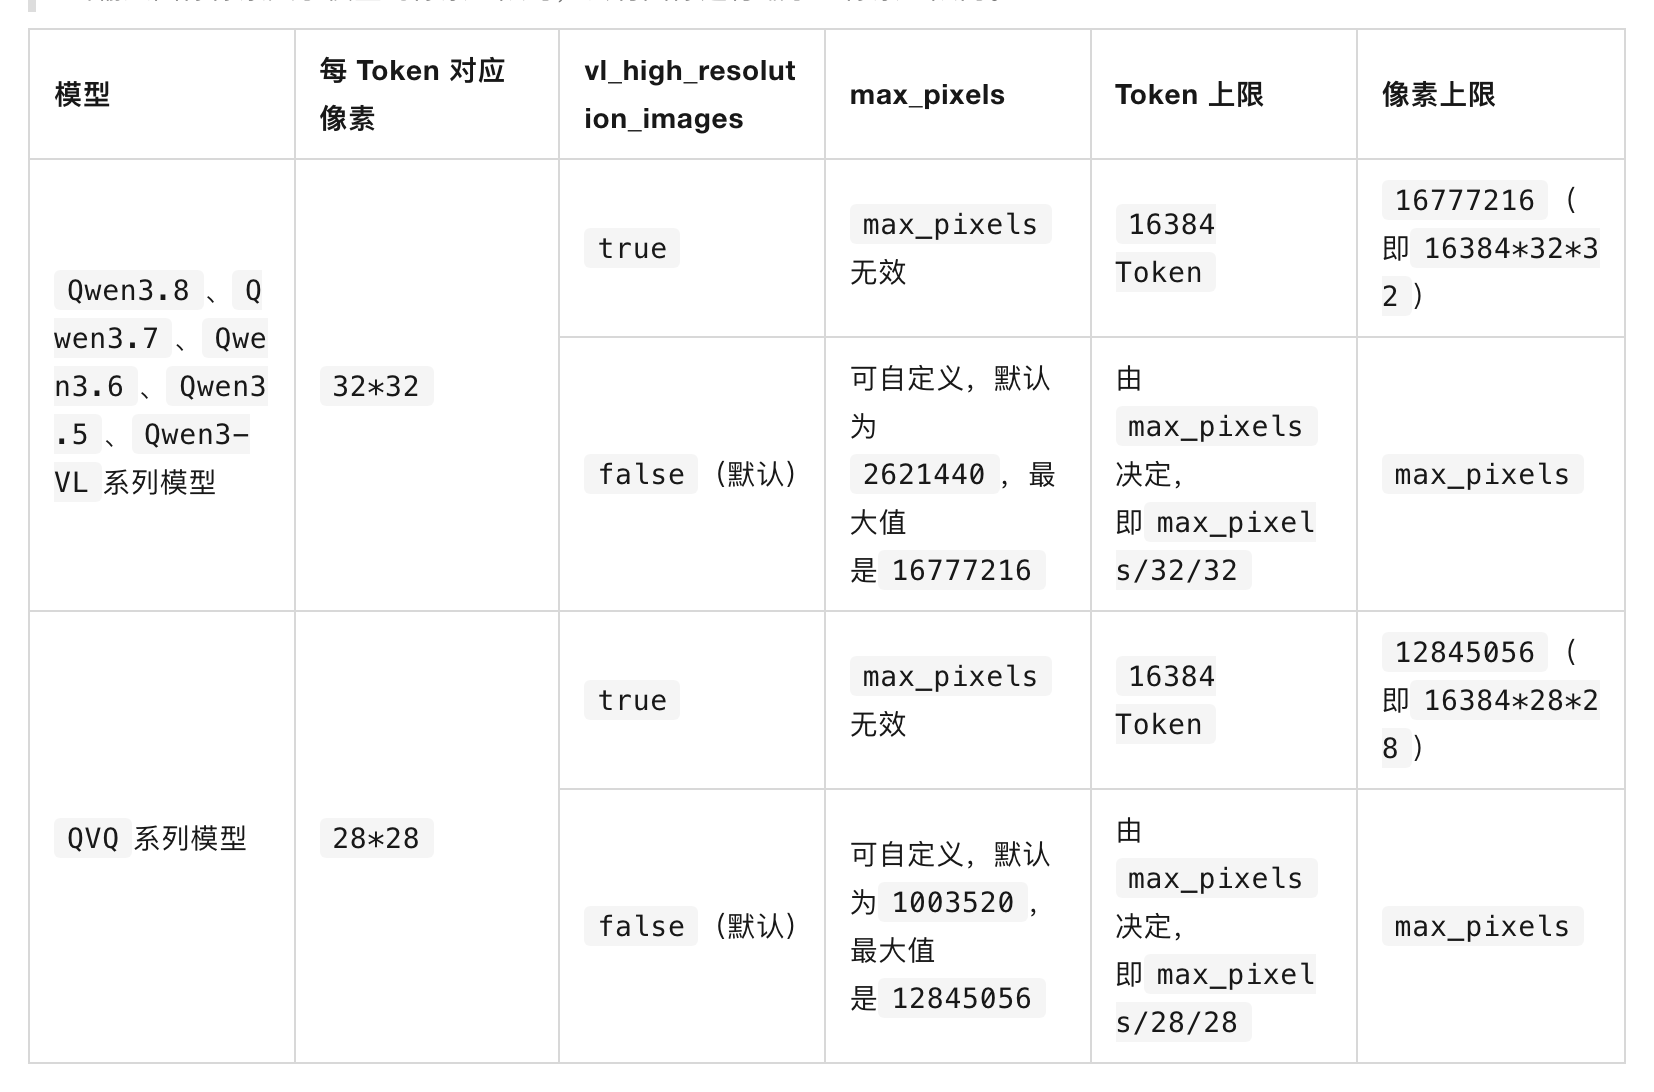
表面看 32×32 更大 = 更贵,但两者要结合各自的像素上限一起看:
| 模型系列 | 每 Token 像素 | 默认 max_pixels | 默认 Token 量 | 像素上限 | 上限是默认的 |
|---|---|---|---|---|---|
| Qwen3.8 / 3.7 / 3.6 / 3.5 / Qwen3-VL | 32×32 | 2621440 | 2560 Token | 16777216 | 6.4 倍 |
| QVQ 系列 | 28×28 | 1003520 | 1280 Token | 12845056 | 12.8 倍 |
官方表格里的两行算术完全自洽,可以直接反推验证:
- 16777216 = 16384 × 32 × 32(Qwen3.8 系列像素上限)
- 12845056 = 16384 × 28 × 28(QVQ 系列像素上限)
- 2621440 ÷ 1024 = 2560(Qwen3.8 系列默认 Token 量)
- 1003520 ÷ 784 = 1280(QVQ 系列默认 Token 量)
一个反直觉但重要的结论:在默认设置下,QVQ 的视觉 Token 反而只有 Qwen3.8 系列的一半(1280 vs 2560),因为它的默认 max_pixels 只有 1003520,而每 Token 覆盖的像素又更小(28² vs 32²)。也就是说,换了系列不等于账单同比例变化,两个参数在反向抵消。
只有在把两边都推到像素上限时,32×32 的优势才真正体现:16384 Token 对应 16777216 像素,比 QVQ 的 16384 Token / 12845056 像素多 30.6% 的画面信息。
三、最贵的默认值:2621440 像素 = 一个 1619×1619 的方块
max_pixels 的默认值为 2621440,很多人会把它当成”一个很大的数字”,但换算成实际尺寸就明白了:
- 2621440 像素若按正方形计,边长约 1619 px
- 常见照片尺寸对比:4000×3000 = 12000000 像素,是默认值的 4.58 倍
- 一张 3840×2160(4K)的图是 8294400 像素,同样是默认值的 3.16 倍
也就是说,按默认设置传一张 4K 图,模型实际只看了约 1/3 的像素,剩下 2/3 在预处理阶段被丢弃。 官方对此的表述相当直接:
提供超高分辨率的图像并不会提升识别精度,反而会增加调用失败的风险,建议在客户端提前将图像缩放至合理大小。
需要注意的是,这句话的主语是”识别精度”,官方没有否认缩放会丢细节,只是否认”更多像素一定更准”。对精细文本、微小物体这类场景,官方自己给出的解法是下面这个开关——这恰恰说明默认设置是有损的。
四、vl_high_resolution_images:不是提升,是从 2560 跳到 16384
vl_high_resolution_images=true 时,API 使用固定分辨率策略,忽略 max_pixels 设置,视觉 Token 直接到上限 16384。
| 设置 | Qwen3.8 系列视觉 Token | 相对默认 | 官方适用场景 |
|---|---|---|---|
| false(默认) | 2560 | 1× | 对成本敏感,希望减少视觉 Token 消耗 |
| true | 16384 | 6.4× | 识别图像中的精细文本、微小物体或丰富细节 |
| false + 自定义 max_pixels | max_pixels ÷ 1024 | 1× ~ 6.4× 连续可调 | 需要关注一定细节,可接受较低处理速度 |
账单影响:开启后视觉 Token ×6.4。如果该模型输入单价为 P 元/百万 Token,单张图的图像部分成本也从约 2.56P 升到 16.38P(我的换算,非官方报价)。
一个必须提前知道的调用陷阱:vl_high_resolution_images 不是 OpenAI 标准参数,在不同语言 SDK 里传递方式不同:
- Python SDK:必须通过
extra_body字典传递 - Node.js SDK:可作为顶层参数直接传递
写进顶层参数在 Python 里会被静默忽略,表现为”开了没效果”,且不会报错。这是我在文档中读到的明确差异,本轮未做实测验证。
五、文件大小三套闸门:同一个 7MB 出现三次,含义各不相同
视觉理解不接受 TXT / Word / PDF,官方给了两条替代路径:pdf2image 转图片后走多图输入,或用 Qwen-Long 通过文件 ID 传入。理解输入闸门的关键,是把三套并存的限制分开看。
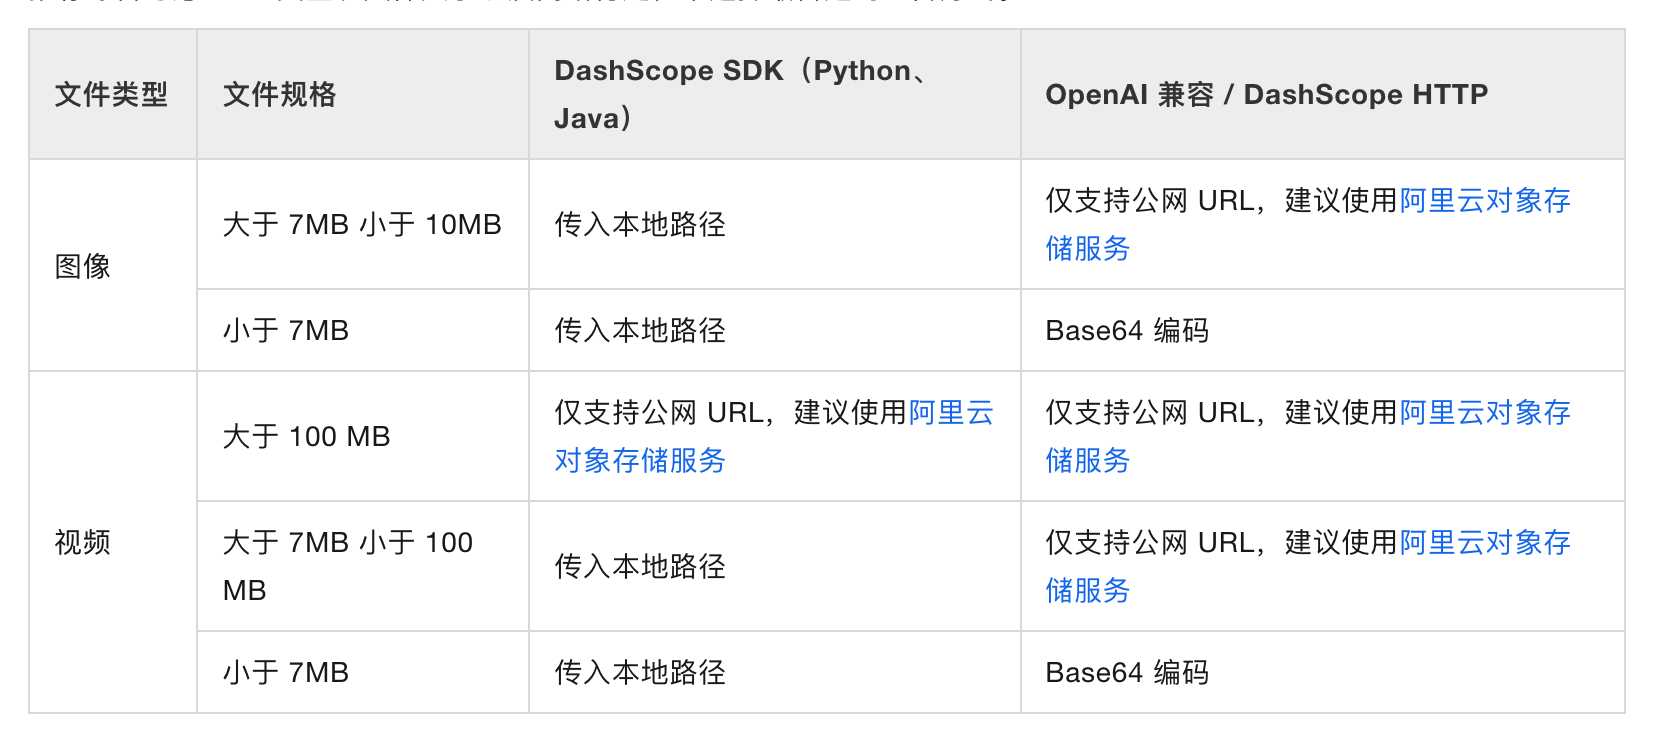
| 文件类型 | 文件规格 | DashScope SDK(Python、Java) | OpenAI 兼容 / DashScope HTTP |
|---|---|---|---|
| 图像 | 大于 7MB 小于 10MB | 传入本地路径 | 仅支持公网 URL,建议使用阿里云对象存储服务 |
| 图像 | 小于 7MB | 传入本地路径 | Base64 编码 |
| 视频 | 大于 100 MB | 仅支持公网 URL,建议使用阿里云对象存储服务 | 仅支持公网 URL,建议使用阿里云对象存储服务 |
| 视频 | 大于 7MB 小于 100 MB | 传入本地路径 | 仅支持公网 URL |
| 视频 | 小于 7MB | 传入本地路径 | Base64 编码 |
7MB 在这张表里出现三次,是三条完全不同的分界线,不是笔误:
- 第 1 条(7MB):HTTP 通道的传输方式选择线 —— 小于它可以 Base64,大于它 OpenAI 兼容接口就不再收 Base64 了
- 第 2 条(100MB):HTTP 通道的视频上限 —— 大于 100MB 时连 DashScope SDK 也只能走公网 URL
- 第 3 条(20MB):单图体积的模型侧上限,且随模型系列和传入方式变化
单图体积上限的完整分档(官方《图像限制》章节):
| 传入方式 | Qwen3.8 / 3.7 / 3.6 / 3.5 / Qwen3-VL 系列 | 其他模型 |
|---|---|---|
| 公网 URL | 单图不超过 20MB | 单图不超过 10MB |
| 本地路径(仅 DashScope SDK) | 单图不超过 10MB | 单图不超过 10MB |
| Base64 编码 | 编码前原始文件不超过 20MB | 不超过 10MB |
Base64 编码后的字符串还有第二道闸门:OpenAI 兼容接口与 DashScope 不超过 20MB,在 Anthropic 兼容接口不超过 32MB。且所有接口的请求体整体不超过 64MB,多张图像共享这一额度。
官方还专门给了一条反直觉的警告:DashScope 域名的请求体上限只有 16 MiB,建议改用 {WorkspaceId}.{region}.maas.aliyuncs.com 工作空间域名 —— 同一个服务,不同域名,请求体上限差 4 倍(16 MiB vs 64 MB)。
官方同时明确:这些限制不因购买高级套餐或升级模型版本而放宽。
六、格式不是统一 6 种:4K 是一条硬分界线
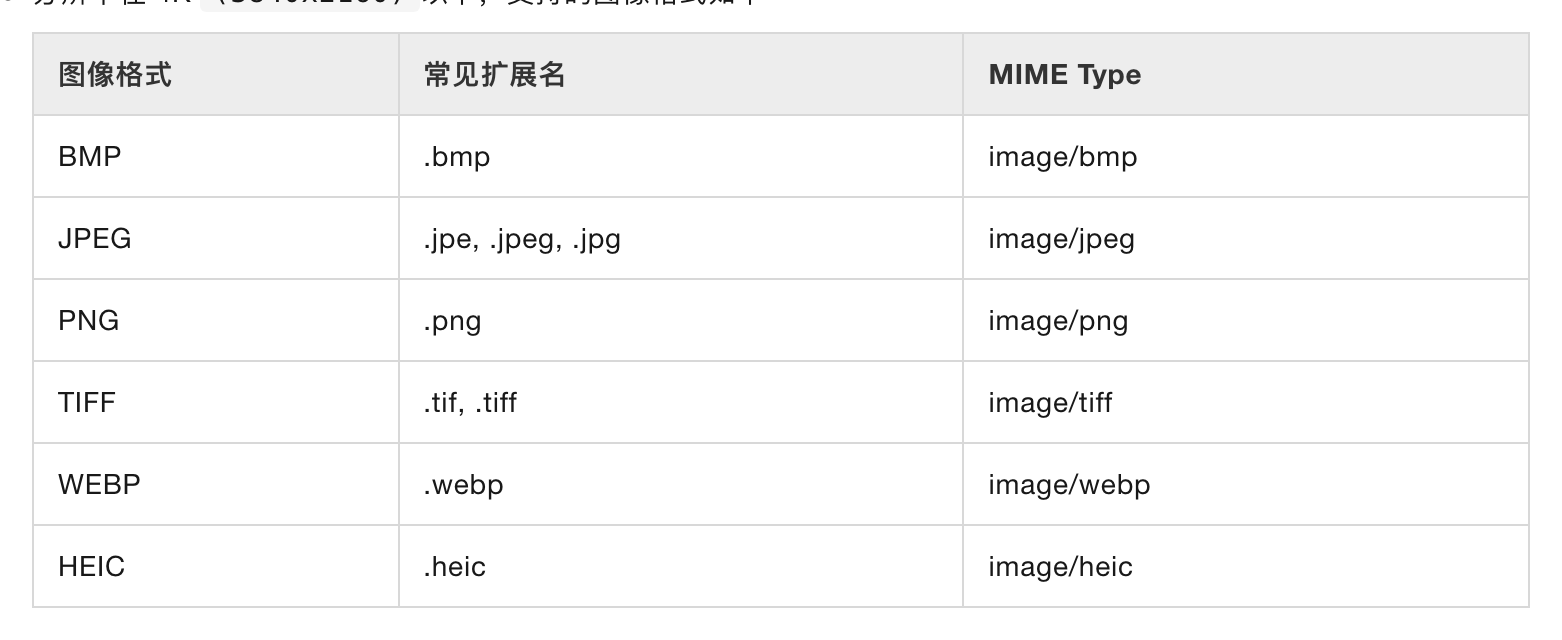
官方原文写得很精确:
分辨率在 4K(3840×2160) 以下,支持的图像格式如下……分辨率处于 4K(3840×2160) 到 8K(7680×4320) 范围,仅支持 JPEG、JPG、PNG 格式
| 分辨率区间 | 支持格式 |
|---|---|
| ≤ 4K (3840×2160) | BMP / JPEG(.jpe,.jpeg,.jpg) / PNG / TIFF(.tif,.tiff) / WEBP / HEIC —— 6 种 |
| 4K ~ 8K (7680×4320) | 仅 JPEG、JPG、PNG —— 3 种 |
TIFF 和 HEIC 在高分辨率区间直接不被支持。如果你的产线按 TIFF 出图,只能在客户端先降到 4K 以下。
其余硬性几何限制:最小尺寸宽高各须大于 10 像素;宽高比不超过 200:1;推荐分辨率控制在 8K (7680×4320) 以内,超过可能因文件过大、传输耗时长导致 API 调用超时。
七、图片数量上限:2048 与 256 的 8 倍断层
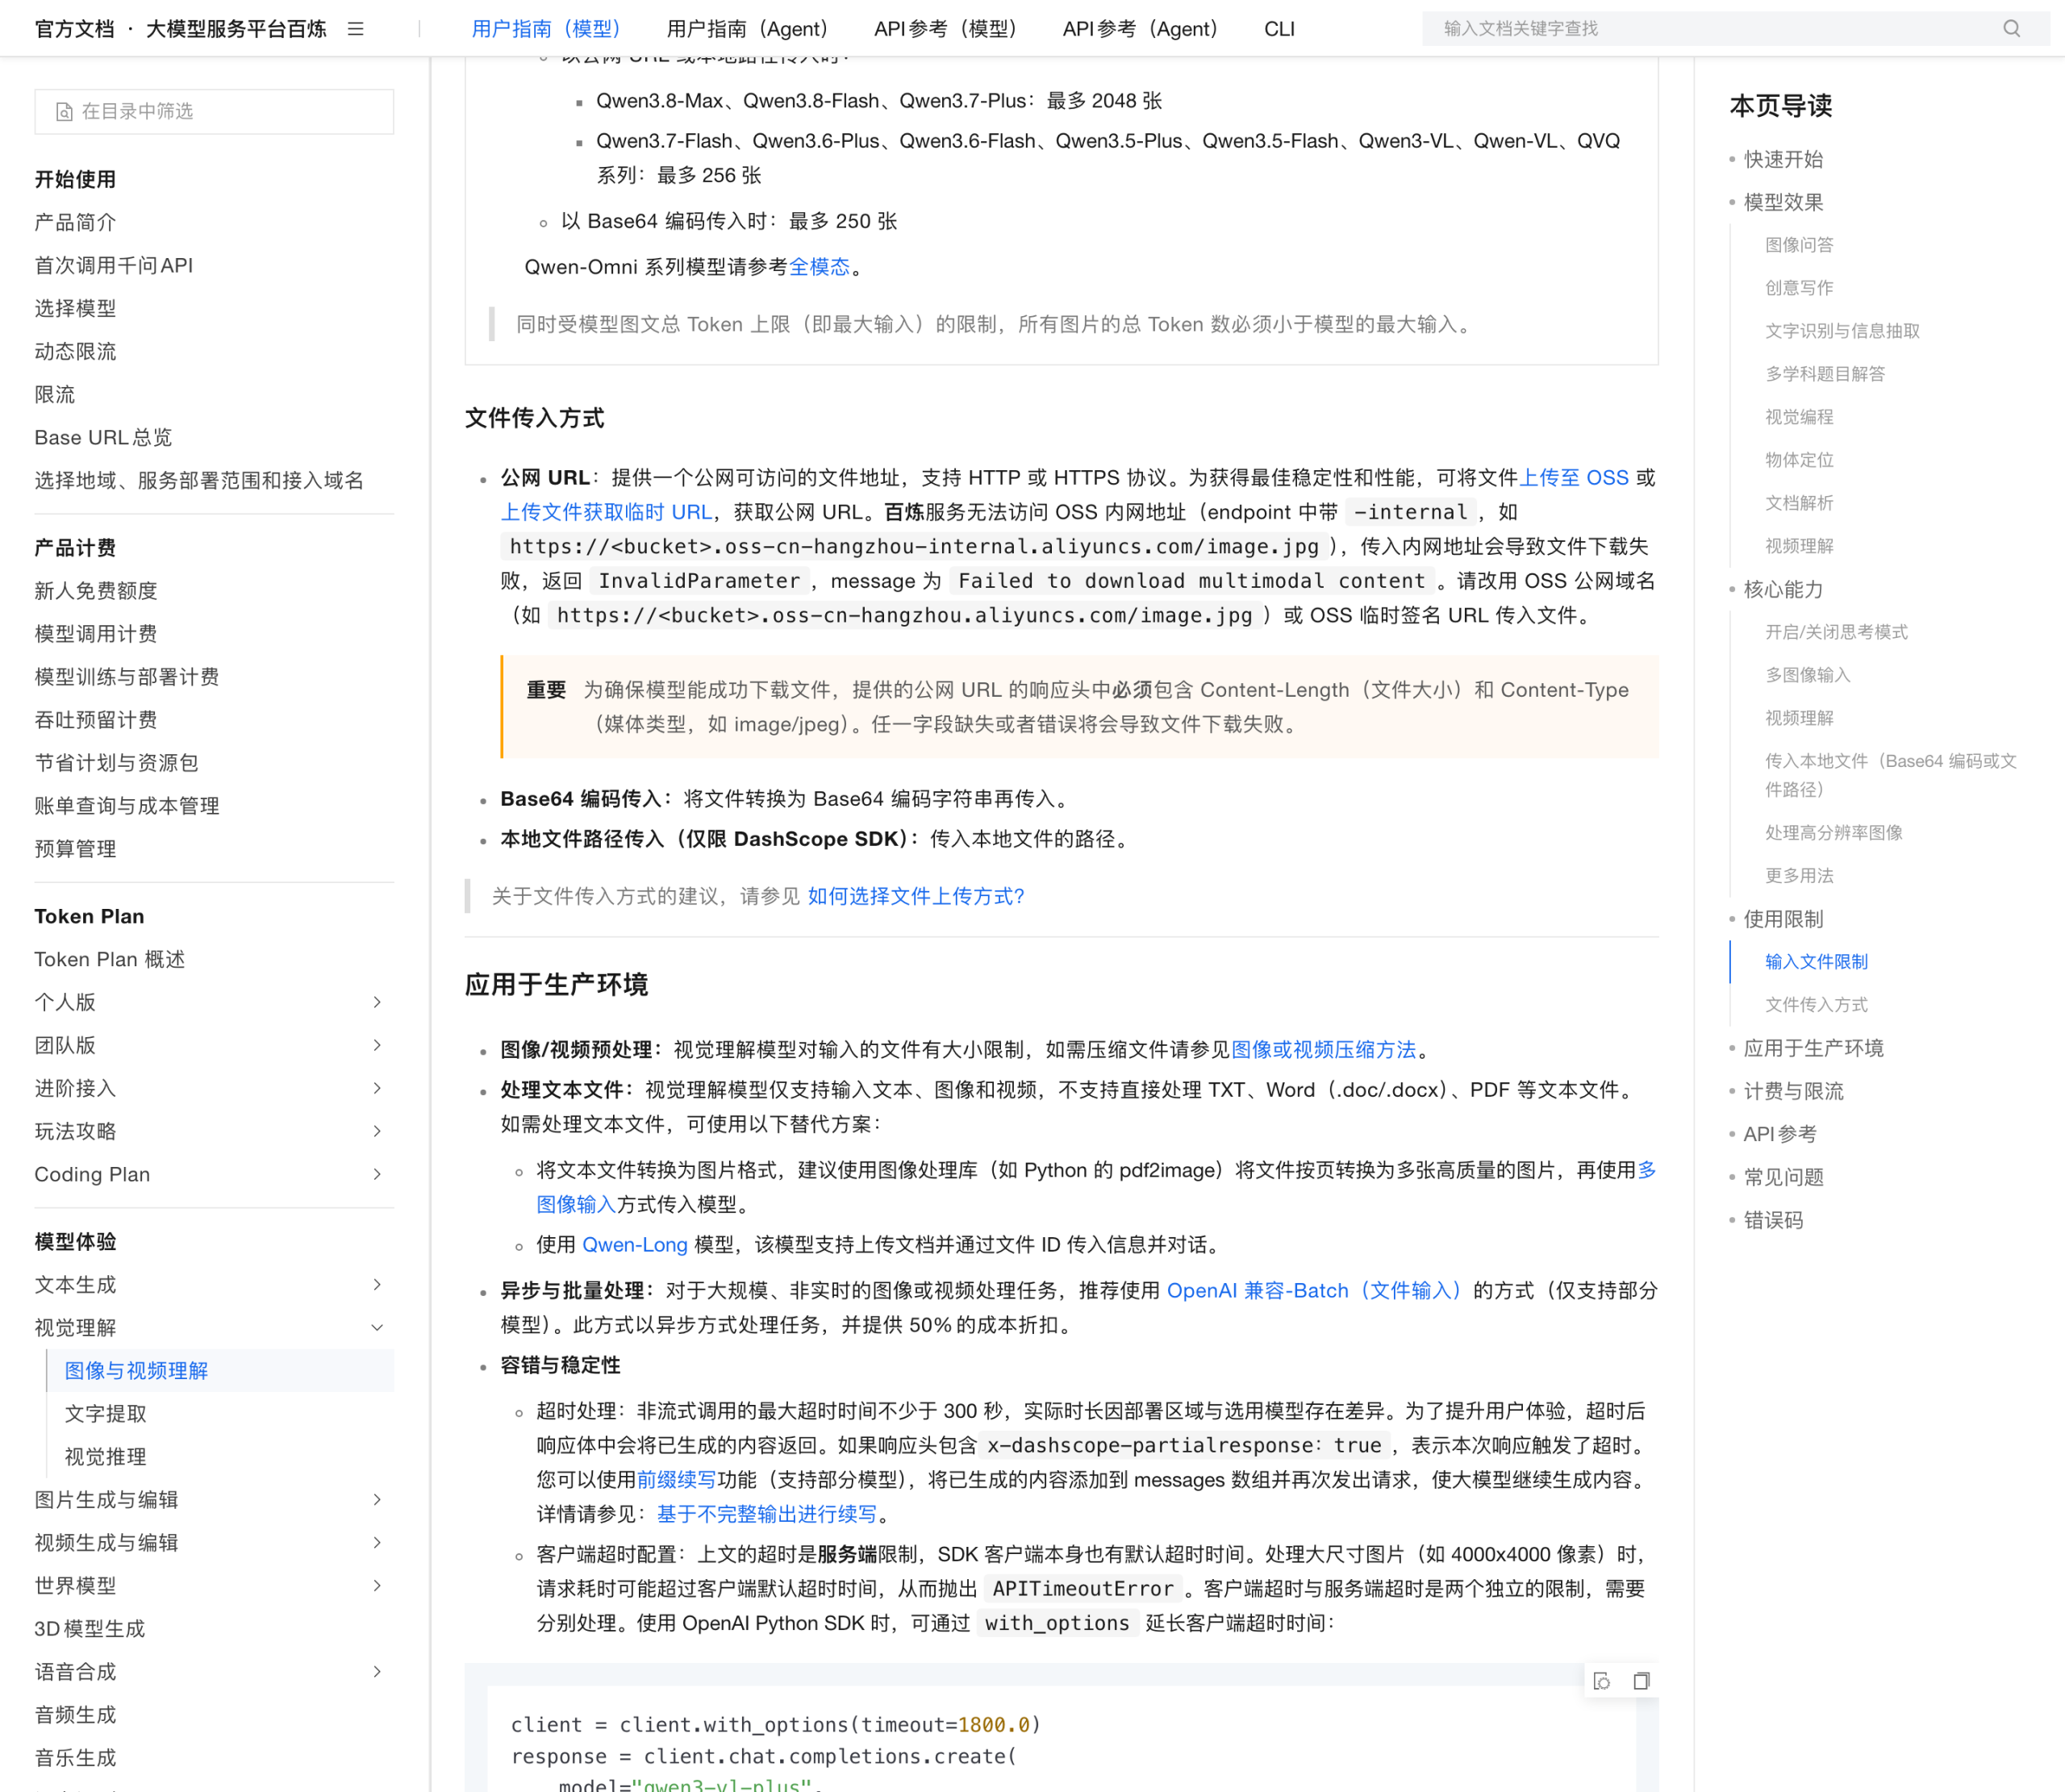
以公网 URL 或本地路径传入时:
| 模型 | 最多图片数 |
|---|---|
| Qwen3.8-Max、Qwen3.8-Flash、Qwen3.7-Plus | 2048 张 |
| Qwen3.7-Flash、Qwen3.6-Plus、Qwen3.6-Flash、Qwen3.5-Plus、Qwen3.5-Flash、Qwen3-VL、Qwen-VL、QVQ 系列 | 256 张 |
| Base64 编码传入(不限模型) | 250 张 |
这里有个容易踩的组合陷阱:Qwen3.8-Flash 的 2048 张是本轮上限最高的档位,但一旦改用 Base64 传入,全模型一律降到 250 张 —— 比 256 档还少 6 张。Base64 的代价不只是请求体膨胀,还有 8 倍以上的图片数上限收缩。
同时所有图片的总 Token 数必须小于模型最大输入,官方加了 blockquote 强调。这是第二重约束:单图都在限内,不代表多图能过。
Qwen-Omni 系列模型官方要求另见《全模态》文档,本轮未展开。
八、视频限制:时长上限差 180 倍
视频以图像列表传入时(官方《视频限制》):
| 模型系列 | 最少 | 最多 |
|---|---|---|
| qwen3.8 / 3.7 / 3.6 / 3.5 系列 | 4 张 | 8000 张 |
| qwen3-vl-plus 系列 | 4 张 | 2000 张 |
| 其他 Qwen3-VL 开源、Qwen2.5-VL(含商/开源)、QVQ 系列 | 4 张 | 512 张 |
| 其他模型 | 4 张 | 80 张 |
以视频文件传入时,时长上限:
| 模型系列 | 视频时长 |
|---|---|
| qwen3.8 / 3.7 / 3.6 / 3.5 系列 | 2 秒 ~ 2 小时 |
| qwen3-vl-plus 系列 | 2 秒 ~ 1 小时 |
| 其他 Qwen3-VL 开源系列 | 2 秒 ~ 20 分钟 |
| Qwen2.5-VL 开源系列、QVQ 系列 | 2 秒 ~ 10 分钟 |
| 其他模型 | 2 秒 ~ 40 秒 |
最长 2 小时 vs 最短 40 秒,差 180 倍。 官方还注明不支持对视频文件的音频进行理解 —— 传有声视频,音频轨被丢弃。视频数量上限为 64 个。
视频体积上限同样随系列变化:qwen3.8/3.7/3.6/3.5 系列公网 URL 不超过 2GB;Qwen2.5-VL 开源系列及 QVQ 系列不超过 1GB;其他模型不超过 150MB。Base64 传入视频则编码后字符串须小于 10MB。
九、OSS 内网地址是一个高频翻车点
官方在《文件传入方式》章节给出明确警告:
百炼服务无法访问 OSS 内网地址(endpoint 中带
-internal),传入内网地址会导致文件下载失败,返回InvalidParameter,message 为Failed to download multimodal content。
正确做法是用 OSS 公网域名或 OSS 临时签名 URL。
还有一条必须写在代码 review 清单里的要求:
为确保模型能成功下载文件,提供的公网 URL 的响应头中必须包含 Content-Length(文件大小)和 Content-Type(媒体类型,如 image/jpeg)。任一字段缺失或者错误将会导致文件下载失败。
也就是说,一个能正常用浏览器打开的 URL,如果响应头缺 Content-Length,传给百炼一样会失败。官方推荐上传至 OSS 或使用上传文件获取临时 URL获取公网 URL。
十、工程结论:按场景选参数的决策清单
把上面的规则翻译成可执行的判断:
| 你的场景 | 建议参数 | 理由 |
|---|---|---|
| 通用图像问答、成本敏感 | 默认值,vl_high_resolution_images=false |
2560 视觉 Token 足够描述性任务 |
| OCR、小字发票、密集文本 | vl_high_resolution_images=true |
默认缩放会丢细节,需 6.4× Token |
| 中等细节 + 控制成本 | 自定义 max_pixels |
在 2560~16384 Token 间连续可调 |
| 大批量离线处理 | OpenAI 兼容 Batch(文件输入),仅部分模型 | 官方明示提供 50% 成本折扣 |
| 视频超过 40 秒 | 必须选 qwen3.8/3.7/3.6/3.5 系列 | 其他模型上限仅 40 秒 |
| 超过 300 张图片 | 不用 Base64 | Base64 上限 250 张 < URL/路径档 256 张 |
| 需要读取 PDF/Word | 先转图片,或改用 Qwen-Long | 视觉模型不直接支持文本文件 |
另有两个生产环境要点。超时:非流式调用服务端上限不少于 300 秒,超时后响应体返回已生成内容,若响应头含 x-dashscope-partialresponse: true 说明本次触发超时,可用前缀续写把已生成内容追加进 messages 再次请求。客户端超时是独立限制:处理 4000×4000 这类大图时,SDK 客户端默认超时会先触发并抛出 APITimeoutError,OpenAI Python SDK 可用 client.with_options(timeout=1800.0) 延长,或改用 stream=True 流式输出。
十一、本文的证据口径与未知项
按可信度分三层:
一、官方文档明示:本文所有规格数字(32×32 / 28×28、2621440 / 1003520、16384、16777216 / 12845056、2048 / 256 / 250 张、20MB / 10MB / 64MB / 16 MiB、7MB / 100MB 分界、4K 与 8K 格式分界、视频 2 小时 / 40 秒、300 秒超时、50% Batch 折扣、每 Token +2 的公式、4 Token 下限)均逐字取自《图像与视频理解》页面,页面标注更新时间 2026-10-10 18:26:24。
二、我的算术换算(非官方报价):2560 与 1280 的默认 Token 量、6.4 倍与 12.8 倍的倍数、1619 px 边长、4000×3000 是 4.58 倍、4K 是 3.16 倍、30.6% 的像素信息差、2.56P→16.38P 的成本示意。均由官方给定数字直接推导,P 为占位符,官方定价请查控制台。
三、UNKNOWN(本轮明确未验证):
- 未调用任何 API,上述所有 Token 数均为公式估算,官方亦明示”估算结果仅供参考,实际用量以 API 响应为准”
vl_high_resolution_images在 Python 顶层传参与extra_body的行为差异来自官方文档说明,未做实测对比- 超分辨率开启后是否真的”更准”缺官方对照数据,官方只说适用于精细文本/微小物体场景
- 限流层面(视觉输入是否单独计限流)本文未覆盖,见限流文档
- Qwen-Omni 系列的图片数量限制未展开,见全模态
- 报错时如何按错误名分支,见错误码
- 本文未登录百炼控制台,控制台界面与实际扣费全部转引官方文档
十二、与已有千问百炼文章的分工
本文属”输入与计费单位层”,与站内既有文章不重叠:
| 站内文章 | 切入层 | 与本文的关系 |
|---|---|---|
| 阿里云百炼限流全表实测:162 张表里,同一个模型换个名字,RPM 能差 500 倍 | 容量侧(RPM/TPM) | 互补:本文讲单请求内的 Token 计量,限流讲每分钟能发多少 |
| 阿里云百炼「错误码」全表实测:128 个错误分组里,同一句话在 400 和 429 各挂了一遍 | 失败侧 | 互补:失败后如何按错误名分支,本文讲如何不出错 |
| 通义千问 / 阿里云百炼「新人免费额度」全解 | 额度侧 | 互补:免费额度给多少,本文讲额度怎么被消耗 |
| 阿里云百炼 Coding Plan 订阅制全解 | 订阅侧(请求次数) | 互补:订阅买的是调用次数,本文讲每次调用里图像占多少 |
来源与可核验链接
本文全部一手来源,均为阿里云官方文档站,抓取时间 2026-10-16 12:0x:
| 来源 | URL | 用途 |
|---|---|---|
| 图像与视频理解(本文主源,标注更新时间 2026-10-10 18:26:24) | https://help.aliyun.com/zh/model-studio/vision | token_pixels、max_pixels、文件限制、数量限制、Token 公式、超时 |
| 视觉理解模型列表 | https://help.aliyun.com/zh/model-studio/vision-model/ | 模型系列命名与入口 |
| 获取与配置 API Key | https://help.aliyun.com/zh/model-studio/get-api-key | API Key 获取路径 |
| Base URL 总览 | https://help.aliyun.com/zh/model-studio/base-url | 地域与工作空间域名(16 MiB 上限差异相关) |
| 上传文件获取临时 URL | https://help.aliyun.com/zh/model-studio/get-temporary-file-url | 公网 URL 获取方式 |
| Qwen-VL OCR 文档解析 | https://help.aliyun.com/zh/model-studio/qwen-vl-ocr | 文档解析能力定位 |
| 全模态(Qwen-Omni) | https://help.aliyun.com/zh/model-studio/omni | 图片数量限制(本文未展开) |
| 限流 | https://help.aliyun.com/zh/model-studio/rate-limit | 容量侧(本文未覆盖) |
| 错误码 | https://help.aliyun.com/zh/model-studio/error-code | 失败侧(本文未覆盖) |
| 百炼控制台视觉模型体验页 | https://bailian.console.aliyun.com/model/experience/vision | 在线体验入口(需登录,本文未访问) |
配图说明:三张截图均由 Playwright + Chromium 在 1440 宽视口下实拍阿里云帮助中心官方文档页面(deviceScaleFactor=2),已逐张目视确认内容真实、非 404 或占位页。第一张为《查看每个模型视觉 Token 对应的像素、Token 上限和像素上限》表格,第二张为《如何选择文件上传方式》表格,第三张为《图像限制》中的图片数量上限区域,第四张为《图像限制》中的图像格式对照区域。