
阿里云百炼限流全表实测:162 张表里,同一个模型换个名字,RPM 能差 500 倍
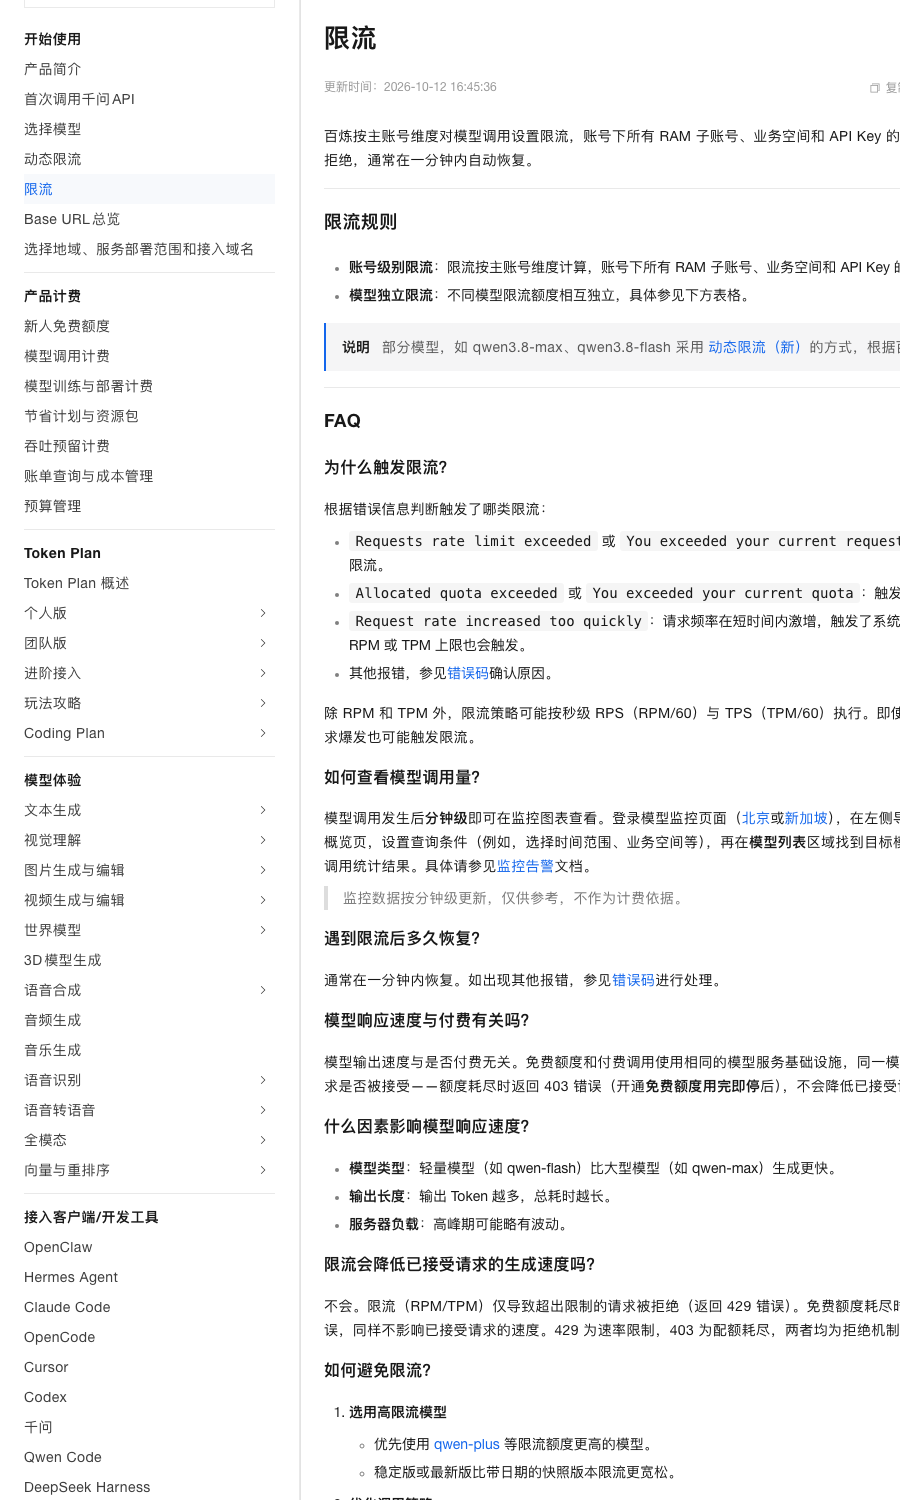
本文数据全部来自阿里云官方文档《限流》页面(页面标注更新时间 2026-10-12 16:45:36),由 timew 在 2026-10-15 12:0x 直接抓取该页 HTML 后逐表解析得到。文中所有 RPM / TPM 数字均可在官方原表逐行核对,未做任何估算或推断。凡官方未写的,本文一律标 UNKNOWN。
一、多数人第一次遇到 429,并不是因为”买得太少”
如果你在百炼上调模型,偶发撞到 429,多数人会先去充值。但官方 FAQ 里有一句话把这事说死了:
充值不改变模型默认的 RPM 和 TPM 限流阈值。限流按阿里云主账号维度配置,与计费相互独立;充值(按量付费)仅确保账号不因欠费停服,不会提升限流值。如需更高的限流额度,请联系商务经理申请。
这句话意味着:限流和你的钱包余额是两套完全独立的机制。你充值十万元,qwen-plus 在北京地域的 30,000 RPM 依然还是 30,000 RPM。真正能改变限流值的只有两个动作——换模型,或者联系商务。
而”换模型”这件事,恰好是这份文档里信息密度最高、也最被忽略的部分。本文把这张页面完整拆开:它一共包含 162 张限流表,覆盖 11 个模型家族、多个地域、多种第三方直供通道。真正的问题不是”你超了限流”,而是你以为的限流值和真实的限流值可能差 500 倍。
二、先搞清两个基础规则,否则你会算错所有账
官方在表格之前只给四条规则,但正是这四条决定了你怎么读后面的数字。
2.1 限流是按”主账号”算的,不是按 API Key 算的
账号级别限流:限流按主账号维度计算,账号下所有 RAM 子账号、业务空间和 API Key 的调用量合并计算。
这条经常被忽略。官方同页给的”如何查看模型调用量”里说:模型调用发生后分钟级即可在监控图表查看。所以在多人协作的团队里,一个同事的脚本跑飞,会把全公司主账号的配额吃掉。你在控制台看到的调用量是主账号合计,429 也是主账号合并触发的。
2.2 不同模型的配额互相独立
模型独立限流:不同模型限流额度相互独立,具体参见下方表格。
这是好消息也是坏消息:好消息是你不会因为刷文本模型而撞到图像模型的限流;坏消息是你也不能指望把一个模型的配额”匀”给另一个模型用。所谓”多模型混合负载均衡”只能缓解限流,绕不过去。
2.3 真正的不只是 RPM 和 TPM,还有 RPS 和 TPS
除 RPM 和 TPM 外,限流策略可能按秒级 RPS(RPM/60)与 TPS(TPM/60)执行。即使每分钟总调用量未超限,短时间内的请求爆发也可能触发限流。
这个细节在图像和视频模型上是决定性的。后面会看到,万相 wan2.6-t2i 在北京的 RPS 只有 1,也就是每秒只能发一次,哪怕你一分钟能发 5 次。
2.4 429 和 403 是两回事,别搞混
限流(RPM/TPM)仅导致超出限制的请求被拒绝(返回 429 错误)。免费额度耗尽时(开通免费额度用完即停)返回 403 错误,同样不影响已接受请求的速度。429 为速率限制,403 为配额耗尽,两者均为拒绝机制。
官方同时明确:限流不会降低已接受请求的生成速度。如果你发现”充值之后变慢了”,那不是限流导致的,是别的原因。
三、错误信息就是限流类型的诊断书
官方给了三类报错的判定方法,这套映射建议直接抄进你的告警规则:
| 报错信息 | 触发的是哪类限流 |
|---|---|
Requests rate limit exceeded / You exceeded your current requests list |
每分钟请求数(RPM) |
Allocated quota exceeded / You exceeded your current quota |
每分钟 Token 消耗(TPM) |
Request rate increased too quickly |
系统稳定性保护,即使总量未超限也会触发 |
第三类是最容易误判的一种。它不代表你的配额用完了,只代表你发得太急。官方给的解法是匀速调度、指数退避或请求队列。这也是为什么很多团队”明明监控面板上用量还很空,却一直报 429″——问题出在秒级突发,不在分钟总量。
四、最大的一条缝:稳定版和快照版差 500 倍
这是本文最值得你立刻拿去用的发现。
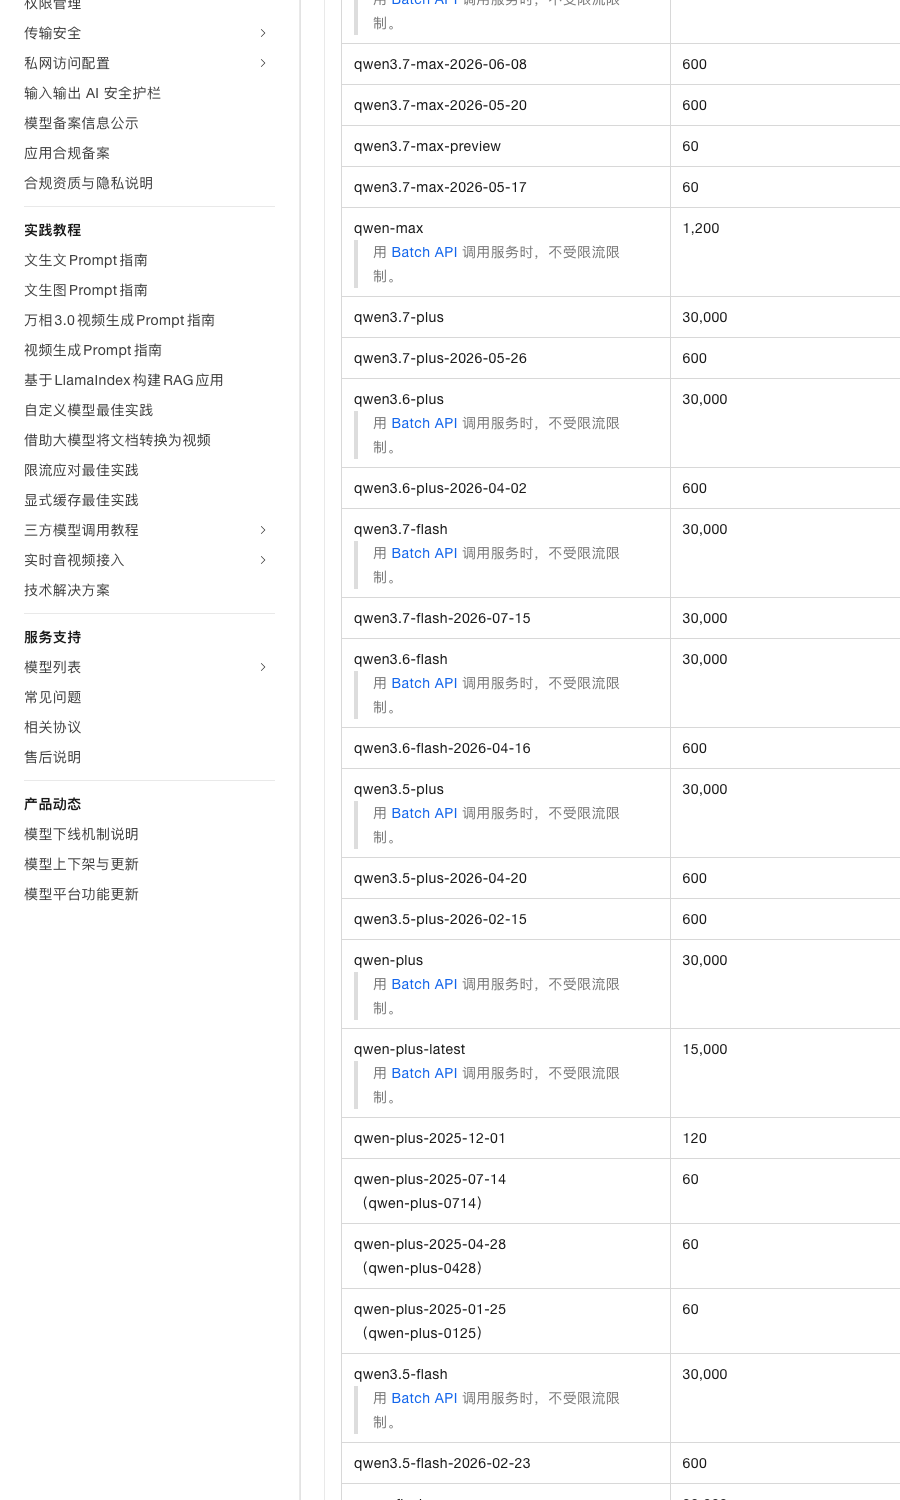
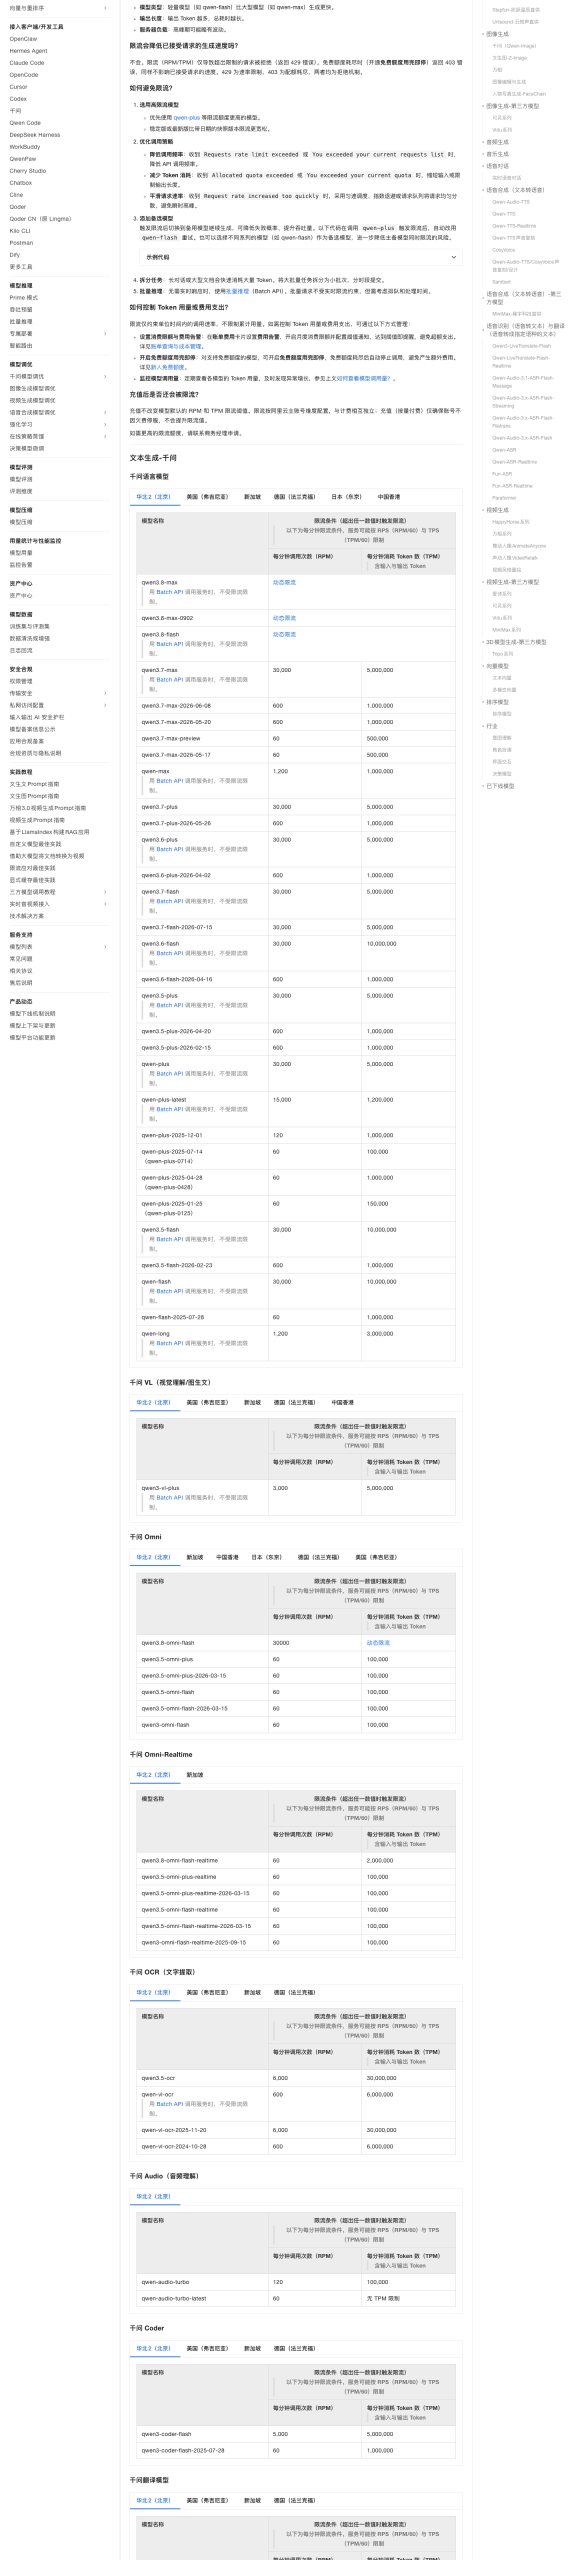
在华北2(北京)地域的千问语言模型表里,同一个模型家族的不同版本,RPM 差距极其悬殊:
| 模型 | RPM | TPM |
|---|---|---|
qwen-plus(稳定版) |
30,000 | 5,000,000 |
qwen-plus-latest |
15,000 | 1,200,000 |
qwen-plus-2025-12-01 |
120 | 1,000,000 |
qwen-plus-2025-07-14 |
60 | 100,000 |
qwen-plus-2025-04-28 |
60 | 1,000,000 |
qwen-plus-2025-01-25 |
60 | 150,000 |
qwen3.7-flash(稳定版) |
30,000 | 5,000,000 |
qwen3.7-flash-2026-07-15 |
30,000 | 5,000,000 |
两条可以直接当结论用的规律:
第一,带日期的快照版一律远低于同族稳定版。 qwen-plus 稳定版 30,000 RPM,而它最老的那个快照 qwen-plus-2025-01-25 只有 60 RPM——整整 500 倍。很多人为了”可复现”而锁定一个具体日期的模型版本,这个决定会让你的并发能力下降两个数量级。官方的建议原话是:“稳定版或最新版比带日期的快照版本限流更宽松。”
第二,qwen3.7-flash-2026-07-15 是个例外中的例外。 它虽然是快照版,RPM 却是 30,000,和稳定版完全一致。这说明快照版并不必然低配额——个别快照会被单独提额。所以别机械套规则,把你要用的那个确切版本号查一遍。
需要特别注意的是:几乎所有稳定版的备注里都写了 “用 Batch API 调用服务时,不受限流限制”,而大部分快照版没有这句。批量推理这条路对稳定版是完全敞开的。
五、第二个缝:同一个模型,换地域差 50 倍
美国(弗吉尼亚)地域的表,和全球口径对比之后出现了更极端的情况:
| 模型 | 全球 RPM | 美国 RPM | 倍差 |
|---|---|---|---|
qwen3.7-max |
30,000 | 600 | 50× |
qwen-plus |
15,000 | 600 | 25× |
qwen3.8-flash |
30,000 | 15,000 | 2× |
qwen3.7-plus |
30,000 | 15,000 | 2× |
qwen3.8-max |
30,000 | 30,000 | 1× |
qwen3.7-flash |
15,000 | 15,000 | 1× |
qwen-flash |
15,000 | 30,000 | 0.5× |
最后一行值得专门点出来:qwen-flash 在美国地域的 RPM 比全球口径高一倍。也就是说,美国不是所有模型都吃亏,个别模型反而更宽裕。
这一列数据在官方表里是以”服务部署范围”字段来区分的——同一个模型名会同时出现”全球”和”美国”两行。如果你只盯着第一行看,就会按错误的口径做容量规划。选地域不是选机房,是选配额。
顺带一提,qwen3.8-max-0902 是个特例:全球 30,000 RPM 但 TPM 只有 150,000,而 qwen3.8-max 是 30,000 / 5,000,000。同为 3.8 max,TPM 差 33 倍。高并发下这个差异会直接体现为吞吐塌方。
六、动态限流:14 个模型不公开具体数字
官方在这张页面上明确标注:
部分模型,如 qwen3.8-max、qwen3.8-flash 采用动态限流(新)的方式,根据百炼月消费档位进行软限流。
在 162 张表里,”动态限流”一共出现 16 次,涉及 8 个模型:
- 千问文本:
qwen3.8-max、qwen3.8-max-0902、qwen3.8-flash - 千问 Omni:
qwen3.8-omni-flash - 千问开源版:
qwen3.8-2.4t-a95b、qwen3.8-27b - DeepSeek:
deepseek-v4-pro-0813(北京、新加坡) - Kimi:
kimi-k3(北京、新加坡)
“根据月消费档位进行软限流”是这句话的关键。它意味着这些模型的限额不是一个公开常数,而是一个与你的消费额绑定、会浮动的值。这也顺带回答了第一节那个问题——虽然充值本身不直接提升限流,但如果你所在的消费档位足够高,动态限流模型的实际可用额度确实可能更高。
不过官方没有公开任何换算公式或档位阈值,这部分属于 UNKNOWN,本文不做推测。要拿准确数字,只能在自己的控制台看监控页实测。
七、第三方直供通道:同款模型,限流能差 500 倍
这是第三层被忽略的差异。百炼同时提供 DeepSeek、Kimi、GLM、MiniMax 等第三方模型,其中部分带”直供”通道——它们的限流和原生通道完全是两套数字:
| 通道 | 模型 | RPM | TPM |
|---|---|---|---|
| 原生 DeepSeek | deepseek-v4-pro |
15,000 | 1,200,000 |
| 快手万擎直供 | vanchin/deepseek-v4-pro |
60 | 300,000 |
| 快手万擎直供 | vanchin/deepseek-v4-pro-0813 |
30 | 600,000 |
| 原生 MiniMax | MiniMax-M2.5 |
500 | 1,000,000 |
| 稀宇科技直供 | MiniMax/MiniMax-M2.5 |
500 | 20,000,000 |
| 智谱直供 | ZHIPU/GLM-5.3 |
200 | 3,000,000 |
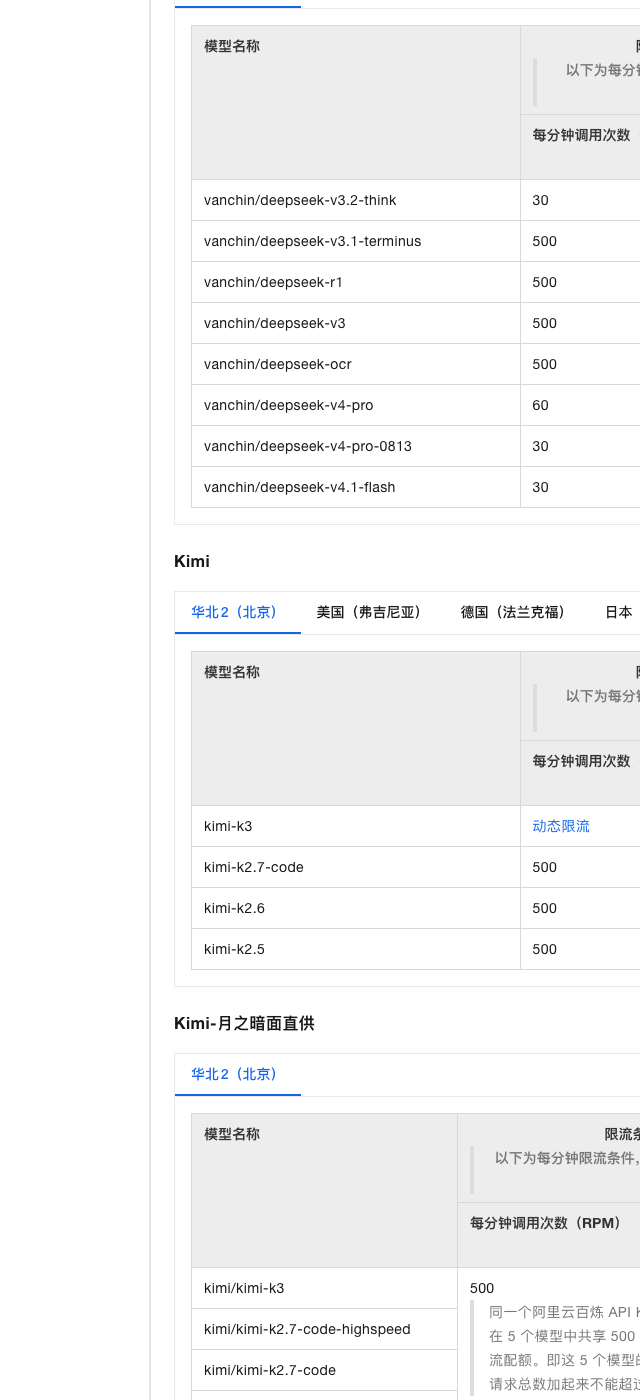
deepseek-v4-pro 原生 15,000 RPM,走万擎直供只剩 60 RPM,掉到 1/250。而反过来,MiniMax M2.5 走稀宇直供,TPM 从 1,000,000 涨到 20,000,000,涨了 20 倍。
所以”选通道”这件事,在百炼上是一个和”选模型”同等量级的决策。
八、共享配额:有些配额不是你以为的那个模型的
还有一类更隐蔽的规则,官方在表格单元格里直接用长句写明了:
- Kimi-月之暗面直供:同一个阿里云百炼 API Key 下,
kimi/kimi-k3、kimi-k2.7-code-highspeed、kimi-k2.7-code、kimi-k2.6、kimi-k2.5这 5 个模型共享 500 RPM 和 3,000,000 TPM。即这 5 个模型的每分钟请求总数加起来不能超过 500。 - 可灵系列:
kling/kling-v3-omni-image-generation等 5 个图像及视频模型共享 10 个并发数。 - Vidu 系列:参考生图系列 6 个模型共享 5 个并发数。
这意味着这些模型的实际可用并发,取决于你同时调了其中几个。用三个 Vidu 模型不等于三份额度,而是共用一份。压测时务必按”整组”而不是”单模型”来算。
九、图像和视频:限流单位根本不是 RPM
翻到文档下半部分的图像与视频章节,你会发现限流单位变了:
| 模型 | 任务下发限制 | 并发数 |
|---|---|---|
qwen-image-3.0-pro |
5 次/分钟 | 同步无限制 / 异步 10 |
qwen-image-2.1-pro |
20 次/分钟 | 同步无限制 / 异步 10 |
qwen-image-2.1-turbo |
120 次/分钟 | 同步无限制 / 异步 10 |
qwen-image-2.0-pro |
2 次/分钟 | 同步无限制 |
qwen-image-2.0 |
2 次/秒 | 同步无限制 |
qwen-mt-image |
1 次/秒 | 同步无限制 / 异步 2 |
qwen-image-2.0-pro 只有每分钟 2 次。2.0 的基础版反而放宽到 2 次/秒,而 pro 版被压回 2 次/分钟——这是本文全站最反直觉的一处。而且注意区分”次/分钟”和”次/秒”,两者差 60 倍。
视频侧的规律类似:万相 wan2.6-t2i 在北京 RPS=1、德国 RPS=1,而美国和新加坡都是 RPS=5——同一个模型换个地域差 5 倍。wan2.7-image 在北京和新加坡都是 5。
十、可以照抄的五条实操建议
官方 FAQ 自己给的建议加上本文的实测对照,可以整理成一份可直接落地的清单:
- 优先用稳定版,不要为了可复现锁快照版。
qwen-plus稳定版 30,000 RPM vs 最老快照 60 RPM,差 500 倍。确实需要固定版本时,先查那一行确切的数值——因为qwen3.7-flash-2026-07-15就没有这个问题。 - 把
Request rate increased too quickly单独做告警。 它代表突发而非配额耗尽,需要的是匀速队列或指数退避,加并发是没用的。 - 429 和 403 分开处理。 429 是速率问题(退避重试),403 是配额问题(需要调整额度或开关),混在一起重试只会放大故障。
- 批量任务走 Batch API。 稳定版备注里明确”用 Batch API 调用服务时,不受限流限制”,这是最干净的绕开路径。
- 跨地域前先查”服务部署范围”那一列。 同一个模型名在表里可能同时有”全球”和”美国”两行,容量规划要用对口径;并且要意识到充值不提升限流,只能换模型或找商务。
- 第三方直供按”共享配额”设计容量。 Kimi 直供 5 个模型共用 500 RPM,可灵 5 个模型共用 10 并发。压测时按整组算。
- 监控数据不作为计费依据。 官方原话:”监控数据按分钟级更新,仅供参考,不作为计费依据。” 排查用监控,对账用账单。
十一、口径与未知项声明
为避免把推断当事实,本文明确以下几点:
- 数据来源:仅阿里云官方《限流》文档页,抓取时间 2026-10-15 12:0x(Asia/Shanghai),页面自身标注更新时间 2026-10-12 16:45:36。本文解析了该页全部 162 张表格。
- 未验证项:本文所有数字均为官方表格原文转录,未在控制台实际发起调用做实测验证。真实运行中的动态限流模型(8 个)会随消费档位浮动,静态表值不代表实际可得额度。
- UNKNOWN:动态限流的换算公式与月消费档位阈值,官方未公开;文中未做任何推测。
- 抓取环境说明:同一次抓取中,官方文档站对不存在的路径(如
/zh/model-studio/limits)返回 HTTP 200 + 24,899B 且</code> 为”404错误页-阿里云帮助中心”。本文已在取值前校验页面标题与字节数,确认所用页面为真实内容页。</li> <li><strong>本文不涉及</strong>:账号内的实际配额、监控数据与账单数据,这些需要登录控制台查看,官方文档亦未公开。</li> </ul> <h2>十二、来源与可核验链接</h2> <ol class="wp-block-list"> <li>阿里云百炼《限流》官方文档(本文全部数据的唯一来源,页面标注更新时间 2026-10-12 16:45:36)</li> </ol> <p> <a rel="nofollow" href="https://help.aliyun.com/zh/model-studio/rate-limit" target="_blank" rel="noopener">https://help.aliyun.com/zh/model-studio/rate-limit</a></p> <ol class="wp-block-list"> <li>阿里云百炼《错误码》文档(FAQ 中引用的报错处理依据)</li> </ol> <p> <a rel="nofollow" href="https://help.aliyun.com/zh/model-studio/error-code" target="_blank" rel="noopener">https://help.aliyun.com/zh/model-studio/error-code</a></p> <ol class="wp-block-list"> <li>阿里云百炼《新人免费额度》文档(403 配额耗尽与”免费额度用完即停”机制)</li> </ol> <p> <a rel="nofollow" href="https://help.aliyun.com/zh/model-studio/new-free-quota" target="_blank" rel="noopener">https://help.aliyun.com/zh/model-studio/new-free-quota</a></p> <ol class="wp-block-list"> <li>阿里云百炼《模型列表》文档(核对各模型当前是否在售)</li> </ol> <p> <a rel="nofollow" href="https://help.aliyun.com/zh/model-studio/models" target="_blank" rel="noopener">https://help.aliyun.com/zh/model-studio/models</a></p> <ol class="wp-block-list"> <li>timew 站内相关文章:</li> </ol> <p> – 百炼新人免费额度全解:249 行定价表里的 7 种额度形态与 3 个扣费陷阱 <a href="https://timew.cn/2026/10/14/qwen-bailian-free-quota-7-types-249-rows-2026-10-14/" target="_blank" rel="noopener">https://timew.cn/2026/10/14/qwen-bailian-free-quota-7-types-249-rows-2026-10-14/</a> – Coding Plan 订阅制全解:200 元/月买的是请求次数不是 Token <a href="https://timew.cn/2026/10/14/qwen-bailian-coding-plan-subscription-request-quota-2026-10-14/" target="_blank" rel="noopener">https://timew.cn/2026/10/14/qwen-bailian-coding-plan-subscription-request-quota-2026-10-14/</a> – 百炼在售模型矩阵实时实证:30+ 在售模型与 48 小时零新模型 <a href="https://timew.cn/2026/10/12/qwen-bailing-matrix-2026-10-12-real-time-evidence/" target="_blank" rel="noopener">https://timew.cn/2026/10/12/qwen-bailing-matrix-2026-10-12-real-time-evidence/</a></p> <hr class="wp-block-separator"/> <p>*本文由 timew 站点自动发布流程生成。所有限流数值均可在上述官方文档对应表格中逐行核对;如发现官方页面更新导致数值变化,以官方页面为准。*</p> </article> <div class="post-actions"> <a href="javascript:;" rel="nofollow" etap="like" class="post-like action action-like" data-pid="2761"><i class="tbfa"></i>赞(<span>0</span>)</a> </div> <div class="post-copyright">未经允许不得转载:<a href="https://timew.cn">时间网</a> » <a href="https://timew.cn/2026/10/15/bailian-rate-limit-full-table-500x-rpm-gap-2026-10-15/">阿里云百炼限流全表实测:162 张表里,同一个模型换个名字,RPM 能差 500 倍</a></div> <div class="shares"><dfn>分享到</dfn><a rel="nofollow" href="javascript:;" data-url="https://timew.cn/2026/10/15/bailian-rate-limit-full-table-500x-rpm-gap-2026-10-15/" class="share-weixin" title="分享到微信"><i class="tbfa"></i></a><a rel="nofollow" etap="share" data-share="weibo" class="share-tsina" title="分享到微博"><i class="tbfa"></i></a><a rel="nofollow" etap="share" data-share="qq" class="share-sqq" title="分享到QQ好友"><i class="tbfa"></i></a><a rel="nofollow" etap="share" data-share="qzone" class="share-qzone" title="分享到QQ空间"><i class="tbfa"></i></a><a rel="nofollow" etap="share" data-share="line" class="share-line" title="分享到Line"><i class="tbfa"></i></a><a rel="nofollow" etap="share" data-share="twitter" class="share-twitter" title="分享到X"><i class="tbfa"></i></a><a rel="nofollow" etap="share" data-share="facebook" class="share-facebook" title="分享到Facebook"><i class="tbfa"></i></a><a rel="nofollow" etap="share" data-share="telegram" class="share-telegram" title="分享到Telegram"><i class="tbfa"></i></a><a rel="nofollow" etap="share" data-share="skype" class="share-skype" title="分享到Skype"><i class="tbfa"></i></a></div> <div class="article-tags"><a href="https://timew.cn/tag/api-%e9%99%90%e6%b5%81/" rel="tag">API 限流</a><a href="https://timew.cn/tag/qwen/" rel="tag">Qwen</a><a href="https://timew.cn/tag/qwen3/" rel="tag">qwen3</a><a href="https://timew.cn/tag/rpm/" rel="tag">RPM</a><a href="https://timew.cn/tag/tpm/" rel="tag">TPM</a><a href="https://timew.cn/tag/%e5%a4%a7%e6%a8%a1%e5%9e%8b-api/" rel="tag">大模型 API</a><a href="https://timew.cn/tag/tongyi-qianwen/" rel="tag">通义千问</a><a href="https://timew.cn/tag/aliyun-bailian/" rel="tag">阿里云百炼</a><a href="https://timew.cn/tag/%e9%99%90%e6%b5%81/" rel="tag">限流</a></div> <nav class="article-nav"> <span class="article-nav-prev">上一篇<br><a href="https://timew.cn/2026/10/15/workbuddy-account-cancellation-audit-15-day-cooling-2026-10-15/" rel="prev">WorkBuddy 账号注销制度审计:15 天冷静期 × 7 类阻断项 × 双站文档分叉(海外站无此页)</a></span> <span class="article-nav-next">下一篇<br><a href="https://timew.cn/2026/10/15/openclaw-ghsa-100-advisories-authorization-audit-2026-10-15/" rel="next">OpenClaw 的 100 条安全公告解剖:51 条高危里,有 49 条其实是同一类错</a></span> </nav> <div class="relates relates-imagetext"><div class="title"><h3>相关推荐</h3></div><ul><li><a href="https://timew.cn/2026/10/27/bailian-model-deprecation-notice-window-gte-rerank-32-days-2026-10-27/"><img data-src="https://timew.cn/wp-content/uploads/2026/10/qw1027-dep-notice-window-220x150.png" alt="百炼下线机制对账:承诺快照提前 30 天、主线提前 3 个月,GTE-RERANK 只给了 32 天;10 月 10 日那批 8 份公告,列表页只挂了 6 份-时间网" src="https://timew.cn/wp-content/themes/dux/assets/img/thumbnail.png" class="thumb"></a><a href="https://timew.cn/2026/10/27/bailian-model-deprecation-notice-window-gte-rerank-32-days-2026-10-27/">百炼下线机制对账:承诺快照提前 30 天、主线提前 3 个月,GTE-RERANK 只给了 32 天;10 月 10 日那批 8 份公告,列表页只挂了 6 份</a></li><li><a href="https://timew.cn/2026/10/25/bailian-rate-limit-two-ledgers-31-models-22-cross-region-2026-10-25/"><img data-src="https://timew.cn/wp-content/uploads/2026/10/bailian-rate-limit-beijing-qwen-lang-2026-10-25-220x150.png" alt="百炼限流两本账:31 个千问模型 22 个跨地域不一致,0902 快照两页差 10 倍-时间网" src="https://timew.cn/wp-content/themes/dux/assets/img/thumbnail.png" class="thumb"></a><a href="https://timew.cn/2026/10/25/bailian-rate-limit-two-ledgers-31-models-22-cross-region-2026-10-25/">百炼限流两本账:31 个千问模型 22 个跨地域不一致,0902 快照两页差 10 倍</a></li><li><a href="https://timew.cn/2026/10/24/kimi-k3-1-pro-1m-context-35-percent-cheaper-doc-mismatch-2026-10-24/"><img data-src="https://timew.cn/wp-content/uploads/2026/10/kimi-k3-1-pro-cover-220x150.png" alt="Kimi K3.1 Pro 实读:输入价降 35%、1M 上下文不变,官方文档里还有三处数字对不上-时间网" src="https://timew.cn/wp-content/themes/dux/assets/img/thumbnail.png" class="thumb"></a><a href="https://timew.cn/2026/10/24/kimi-k3-1-pro-1m-context-35-percent-cheaper-doc-mismatch-2026-10-24/">Kimi K3.1 Pro 实读:输入价降 35%、1M 上下文不变,官方文档里还有三处数字对不上</a></li><li><a href="https://timew.cn/2026/10/19/qwen-omni-realtime-context-limits-and-cumulative-input-tokens-2026-10-19/"><img data-src="https://timew.cn/wp-content/uploads/2026/10/shot1-access-220x150.png" alt="Qwen-Omni-Realtime 实时多模态实测:3 个型号上下文上限各不相同,输入 Token 会逐轮累积重算-时间网" src="https://timew.cn/wp-content/themes/dux/assets/img/thumbnail.png" class="thumb"></a><a href="https://timew.cn/2026/10/19/qwen-omni-realtime-context-limits-and-cumulative-input-tokens-2026-10-19/">Qwen-Omni-Realtime 实时多模态实测:3 个型号上下文上限各不相同,输入 Token 会逐轮累积重算</a></li><li><a href="https://timew.cn/2026/10/18/bailian-text-embedding-9-dimensions-dup-params-2026-10-18/"><img data-src="https://timew.cn/wp-content/uploads/2026/10/02_dims_param-220x150.png" alt="百炼文本向量 Embedding 全台账:9 档向量维度、两个同名参数互相打架,还有 3 个模型官方自己前后不一-时间网" src="https://timew.cn/wp-content/themes/dux/assets/img/thumbnail.png" class="thumb"></a><a href="https://timew.cn/2026/10/18/bailian-text-embedding-9-dimensions-dup-params-2026-10-18/">百炼文本向量 Embedding 全台账:9 档向量维度、两个同名参数互相打架,还有 3 个模型官方自己前后不一</a></li><li><a href="https://timew.cn/2026/10/18/bailian-batch-inference-1mb-vs-6mb-and-18-models-2026-10-18/"><img data-src="https://timew.cn/wp-content/uploads/2026/10/shot1-scope-220x150.png" alt="百炼批量推理实测:同一份官方文档写了两套限制,6 个模型在定价表里没有 Batch 半价-时间网" src="https://timew.cn/wp-content/themes/dux/assets/img/thumbnail.png" class="thumb"></a><a href="https://timew.cn/2026/10/18/bailian-batch-inference-1mb-vs-6mb-and-18-models-2026-10-18/">百炼批量推理实测:同一份官方文档写了两套限制,6 个模型在定价表里没有 Batch 半价</a></li><li><a href="https://timew.cn/2026/10/17/bailian-function-calling-tool-choice-matrix-2026-10-17/"><img data-src="https://timew.cn/wp-content/uploads/2026/10/shot1_models-scaled-220x150.png" alt="百炼工具调用能力矩阵实测:63 个模型条目里,Qwen 全系列不支持 tool_choice="required",思考模式下直接报错-时间网" src="https://timew.cn/wp-content/themes/dux/assets/img/thumbnail.png" class="thumb"></a><a href="https://timew.cn/2026/10/17/bailian-function-calling-tool-choice-matrix-2026-10-17/">百炼工具调用能力矩阵实测:63 个模型条目里,Qwen 全系列不支持 tool_choice="required",思考模式下直接报错</a></li><li><a href="https://timew.cn/2026/10/17/bailian-context-cache-explicit-125-hit-10-2026-10-17/"><img data-src="https://timew.cn/wp-content/uploads/2026/10/shot1_explicit_cache-scaled-220x150.png" alt="百炼上下文缓存实测:显式缓存创建先按 125% 预付、命中才回落 10%,同一个前缀只复用一次反而更贵-时间网" src="https://timew.cn/wp-content/themes/dux/assets/img/thumbnail.png" class="thumb"></a><a href="https://timew.cn/2026/10/17/bailian-context-cache-explicit-125-hit-10-2026-10-17/">百炼上下文缓存实测:显式缓存创建先按 125% 预付、命中才回落 10%,同一个前缀只复用一次反而更贵</a></li></ul></div> </div> </div> <div class="sidebar"> <div class="widget widget_search"><h3>搜索</h3><form method="get" class="site-search-form" action="https://timew.cn/"> <input class="search-input" name="s" type="text" placeholder="输入关键字" value="" required="required"> <button class="search-btn" type="submit"><i class="tbfa"></i></button> </form></div> <div class="widget widget_recent_entries"> <h3>最新文章</h3> <ul> <li> <a href="https://timew.cn/2026/10/28/openclaw-plugin-three-ledgers-75-doc-66-npm-72-local-39-loaded-2026-10-28/">OpenClaw 2026.10.8 的插件三本账:文档说核心包自带 75 个,npm 包里只有 66 个,本机 72 个里 39 个加载</a> </li> <li> <a href="https://timew.cn/2026/10/27/workbuddy-cn-sitemap-comment-9-candidate-urls-7-404-codebuddy-2026-10-27/">WorkBuddy 官网 sitemap 注释里挂着 9 个候选页面:7 个打开是 404,/blog 和 /privacy 是 CodeBuddy 的同一份页面</a> </li> <li> <a href="https://timew.cn/2026/10/27/bailian-model-deprecation-notice-window-gte-rerank-32-days-2026-10-27/">百炼下线机制对账:承诺快照提前 30 天、主线提前 3 个月,GTE-RERANK 只给了 32 天;10 月 10 日那批 8 份公告,列表页只挂了 6 份</a> </li> <li> <a href="https://timew.cn/2026/10/27/openclaw-docs-cli-cjk-zero-hits-721-zh-pages-2026-10-27/">OpenClaw 的 docs 命令不认中文:8 条中文查询全部 0 命中,文档站上却有 721 页中文</a> </li> <li> <a href="https://timew.cn/2026/10/26/openclaw-security-audit-32-scenarios-10-critical-exit-0-2026-10-26/">OpenClaw security audit 实测 32 个配置:10 个报 critical,退出码一次都没变</a> </li> </ul> </div><div class="widget_text widget widget_custom_html"><h3>站点信息</h3><div class="textwidget custom-html-widget"><ul> <li><a href="/about/">关于我们</a></li> <li><a href="/contact/">联系我们</a></li> <li><a href="/privacy-policy/">隐私政策</a></li> <li><a href="/cookie-policy/">Cookie 说明</a></li> <li><a href="/disclaimer/">免责声明</a></li> <li><a href="/terms/">服务条款</a></li> </ul></div></div><div class="widget widget_meta"><h3>其他操作</h3> <ul> <li><a href="https://timew.cn/wp-login.php">登录</a></li> <li><a href="https://timew.cn/feed/">条目 feed</a></li> <li><a href="https://timew.cn/comments/feed/">评论 feed</a></li> <li><a href="https://cn.wordpress.org/">WordPress.org</a></li> </ul> </div><div class="widget widget_search"><h3>搜索</h3><form method="get" class="site-search-form" action="https://timew.cn/"> <input class="search-input" name="s" type="text" placeholder="输入关键字" value="" required="required"> <button class="search-btn" type="submit"><i class="tbfa"></i></button> </form></div> <div class="widget widget_recent_entries"> <h3>最新文章</h3> <ul> <li> <a href="https://timew.cn/2026/10/28/openclaw-plugin-three-ledgers-75-doc-66-npm-72-local-39-loaded-2026-10-28/">OpenClaw 2026.10.8 的插件三本账:文档说核心包自带 75 个,npm 包里只有 66 个,本机 72 个里 39 个加载</a> </li> <li> <a href="https://timew.cn/2026/10/27/workbuddy-cn-sitemap-comment-9-candidate-urls-7-404-codebuddy-2026-10-27/">WorkBuddy 官网 sitemap 注释里挂着 9 个候选页面:7 个打开是 404,/blog 和 /privacy 是 CodeBuddy 的同一份页面</a> </li> <li> <a href="https://timew.cn/2026/10/27/bailian-model-deprecation-notice-window-gte-rerank-32-days-2026-10-27/">百炼下线机制对账:承诺快照提前 30 天、主线提前 3 个月,GTE-RERANK 只给了 32 天;10 月 10 日那批 8 份公告,列表页只挂了 6 份</a> </li> <li> <a href="https://timew.cn/2026/10/27/openclaw-docs-cli-cjk-zero-hits-721-zh-pages-2026-10-27/">OpenClaw 的 docs 命令不认中文:8 条中文查询全部 0 命中,文档站上却有 721 页中文</a> </li> <li> <a href="https://timew.cn/2026/10/26/openclaw-security-audit-32-scenarios-10-critical-exit-0-2026-10-26/">OpenClaw security audit 实测 32 个配置:10 个报 critical,退出码一次都没变</a> </li> </ul> </div><div class="widget widget_tag_cloud"><h3>热门标签</h3><div class="tagcloud"><a href="https://timew.cn/tag/agent/" class="tag-cloud-link tag-link-296 tag-link-position-1" style="font-size: 8pt;" aria-label="Agent (4 项)">Agent</a> <a href="https://timew.cn/tag/ai-2/" class="tag-cloud-link tag-link-63 tag-link-position-2" style="font-size: 21.681818181818pt;" aria-label="AI (35 项)">AI</a> <a href="https://timew.cn/tag/ai-agent/" class="tag-cloud-link tag-link-77 tag-link-position-3" style="font-size: 14.522727272727pt;" aria-label="AI Agent (12 项)">AI Agent</a> <a href="https://timew.cn/tag/ai-%e5%8a%9e%e5%85%ac/" class="tag-cloud-link tag-link-597 tag-link-position-4" style="font-size: 10.386363636364pt;" aria-label="AI 办公 (6 项)">AI 办公</a> <a href="https://timew.cn/tag/ai%e5%8a%9e%e5%85%ac/" class="tag-cloud-link tag-link-55 tag-link-position-5" style="font-size: 9.2727272727273pt;" aria-label="AI办公 (5 项)">AI办公</a> <a href="https://timew.cn/tag/ai-tools/" class="tag-cloud-link tag-link-320 tag-link-position-6" style="font-size: 11.181818181818pt;" aria-label="AI工具 (7 项)">AI工具</a> <a href="https://timew.cn/tag/ai%e5%b7%a5%e5%85%b7%e8%af%84%e6%b5%8b/" class="tag-cloud-link tag-link-484 tag-link-position-7" style="font-size: 20.886363636364pt;" aria-label="AI工具评测 (31 项)">AI工具评测</a> <a href="https://timew.cn/tag/atomic-updates/" class="tag-cloud-link tag-link-413 tag-link-position-8" style="font-size: 8pt;" aria-label="Atomic Updates (4 项)">Atomic Updates</a> <a href="https://timew.cn/tag/changelog/" class="tag-cloud-link tag-link-473 tag-link-position-9" style="font-size: 11.181818181818pt;" aria-label="CHANGELOG (7 项)">CHANGELOG</a> <a href="https://timew.cn/tag/dashscope/" class="tag-cloud-link tag-link-519 tag-link-position-10" style="font-size: 11.181818181818pt;" aria-label="DashScope (7 项)">DashScope</a> <a href="https://timew.cn/tag/extended-stable/" class="tag-cloud-link tag-link-440 tag-link-position-11" style="font-size: 8pt;" aria-label="Extended-Stable (4 项)">Extended-Stable</a> <a href="https://timew.cn/tag/npm-%e7%89%88%e6%9c%ac%e7%ae%a1%e7%90%86/" class="tag-cloud-link tag-link-773 tag-link-position-12" style="font-size: 9.2727272727273pt;" aria-label="npm 版本管理 (5 项)">npm 版本管理</a> <a href="https://timew.cn/tag/openclaw/" class="tag-cloud-link tag-link-411 tag-link-position-13" style="font-size: 22pt;" aria-label="OpenClaw (37 项)">OpenClaw</a> <a href="https://timew.cn/tag/openclaw-%e5%8f%91%e5%b8%83%e8%8a%82%e5%a5%8f/" class="tag-cloud-link tag-link-680 tag-link-position-14" style="font-size: 9.2727272727273pt;" aria-label="OpenClaw 发布节奏 (5 项)">OpenClaw 发布节奏</a> <a href="https://timew.cn/tag/openclaw-governance/" class="tag-cloud-link tag-link-602 tag-link-position-15" style="font-size: 9.2727272727273pt;" aria-label="OpenClaw 治理 (5 项)">OpenClaw 治理</a> <a href="https://timew.cn/tag/qwen/" class="tag-cloud-link tag-link-420 tag-link-position-16" style="font-size: 18.181818181818pt;" aria-label="Qwen (21 项)">Qwen</a> <a href="https://timew.cn/tag/qwen3-8b/" class="tag-cloud-link tag-link-552 tag-link-position-17" style="font-size: 9.2727272727273pt;" aria-label="Qwen3-8B (5 项)">Qwen3-8B</a> <a href="https://timew.cn/tag/workbuddy/" class="tag-cloud-link tag-link-392 tag-link-position-18" style="font-size: 21.681818181818pt;" aria-label="WorkBuddy (35 项)">WorkBuddy</a> <a href="https://timew.cn/tag/workbuddy-5-7-5/" class="tag-cloud-link tag-link-567 tag-link-position-19" style="font-size: 9.2727272727273pt;" aria-label="WorkBuddy 5.7.5 (5 项)">WorkBuddy 5.7.5</a> <a href="https://timew.cn/tag/workbuddy-5-7-6/" class="tag-cloud-link tag-link-637 tag-link-position-20" style="font-size: 9.2727272727273pt;" aria-label="WorkBuddy 5.7.6 (5 项)">WorkBuddy 5.7.6</a> <a href="https://timew.cn/tag/workbuddy-%e6%9b%b4%e6%96%b0%e6%97%a5%e5%bf%97/" class="tag-cloud-link tag-link-755 tag-link-position-21" style="font-size: 9.2727272727273pt;" aria-label="WorkBuddy 更新日志 (5 项)">WorkBuddy 更新日志</a> <a href="https://timew.cn/tag/ai/" class="tag-cloud-link tag-link-11 tag-link-position-22" style="font-size: 15.636363636364pt;" aria-label="人工智能 (14 项)">人工智能</a> <a href="https://timew.cn/tag/%e5%86%9b%e4%ba%8b/" class="tag-cloud-link tag-link-66 tag-link-position-23" style="font-size: 14.045454545455pt;" aria-label="军事 (11 项)">军事</a> <a href="https://timew.cn/tag/qianwen/" class="tag-cloud-link tag-link-419 tag-link-position-24" style="font-size: 15.636363636364pt;" aria-label="千问 (14 项)">千问</a> <a href="https://timew.cn/tag/%e5%8e%86%e5%8f%b2/" class="tag-cloud-link tag-link-67 tag-link-position-25" style="font-size: 12.772727272727pt;" aria-label="历史 (9 项)">历史</a> <a href="https://timew.cn/tag/%e5%a4%9a%e6%a8%a1%e6%80%81%e5%a4%a7%e6%a8%a1%e5%9e%8b/" class="tag-cloud-link tag-link-511 tag-link-position-26" style="font-size: 10.386363636364pt;" aria-label="多模态大模型 (6 项)">多模态大模型</a> <a href="https://timew.cn/tag/%e5%ae%89%e5%85%a8/" class="tag-cloud-link tag-link-64 tag-link-position-27" style="font-size: 12.772727272727pt;" aria-label="安全 (9 项)">安全</a> <a href="https://timew.cn/tag/%e6%95%88%e7%8e%87%e5%b7%a5%e5%85%b7/" class="tag-cloud-link tag-link-270 tag-link-position-28" style="font-size: 10.386363636364pt;" aria-label="效率工具 (6 项)">效率工具</a> <a href="https://timew.cn/tag/%e6%95%88%e7%8e%87%e6%8f%90%e5%8d%87/" class="tag-cloud-link tag-link-131 tag-link-position-29" style="font-size: 8pt;" aria-label="效率提升 (4 项)">效率提升</a> <a href="https://timew.cn/tag/%e6%97%85%e6%b8%b8/" class="tag-cloud-link tag-link-57 tag-link-position-30" style="font-size: 11.181818181818pt;" aria-label="旅游 (7 项)">旅游</a> <a href="https://timew.cn/tag/%e6%97%b6%e9%97%b4%e7%bd%91/" class="tag-cloud-link tag-link-170 tag-link-position-31" style="font-size: 8pt;" aria-label="时间网 (4 项)">时间网</a> <a href="https://timew.cn/tag/%e6%b1%bd%e8%bd%a6/" class="tag-cloud-link tag-link-68 tag-link-position-32" style="font-size: 8pt;" aria-label="汽车 (4 项)">汽车</a> <a href="https://timew.cn/tag/hotpot/" class="tag-cloud-link tag-link-16 tag-link-position-33" style="font-size: 8pt;" aria-label="火锅 (4 项)">火锅</a> <a href="https://timew.cn/tag/%e7%89%88%e6%9c%ac%e7%ae%a1%e7%90%86/" class="tag-cloud-link tag-link-753 tag-link-position-34" style="font-size: 10.386363636364pt;" aria-label="版本管理 (6 项)">版本管理</a> <a href="https://timew.cn/tag/%e7%94%9f%e6%b4%bb/" class="tag-cloud-link tag-link-397 tag-link-position-35" style="font-size: 11.181818181818pt;" aria-label="生活 (7 项)">生活</a> <a href="https://timew.cn/tag/tech/" class="tag-cloud-link tag-link-14 tag-link-position-36" style="font-size: 19.136363636364pt;" aria-label="科技 (24 项)">科技</a> <a href="https://timew.cn/tag/%e7%a7%91%e6%99%ae/" class="tag-cloud-link tag-link-65 tag-link-position-37" style="font-size: 11.181818181818pt;" aria-label="科普 (7 项)">科普</a> <a href="https://timew.cn/tag/headphones/" class="tag-cloud-link tag-link-15 tag-link-position-38" style="font-size: 11.181818181818pt;" aria-label="耳机 (7 项)">耳机</a> <a href="https://timew.cn/tag/%e8%81%8c%e5%9c%ba/" class="tag-cloud-link tag-link-371 tag-link-position-39" style="font-size: 8pt;" aria-label="职场 (4 项)">职场</a> <a href="https://timew.cn/tag/%e8%85%be%e8%ae%af/" class="tag-cloud-link tag-link-393 tag-link-position-40" style="font-size: 8pt;" aria-label="腾讯 (4 项)">腾讯</a> <a href="https://timew.cn/tag/%e8%b5%84%e8%ae%af/" class="tag-cloud-link tag-link-398 tag-link-position-41" style="font-size: 10.386363636364pt;" aria-label="资讯 (6 项)">资讯</a> <a href="https://timew.cn/tag/tongyi-qianwen/" class="tag-cloud-link tag-link-424 tag-link-position-42" style="font-size: 17.863636363636pt;" aria-label="通义千问 (20 项)">通义千问</a> <a href="https://timew.cn/tag/aliyun-bailian/" class="tag-cloud-link tag-link-570 tag-link-position-43" style="font-size: 14.522727272727pt;" aria-label="阿里云百炼 (12 项)">阿里云百炼</a> <a href="https://timew.cn/tag/%e9%98%bf%e9%87%8c%e4%ba%91%e7%99%be%e7%82%bc/" class="tag-cloud-link tag-link-555 tag-link-position-44" style="font-size: 10.386363636364pt;" aria-label="阿里云百炼 (6 项)">阿里云百炼</a> <a href="https://timew.cn/tag/ali-qwen/" class="tag-cloud-link tag-link-423 tag-link-position-45" style="font-size: 8pt;" aria-label="阿里千问 (4 项)">阿里千问</a></div> </div></div></section> <div class="branding"> <div class="container"> <h2>更好的WordPress主题</h2> <h4>支持快讯、专题、百度收录推送、人机验证、多级分类筛选器,适用于垂直站点、科技博客、个人站,扁平化设计、简洁白色、超多功能配置、会员中心、直达链接、文章图片弹窗、自动缩略图等...</h4> <a target="_blank" class="btn btn-primary" href="https://themebetter.com">联系我们<i class="tbfa"></i></a><a target="_blank" class="btn btn-primary" href="https://themebetter.com">联系我们<i class="tbfa"></i></a> </div> </div><footer class="footer"> <div class="container"> <p>© 2010-2026 <a href="https://timew.cn">时间网</a> 本站主题由 <a href="https://themebetter.com" target="_blank">themebetter</a> 提供 <a href="https://timew.cn/sitemap.xml">网站地图</a> <a href="https://beian.miit.gov.cn/" target="_blank" rel="nofollow noopener">沪ICP备2023033350号-1</a></p> </div> </footer> <div class="karbar karbar-rb"><ul><li class="karbar-totop"><a rel="nofollow" href="javascript:(TBUI.scrollTo());"><i class="tbfa"></i><span>回顶部</span></a></li></ul></div> <div class="sign"> <div class="sign-mask"></div> <div class="sign-tips"></div> <form class="-in"> <h4><small class="signup-loader">切换注册</small>登录</h4> <div class="-item"> <label>用户名或邮箱</label> <input type="text" name="username" class="ipt" placeholder="用户名或邮箱"> </div> <div class="-item"> <a href="">找回密码</a> <label>密码</label> <input type="password" name="password" class="ipt" placeholder="登录密码"> </div> <div class="sign-submit"> <input type="button" class="btn btn-primary btn-block signinsubmit-loader" name="submit" value="登录" id="site_login"> <input type="hidden" name="action" value="signin"> <label><input type="checkbox" checked="checked" name="remember" value="forever">记住我</label> </div> </form> <form class="-up"> <h4><small class="signin-loader">切换登录</small>注册</h4> <div class="-item"> <label>用户名</label> <input type="text" name="name" class="ipt" placeholder="设置用户名"> </div> <div class="-item"> <label>邮箱</label> <input type="email" name="email" class="ipt" placeholder="邮箱"> </div> <div class="-item -item-yzm"> <label>邮箱验证码</label> <input type="text" name="captcha" class="ipt" placeholder="验证码"> <input type="button" class="btn btn-default signcaptcha-loader" value="获取验证码"> </div> <div class="-item"> <label>设置密码</label> <input type="password" name="password" class="ipt" placeholder="设置6位以上的密码"> </div> <div class="sign-submit"> <input type="button" class="btn btn-primary btn-block signupsubmit-loader" name="submit" value="快速注册" id="site_register"> <input type="hidden" name="action" value="signup"> </div> </form> </div> <script>window.TBUI={"www":"https:\/\/timew.cn","uri":"https:\/\/timew.cn\/wp-content\/themes\/dux","ajaxurl":"https:\/\/timew.cn\/wp-admin\/admin-ajax.php","ver":"9.6","roll":"1 2","copyoff":0,"ajaxpager":"5","fullimage":"1","captcha":0,"captcha_comment":1,"captcha_login":1,"captcha_register":1,"table_scroll_m":1,"table_scroll_w":"800","pre_color":1,"pre_copy":1,"lang":{"copy":"\u590d\u5236","copy_success":"\u5df2\u590d\u5236","comment_loading":"\u8bc4\u8bba\u63d0\u4ea4\u4e2d...","comment_cancel_edit":"\u53d6\u6d88\u7f16\u8f91","loadmore":"\u52a0\u8f7d\u66f4\u591a","like_login":"\u70b9\u8d5e\u8bf7\u5148\u767b\u5f55","liked":"\u4f60\u5df2\u8d5e\uff01","delete_post":"\u786e\u5b9a\u5220\u9664\u8fd9\u4e2a\u6587\u7ae0\u5417\uff1f","read_post_all":"\u70b9\u51fb\u9605\u8bfb\u4f59\u4e0b\u5168\u6587","copy_wechat":"\u5fae\u4fe1\u53f7\u5df2\u590d\u5236","sign_password_less":"\u5bc6\u7801\u592a\u77ed\uff0c\u81f3\u5c116\u4f4d","sign_username_none":"\u7528\u6237\u540d\u4e0d\u80fd\u4e3a\u7a7a","sign_email_error":"\u90ae\u7bb1\u683c\u5f0f\u9519\u8bef","sign_vcode_loading":"\u9a8c\u8bc1\u7801\u83b7\u53d6\u4e2d","sign_vcode_new":" \u79d2\u91cd\u65b0\u83b7\u53d6"},"turnstile_key":""}</script> <script type="speculationrules"> {"prefetch":[{"source":"document","where":{"and":[{"href_matches":"/*"},{"not":{"href_matches":["/wp-*.php","/wp-admin/*","/wp-content/uploads/*","/wp-content/*","/wp-content/plugins/*","/wp-content/themes/dux/*","/*\\?(.+)"]}},{"not":{"selector_matches":"a[rel~=\"nofollow\"]"}},{"not":{"selector_matches":".no-prefetch, .no-prefetch a"}}]},"eagerness":"conservative"}]} </script> <script id="wp-copy-rights-script-js-extra"> var wpCopyRightsSettings = {"options":{"switch":true,"disable_right_click":true,"disable_select_text":true,"disable_drag_image":true,"disable_f12":true,"disable_ctrl_shift_i":false,"disable_ctrl_shift_j":false,"disable_print":true,"disable_view_source":true,"disable_save_page":true,"disable_select_all":true,"disable_copy_content":true,"disable_cut_content":true,"enable_adminer":true,"enable_loginer":true,"enable_devtools_open_notice":false,"enable_devtools_side_dock_notice":false,"devtools_notice_custom_line":"","enable_endcopyrights":false,"enable_watermark":false,"enable_watermark_member":false,"watermark_member_mode":"nickname","watermark_member_custom":"","custom_message":"","watermark_text":"","watermark_font_size":24,"watermark_color":"#000000","watermark_angle":-30,"watermark_opacity":0.1,"watermark_gap_x":220,"watermark_gap_y":140,"exclude_pages":"","exclude_posts":"","exclude_categories":"","watermark_display_text":"","watermark_enabled":false},"messages":{"copyWarning":"","devtoolsOpenNotice":"\u68c0\u6d4b\u5230\u60a8\u53ef\u80fd\u6253\u5f00\u4e86\u5f00\u53d1\u8005\u5de5\u5177\uff0c\u8bf7\u5173\u95ed\u540e\u6b63\u5e38\u6d4f\u89c8\u3002\u672c\u7ad9\u5185\u5bb9\u53d7\u7248\u6743\u4fdd\u62a4\u3002","devtoolsOpenNoticeHint":"\u7f51\u7ad9\u65e0\u6cd5\u66ff\u60a8\u81ea\u52a8\u5173\u95ed\u6d4f\u89c8\u5668\u5f00\u53d1\u8005\u5de5\u5177\u3002\u8bf7\u81ea\u884c\u5173\u95ed\u540e\u7ee7\u7eed\u4f7f\u7528\u3002","devtoolsOpenNoticeHintBottom":"\u5f53\u524d\u5224\u65ad\u4f9d\u636e\uff1a\u9875\u9762\u53ef\u89c6\u9ad8\u5ea6\u660e\u663e\u53d8\u5c0f\uff0c\u53ef\u80fd\u4e3a\u5e95\u90e8\u505c\u9760\u7684\u5f00\u53d1\u8005\u5de5\u5177\u3002\u8bf7\u5173\u95ed\u5f00\u53d1\u8005\u5de5\u5177\u9762\u677f\uff0c\u6216\u5c06\u5176\u6539\u4e3a\u72ec\u7acb\u7a97\u53e3\u540e\u518d\u7ee7\u7eed\u6d4f\u89c8\u3002","devtoolsOpenNoticeHintSide":"\u5f53\u524d\u5224\u65ad\u4f9d\u636e\uff1a\u9875\u9762\u53ef\u89c6\u5bbd\u5ea6\u660e\u663e\u53d8\u5c0f\uff0c\u53ef\u80fd\u4e3a\u5de6\u53f3\u505c\u9760\u7684\u5f00\u53d1\u8005\u5de5\u5177\u3002\u82e5\u60a8\u6253\u5f00\u7684\u662f\u6d4f\u89c8\u5668\u4fa7\u680f\u3001\u5782\u76f4\u6807\u7b7e\u9875\u6216\u6536\u85cf\u5939\uff0c\u5e76\u975e\u5f00\u53d1\u8005\u5de5\u5177\uff0c\u8bf7\u5173\u95ed\u4fa7\u680f\u540e\u70b9\u51fb\u300c\u6211\u77e5\u9053\u4e86\u300d\u3002","devtoolsOpenNoticeCustomLine":"","modalTitle":"\u63d0\u793a","modalDismiss":"\u6211\u77e5\u9053\u4e86","rightClickDisabled":"\u53f3\u952e\u529f\u80fd\u5df2\u7981\u7528","selectTextDisabled":"\u6587\u672c\u9009\u62e9\u529f\u80fd\u5df2\u7981\u7528","dragImageDisabled":"\u56fe\u7247\u62d6\u52a8\u529f\u80fd\u5df2\u7981\u7528","actionDisabled":"\u8be5\u64cd\u4f5c\u5df2\u88ab\u7981\u7528","copyDisabled":"\u590d\u5236\u529f\u80fd\u5df2\u7981\u7528","copyLimitExceeded":"\u5df2\u8d85\u8fc7\u6700\u5927\u590d\u5236\u6b21\u6570\u9650\u5236","copyWithCopyright":"\u5df2\u590d\u5236\u5185\u5bb9\u5e76\u6dfb\u52a0\u7248\u6743\u4fe1\u606f","copyrightSourceLabel":"\u672c\u6587\u6765\u6e90\uff1a","copyrightLinkLabel":"\u539f\u6587\u94fe\u63a5\uff1a","copyrightNotice":"\u7248\u6743\u58f0\u660e\uff1a\u672c\u6587\u4e3a\u539f\u521b\u6587\u7ae0\uff0c\u8f6c\u8f7d\u8bf7\u6ce8\u660e\u6765\u6e90\u3002"},"ajaxUrl":"https://timew.cn/wp-admin/admin-ajax.php","nonce":"68a76402e0"}; //# sourceURL=wp-copy-rights-script-js-extra </script> <script id="wp-copy-rights-script-js" src="https://timew.cn/wp-content/plugins/wpcopyrights/assets/js/protect.js"></script> <script id="loader-js" src="https://timew.cn/wp-content/themes/dux/assets/js/loader.js"></script> </body> </html>