聊大模型成本的时候,大多数人盯着”每百万 Token 多少钱”这一列。但真正决定你第一个月账单数字的,往往是另一列——免费额度。
2026 年 10 月 14 日,我们把阿里云百炼官方《模型调用价格》页面的完整 HTML 抓下来做了结构化解析。结果有点出人意料:这张表里带”免费额度”列的模型条目一共有 249 行,去掉分辨率阶梯行(720P、2K 这类被误解析成模型的续行)后是 239 个真实条目。这 239 个条目的”免费额度”字段,并不是一个统一口径的数字,而是 8 类结构完全不同的条目形态(其中 7 类是真正的”给多少”,1 类是”明确不给”)。
阿里云百炼《模型调用价格》页面表头,注意最右侧的「免费额度(注)」一列——本文 249 行额度数据即来自此列:
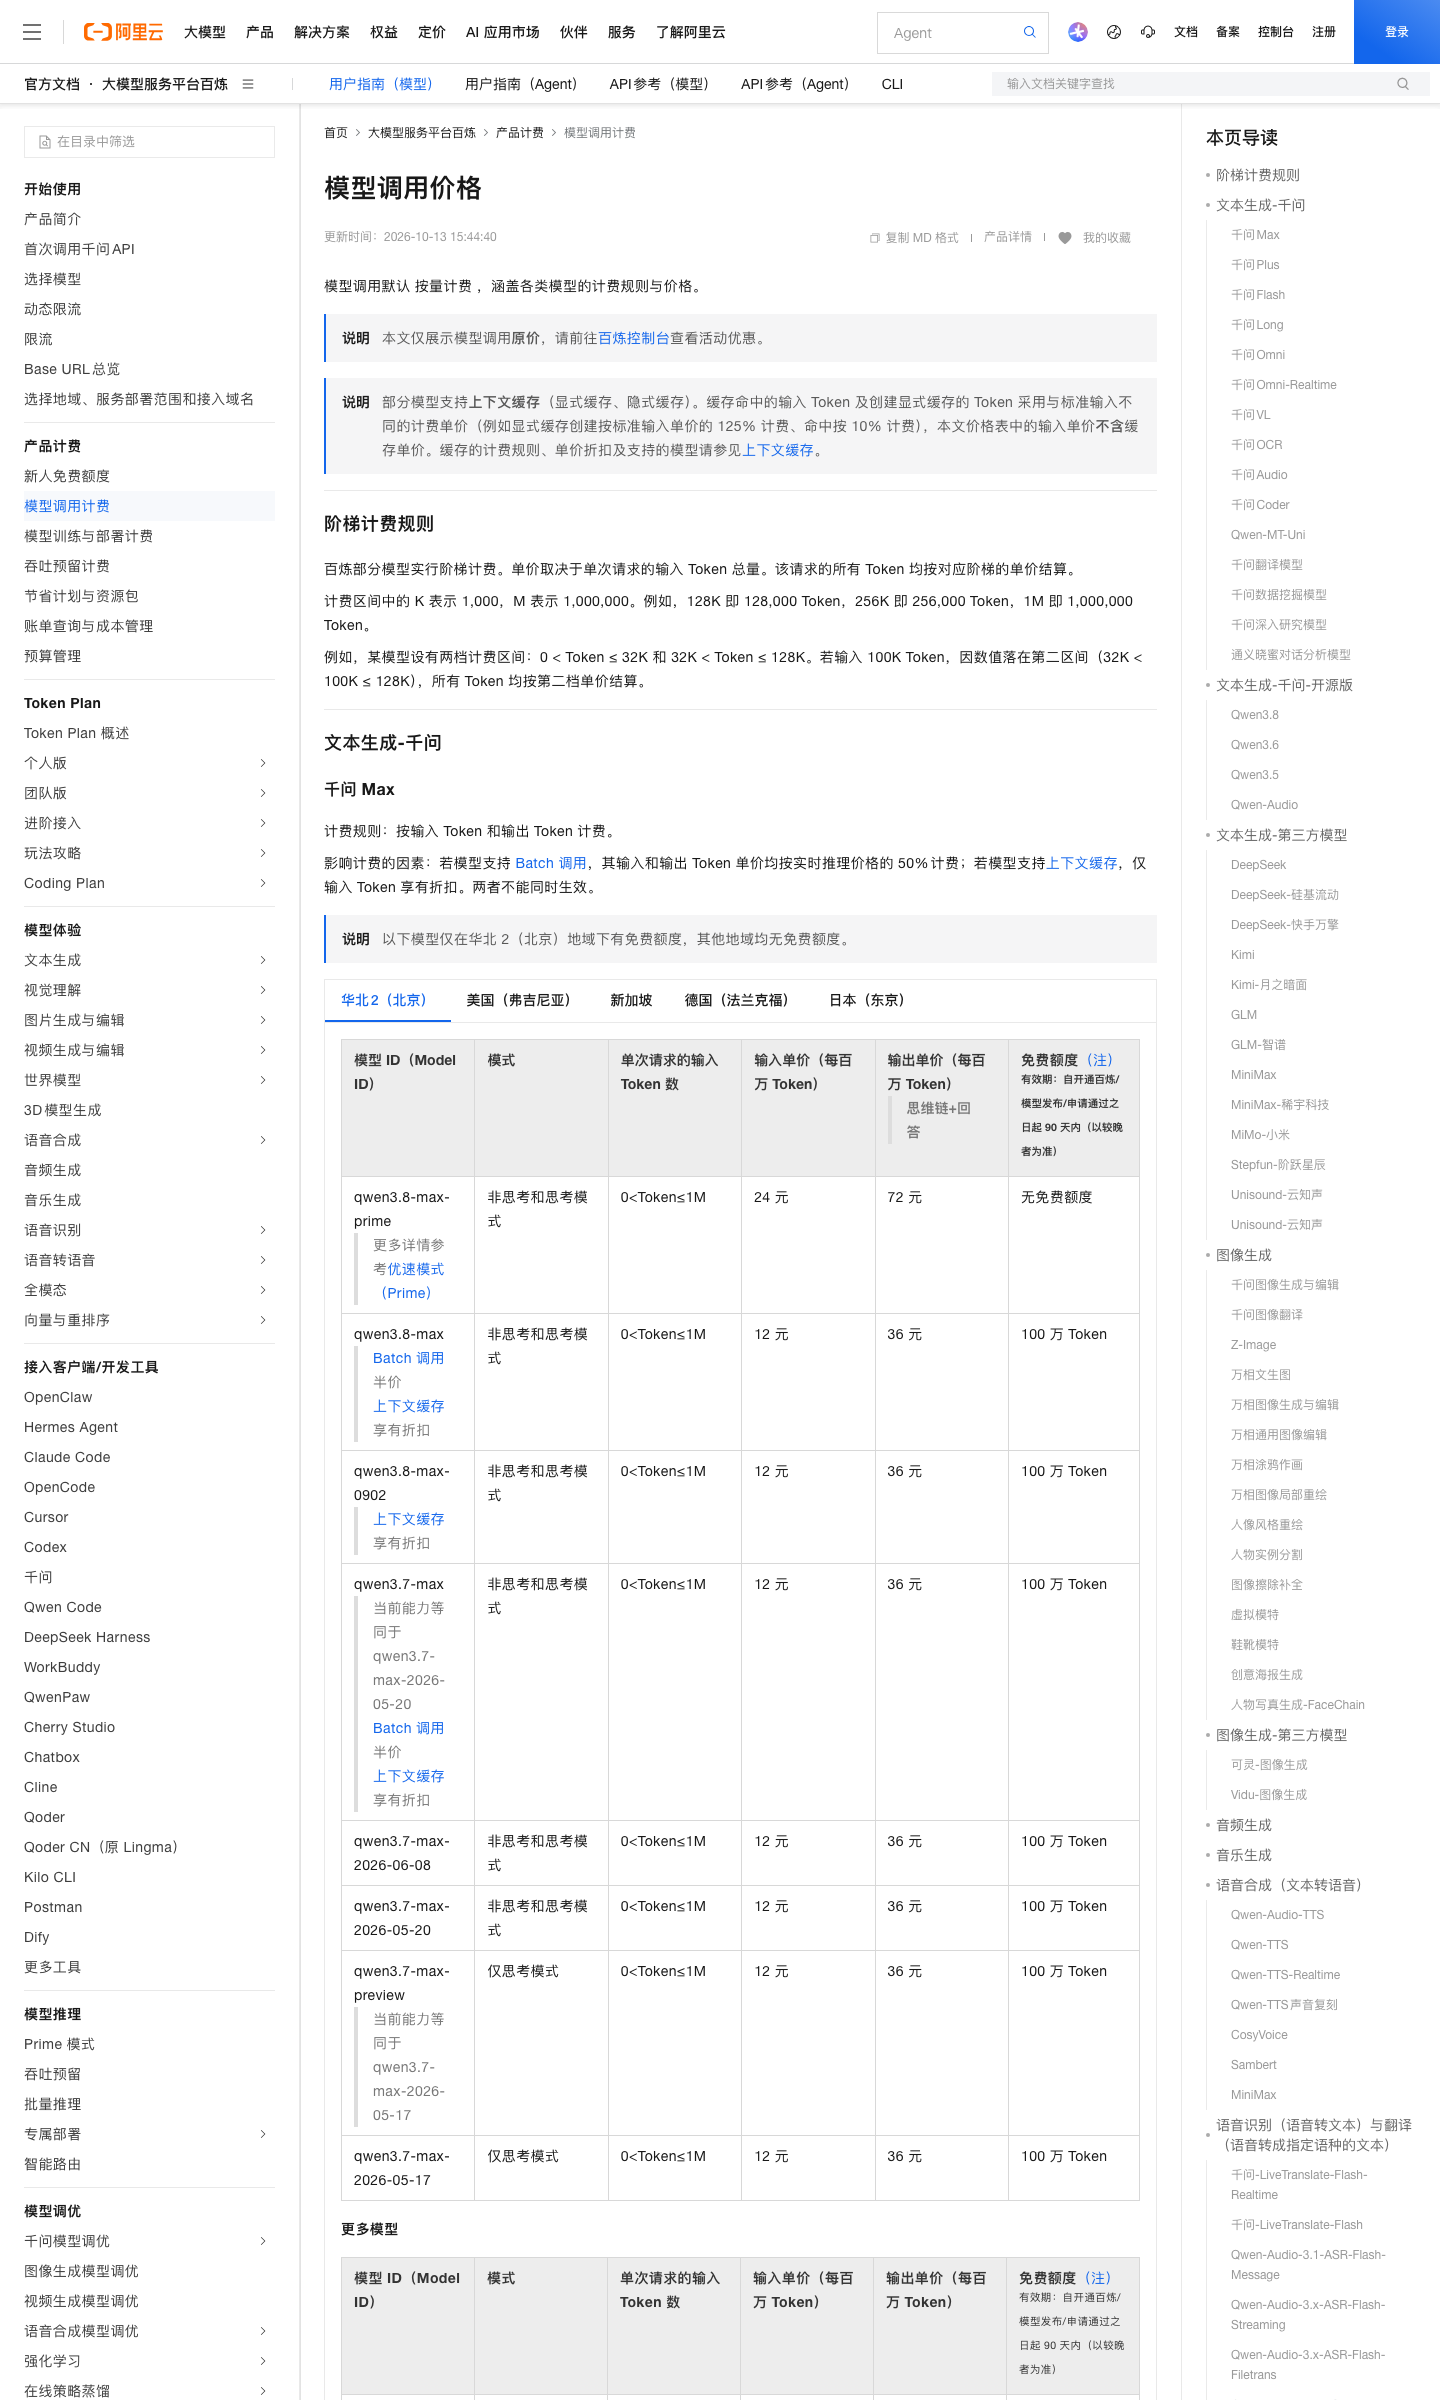
下面这张表是我们从官方定价页解析出来的完整分布:
| 额度形态 | 条目数 | 典型代表 | 计费单位换算 |
|---|---|---|---|
| Token 额度 | 118 | qwen3.8-max、qwen3.7-max、qwen-max | 100 万 / 50 万 / 10 万 / 2000 万 Token |
| 时长额度(秒) | 54 | qwen3-asr-flash、wan2.7-t2v | 50 秒 / 200 秒 / 10 秒 / 36000 秒(10 小时) |
| 图片张数 | 35 | qwen-image-2.1-pro、wanx-v1 | 10 张 / 50 张 / 100 张 / 500 张 |
| 字符数(TTS) | 9 | cosyvoice-v3-plus、qwen3-tts-flash | 1 万字符 |
| 明确无免费额度 | 8 | qwen3.8-max-prime、qwen-deep-research | 无 |
| 第三方平台行 | 9 | siliconflow、kimi、ZHIPU、MiniMax | 无(这些是第三方托管商) |
| 限时免费 | 3 | decision-model-preview、facechain-facedetect | 限时免费 |
| 功能内嵌额度 | 2 | qwen-voice-enrollment、facechain-finetune | 1000 个音色/账号、50 次 |
先说最关键的一条结论:“开通百炼送 100 万 Token”这句话,严格来说只对文本和 Embedding 类模型成立。 118 个 Token 额度条目里,有 111 个正好是 100 万 Token,看起来非常整齐;但剩下 7 个不是:text-embedding-v3 / v2 / v1 是 50 万,qwen-audio-turbo 和 qwen2-audio-instruct 是 10 万,而 text-embedding-async-v1 / v2 是 2000 万——比标准档高 20 倍。
而如果你想试的是图像、视频、语音这些模型,你一分钱 Token 额度都拿不到,拿到的是”10 张图””50 秒视频””1 万字符语音”。
一、免费额度只覆盖”实时推理”,这是最大的适用边界
官方《新人免费额度》文档用一整段”警告”级别的说明划定了边界:
免费额度仅抵扣模型实时推理(调用)产生的费用。
>
警告:Batch 调用、模型调优、模型部署、自定义模型(调优后模型、已部署模型)、PAI-DSW、OSS 存储及请求费用不支持用免费额度抵扣。
这一条对成本估算的影响是数量级的。如果你以为”我有 100 万 Token 免费额度”,然后把生产流量切到 Batch 调用(官方定价页多处标注 Batch 调用半价),你会发现折扣价和免费额度是两个互斥的通道——走 Batch 就直接开始计费,没有任何抵扣。
同样被排除的还有:模型调优、模型部署、已部署的自定义模型、PAI-DSW 计算、OSS 存储和请求费用。换句话说,免费额度只覆盖”调 API 这个动作本身”,不覆盖任何围绕模型的工程投入。
二、90 天有效期,且是”以较晚者为准”——这是一个很多人算错的时钟
官方规则原文:
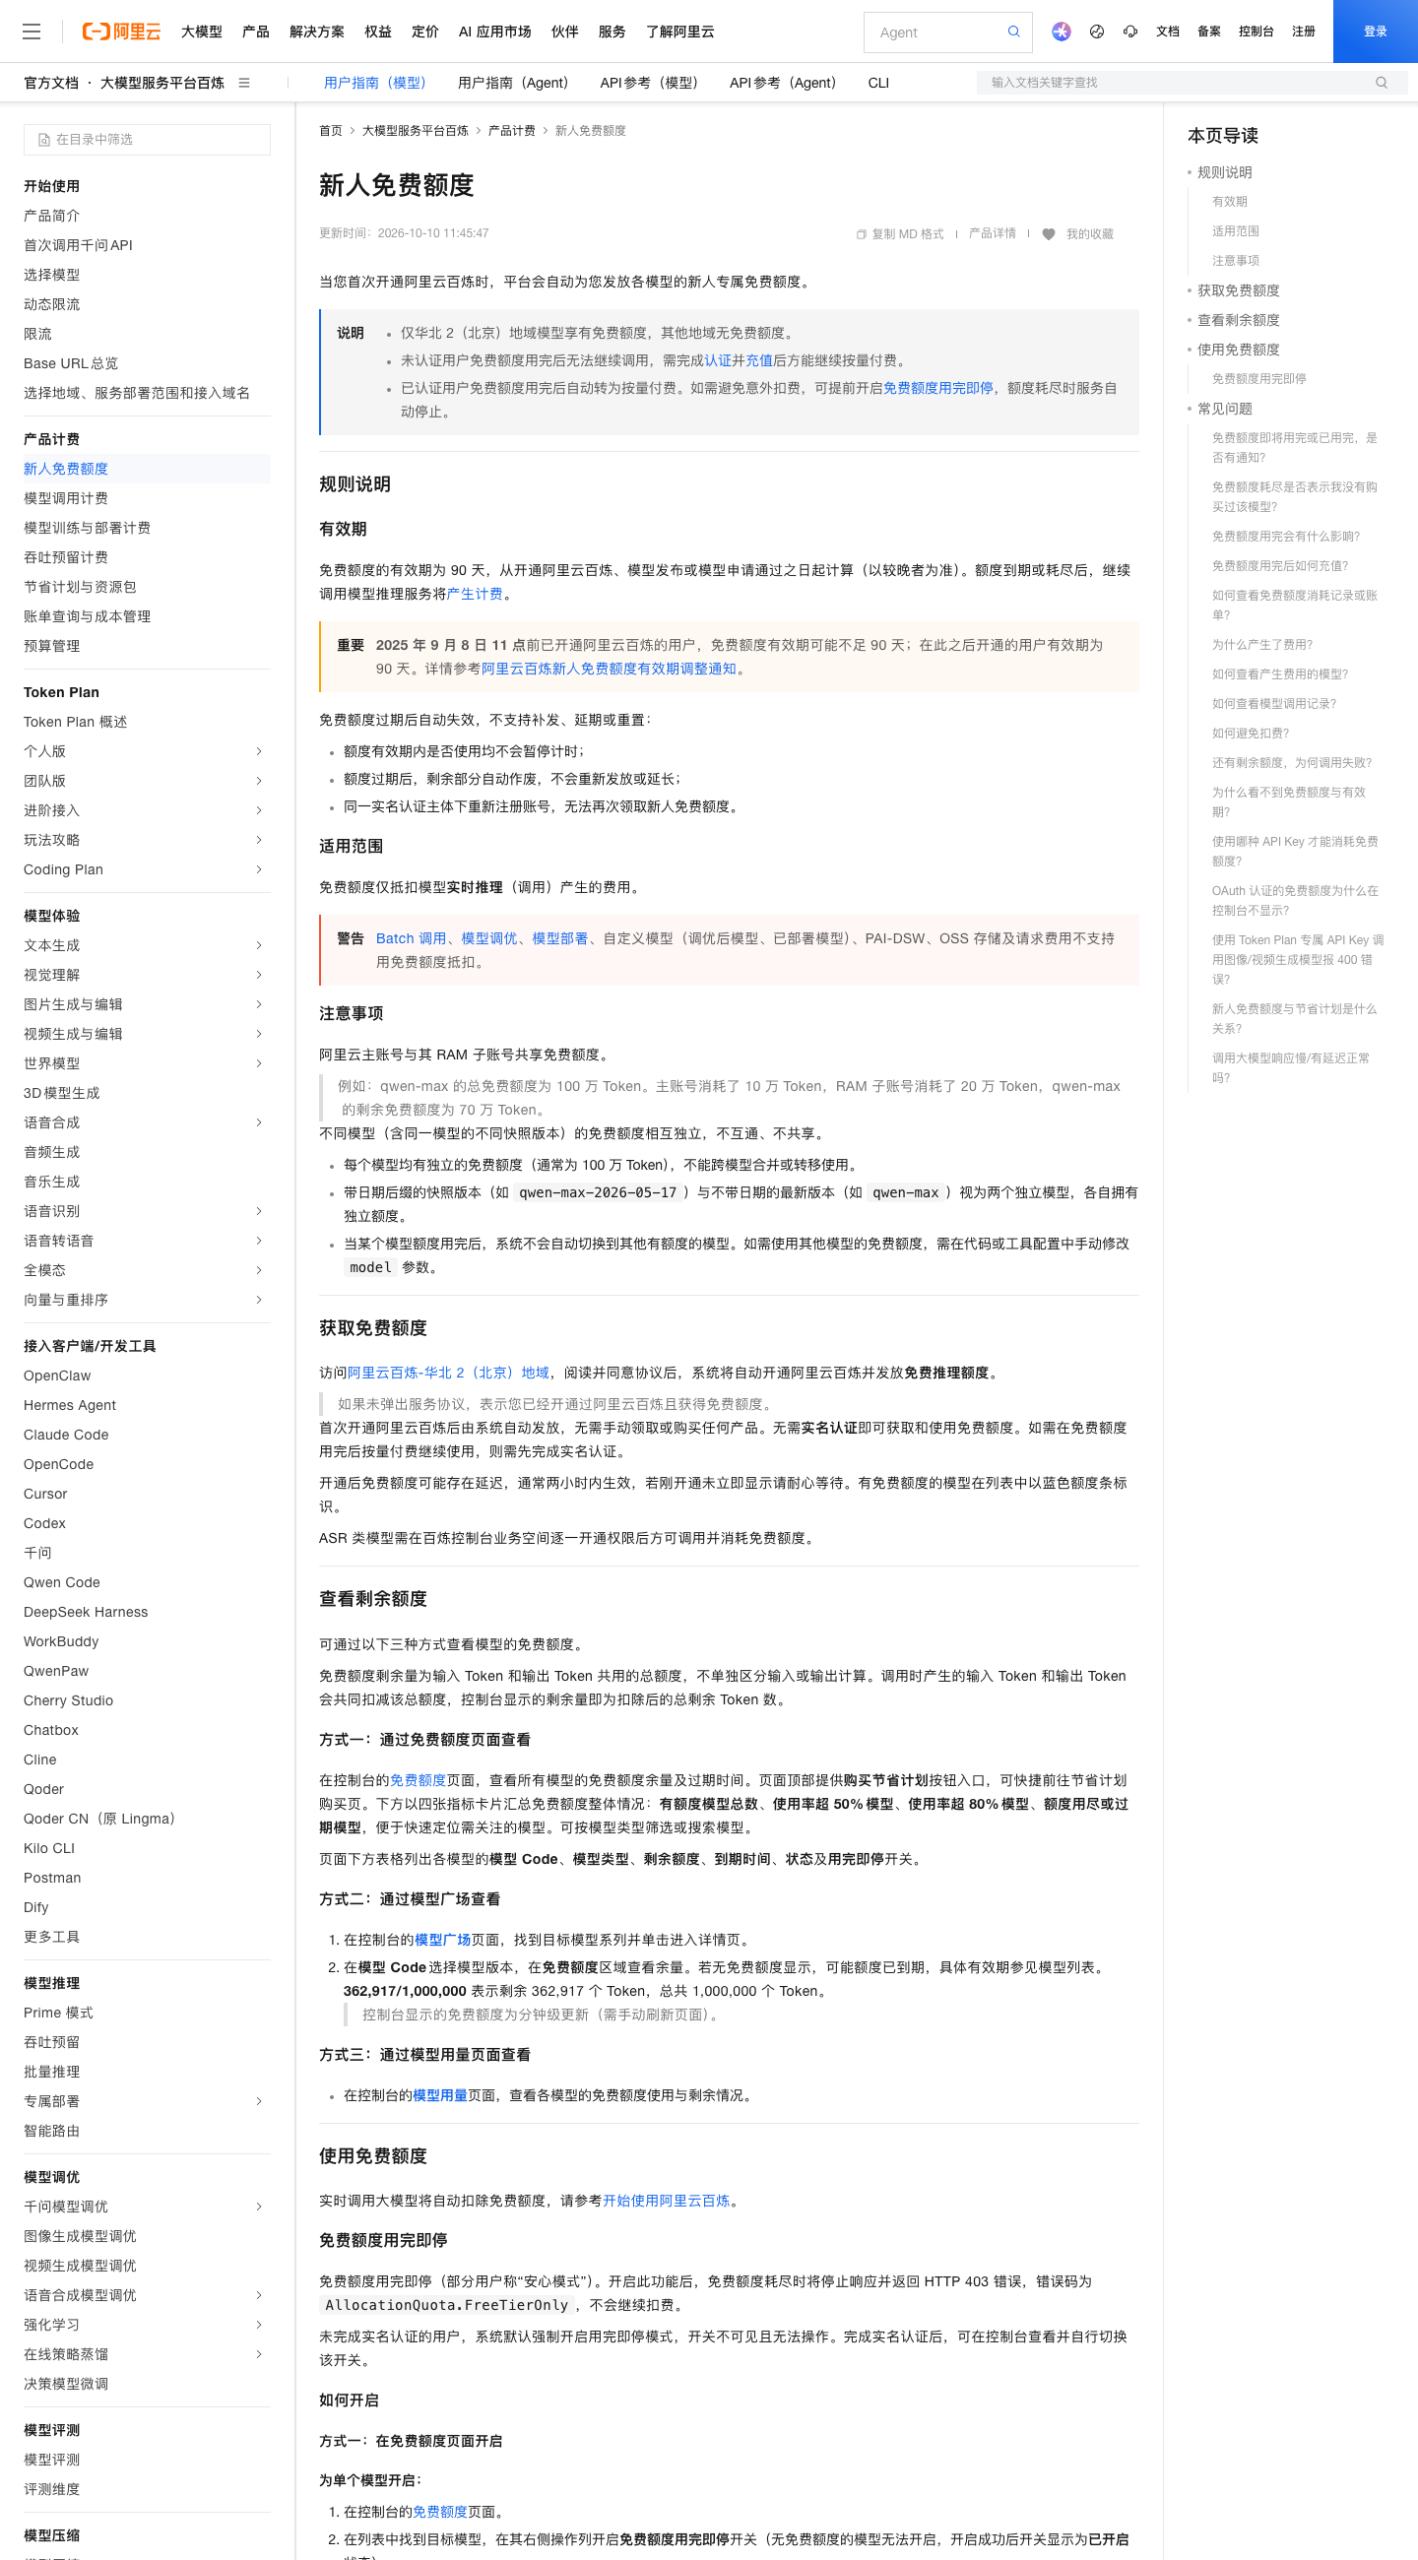
免费额度的有效期为 90 天,从开通阿里云百炼、模型发布或模型申请通过之日起计算(以较晚者为准)。额度到期或耗尽后,继续调用模型推理服务将产生计费。
“以较晚者为准”这五个字意味着:如果某个模型是 2026 年 9 月才发布的,你 2026 年 6 月就开通了百炼,那么这个模型给你的免费额度从发布日起算 90 天,而不是从你开通那天起算。对刚发布的新模型(往往正是你最想试的那些),可用窗口会比老模型短得多。
文档里还有一个容易被忽略的历史兼容条款:
2025 年 9 月 8 日 11 点前已开通阿里云百炼的用户,免费额度有效期可能不足 90 天;在此之后开通的用户有效期为 90 天。
以及几条”不暂停”的硬规则:
- 额度有效期内是否使用均不会暂停计时——这不是滚动窗口,是硬过期。
- 额度过期后,剩余部分自动作废,不支持补发、延期或重置。
- 同一实名认证主体下重新注册账号,无法再次领取新人免费额度。
第三条尤其值得注意:很多人额度快过期时想”换个号重新来一次”,这条路是堵死的。
定价表里还有两个模型不遵守 90 天规则,它们的额度写法是独立的:
| 模型 | 免费额度 | 特殊规则 |
|---|---|---|
| paraformer-v2 | 36,000 秒(10 小时) | 每月 1 日 0 点自动发放,有效期 1 个月 |
| paraformer-realtime-v2 | 36,000 秒(10 小时) | 每月 1 日 0 点自动发放,有效期 1 个月 |
| qwen3-tts-flash-realtime | 2025 年 11 月 13 日 0 点后开通百炼:1 万字符 | 按开通时点分叉 |
也就是说,paraformer 系列是按月重发的(一年累计 120 小时 ASR 时长),而 qwen3-tts-flash-realtime 的额度按 2025-11-13 这个历史时点做了新老用户分叉。这类例外只在具体模型的定价单元格里出现,不读到最后很容易漏掉。
《新人免费额度获取及用完即停开关规则》官方文档页「规则说明 / 有效期 / 适用范围 / 注意事项」四段原文:
三、”用完即停”是安全阀,但它有两个反直觉的行为
官方把「免费额度用完即停」(部分用户称”安心模式”)描述成一个防意外扣费的功能:
开启此功能后,免费额度耗尽时将停止响应并返回 HTTP 403 错误,错误码为
AllocationQuota.FreeTierOnly,不会继续扣费。
但它的默认行为取决于实名认证状态:
未完成实名认证的用户,系统默认强制开启用完即停模式,开关不可见且无法操作。 完成实名认证后,可在控制台查看并自行切换该开关。
也就是说,“是否会被扣费”的第一个决定因素不是你开没开开关,而是你有没有实名认证。未实名用户:额度用完就停,无法继续调用,必须先完成认证并充值。已认证用户:默认关闭开关,正在进行中的调用不会中断,超出额度的 Token 直接按输入/输出价格计费,”可能导致账户欠费”。
文档还明确了一句后果:账户欠费时,即使其他模型仍有免费额度也无法调用。 这是个连锁反应——一个模型超支能把整个账号的免费额度锁死。
另外有两条生效延迟相关的说明,排查问题时必须记得:
开启或关闭配置生效需要一定时间……若在配置变更生效期间仍在调用,可能因生效延迟导致免费额度用完后依旧产生计费。
>
关闭该开关后状态同步存在延迟,需等待约半小时后重试方可恢复按量付费调用。
生产环境官方明确不建议关闭:”以免额度耗尽导致服务不可用”。
四、3 个最容易踩的扣费陷阱(官方自己列出来的)
官方 FAQ 里”为什么产生了费用”一节,直接列出了 4 个原因。第 2 和第 3 个在实操中命中率最高:
陷阱 1:控制台数据是分钟级更新,且需手动刷新。
控制台的免费额度数据为分钟级更新且需手动刷新。若未及时刷新,页面显示仍有额度但实际已耗尽,导致产生调用费用。
这意味着你不能把控制台截图当凭证——它可能显示 362,917/1,000,000,但实际已经扣完了。
陷阱 2:IDE 插件的 Token 消耗速度远超预期。
IDE 插件自动补全导致 Token 快速消耗。使用 Cline、CodeBuddy 等 IDE 插件调用模型时,插件会自动携带完整的代码上下文和对话历史,单次对话可能消耗数千 Token,远高于普通简短对话的消耗。
这条对 AI 编程场景杀伤力最大。100 万 Token 的额度,如果按”一次对话几千 Token”算,理论上能撑几百轮;但在 IDE 自动补全场景里,单次请求携带完整代码上下文 + 全部对话历史,实际可能一次就吃掉上万 Token。
陷阱 3:额度不跨模型自动转移。
当某个模型额度用完后,系统不会自动切换到其他有额度的模型。如需使用其他模型的免费额度,需在代码或工具配置中手动修改
model参数。
很多团队以为”我有 249 个模型的额度,随便挑”,实际是每个模型一份独立额度,用完就是用完了,不会兜底。
陷阱 4(不扣费但会误解):输出质量不退款。
大模型按实际消耗 Token 计费,无论输出是否存在幻觉或事实错误,只要发起调用即消耗额度,不支持因输出质量问题恢复已用额度或退款。
五、额度是”按模型独立”的:快照版本也各算一份
这是最反直觉、也最容易被漏算的一条规则:
不同模型(含同一模型的不同快照版本)的免费额度相互独立,不互通、不共享。
>
每个模型均有独立的免费额度(通常为 100 万 Token),不能跨模型合并或转移使用。
>
带日期后缀的快照版本(如
qwen-max-2026-05-17)与不带日期的最新版本(如qwen-max)视为两个独立模型,各自拥有独立额度。
看官方给的例子:
例如:
qwen-max的总免费额度为 100 万 Token。主账号消耗了 10 万 Token,RAM 子账号消耗了 20 万 Token,qwen-max 的剩余免费额度为 70 万 Token。
前两条讲”主账号与 RAM 子账号共享同一个模型额度”,第三条讲”不同模型(含快照)互不共享”。两条合起来的效果是:如果你的代码在不同环境里用了 qwen3.8-max 和 qwen3.8-max-0902,你拿到的是两份 100 万 Token,不是共享的一份。 这对灰度发布和 A/B 测试是好消息(可以免费做对比实验),但前提是你知道自己有两份。
六、额度最高的 4 个模型,恰好都不适合新手
把 118 个 Token 额度条目按额度排序后,2000 万 Token 这一档只有两个模型:
| 模型 | 免费额度 | 说明 |
|---|---|---|
| text-embedding-async-v1 | 2000 万 Token | 异步向量化接口 |
| text-embedding-async-v2 | 2000 万 Token | 异步向量化接口 |
| text-embedding-v3 | 50 万 Token | 同步向量化接口 |
| text-embedding-v2 / v1 | 50 万 Token | 同步向量化接口 |
| qwen-audio-turbo | 10 万 Token | 音频理解 |
| qwen2-audio-instruct | 10 万 Token | 音频理解 |
值得注意的是 text-embedding-async 与 text-embedding 同步接口之间 40 倍的差距(2000 万 vs 50 万)。对需要批量灌库向量的团队,这个差异直接决定要不要为同步接口单独付费。
还有一个反直觉的点:最强的旗舰模型反而没有额度。 qwen3.8-max-prime(优速模式)在定价表里明确标注”无免费额度“,而它的费率是 24 元 / 72 元每百万 Token(是 qwen3.8-max 的两倍)。qwen-deep-research、qwen-doc-turbo 同样标注”无免费额度”。所以”先用免费额度试旗舰”这个常见思路,在百炼这里对这三个模型行不通。
明确列出”无免费额度”的 8 个条目:
| 模型 | 免费额度 |
|---|---|
| qwen3.8-max-prime | 无免费额度 |
| qwen-doc-turbo | 无免费额度 |
| qwen-deep-research | 无免费额度 |
| qwen-deep-research-2025-12-15 | 无免费额度 |
| kling | 无免费额度 |
| vidu | 无免费额度 |
| happyhorse-1.0-r2v | 无免费额度 |
| pixverse | 无免费额度 |
后四个是可灵、Vidu、PixVerse 这类第三方视频模型——它们的额度不在百炼这边结算。
七、视频模型的额度单位是”秒”,而且新模型额度最小
54 个时长额度条目里,分布非常陡峭:
| 额度 | 条目数 | 代表模型 |
|---|---|---|
| 36,000 秒(10 小时) | 13 | qwen3-asr-flash 系列、fun-asr 系列 |
| 200 秒 | 5 | wanx2.1-t2v-turbo / plus、wanx2.1-i2v |
| 50 秒 | 20 | wan2.7-t2v、wan2.6-t2v、wan2.5-t2v-preview |
| 30 秒 | 2 | wan3.0-video、wan3.0-video-prime |
| 10 秒 | 6 | happyhorse-1.1/1.0 的 t2v / i2v / r2v / video-edit |
主流通义视频模型(wan 系列)的新版本给的额度反而最少。 13 个 10 小时额度全部属于 ASR(语音识别),视频生成类最多只有 200 秒——按 5 秒一个片段算,只够生成约 40 个片段。而 wan3.0-video 只有 30 秒,约 6 个片段。
对比一下费用:定价页列出 720P 为 0.9 元/秒、1080P 为 1.2 元/秒、540P 为 0.3 元/秒、768P 为 0.50 元/秒。200 秒的 wanx2.1 额度在 720P 下约值 180 元,30 秒的 wan3.0-video 约值 27 元。 这是”免费额度”能给你的最大单笔等值价值,但也仅仅是让你试个手感。
图像模型的额度分布(35 个条目):
| 额度 | 条目数 | 代表模型 |
|---|---|---|
| 500 张 | 12 | wanx-v1、wanx2.1-t2v-turbo/plus、wanx2.0-t2v-turbo |
| 100 张 | 11 | qwen-image-2.0 系列、qwen-mt-image、z-image-turbo |
| 50 张 | 6 | wan2.6-t2i、wan2.5-t2i-preview、wan2.7-image |
| 10 张 | 2 | qwen-image-2.1-pro、qwen-image-2.1-turbo |
qwen-image-2.1-pro 和 qwen-image-2.1-turbo 是 10 张,而上一代的 qwen-image-2.0-pro 是 100 张。 新版本更贵、额度更少——如果你只是想试通义生图的质感,用 2.0 系列能多试 10 倍。
八、第三方模型在百炼上架,但额度归各家自己
定价表里能看到这些行:deepseek-v4-pro-0813(100 万 Token)、kimi-k3(100 万 Token)、glm-5.2(100 万 Token)、以及 siliconflow、vanchin、ZHIPU、MiniMax、xiaomi、stepfun、unisound 等托管商行——这些行的免费额度列显示”无”。
同时《选择模型》页面确认了百炼确实在提供这些模型:文本生成分类下并列列出 deepseek-v4-pro-0813、deepseek-v4.1-flash、kimi/kimi-k3、glm-5.2、ZHIPU/GLM-5.3、MiniMax-M3、mimo-v2.5-pro。图像与视频分类下也有 kimi/kimi-k3、happyhorse-1.1-i2v、wan3.0-video 等。
也就是说:在百炼调用 DeepSeek / Kimi / GLM / MiniMax,额度规则是跟着百炼的新人免费额度走的(同样是 90 天、同样按模型独立);但通过 siliconflow、ZHIPU 这些托管商行接入的,额度列显示”无”,走的是各家自己的计费体系。 同一个模型,两条接入路径的免费额度口径不同——这一点在官方文档里没有单独强调,是我们从定价表逐行解析出来的。
九、如果你只想记住 6 条
- 先确认地域:只有华北 2(北京)有免费额度,其他地域全部没有。
- 先确认模型类型:文本 / Embedding 才有 Token 额度;图像给张数、视频给秒数、TTS 给字符数。
- 先确认快照:带日期和不带日期是两个模型,各有一份额度。
- 先实名认证:决定”额度用完是停止扣费还是自动转按量付费”,而且会改变你能不能开启”用完即停”开关。
- 先开”用完即停”:已认证用户默认关闭,改配置有生效延迟,生产环境别关。
- 别用 Batch 调用:Batch 不抵扣免费额度,直接计费。
十、还有两个鲜为人知的例外机制
ASR 需要逐一开通权限。 官方原文:
ASR 类模型需在百炼控制台业务空间逐一开通权限后方可调用并消耗免费额度。
这意味着即使你看到了 qwen3-asr-flash 有 36,000 秒的额度,没开通权限就是调不了,额度也不会被扣。
额度预警可以自定义阈值。 余量降至 20% 或完全耗尽时,系统通过短信、站内信、邮件发送通知。如果需要提前预警,可以在”我的试用”里找到试用规格描述为”百炼大模型推理免费试用”的条目,修改余量到期预警规则。另外还有一个独立的高额消费预警:设置阈值金额(官方示例填的是 0.01 元),当产品日账单超过阈值时每天短信提醒一次。
如果想彻底止损,官方给的最终手段很直接:删除已创建的 API-Key。删除后将无法通过 API 调用模型,不再产生调用费用。
十一、本文的证据口径与未验证项
已验证(本次直接抓取):
- 249 行 / 239 条模型条目、7 类额度形态、8 条”无免费额度”、9 条第三方托管商行、3 条”限时免费”、2 条”按月重发”、1 条历史时点分叉——全部来自 2026-10-14 抓取的阿里云百炼《模型调用价格》页面 HTML 逐行解析。
- 90 天有效期、”以较晚者为准”、Batch 不抵扣、快照独立、RAM 子账号共享、控制台分钟级更新、403 +
AllocationQuota.FreeTierOnly、20% 预警——全部来自 2026-10-14 抓取的《新人免费额度获取及用完即停开关规则》页面正文。
未验证 / 需要你自己确认的:
- 我们没有阿里云账号,未登录控制台实测。所有关于控制台 UI、开关状态、实际扣费金额的描述均转引自官方文档,我们没有独立复现过。
- 239 条的清单会随官方调价而变。定价页左上角显示的更新时间为 2026-10-13,本文数据以该时点为准。
- 官方明确”大模型按实际消耗 Token 计费”,但具体一次调用消耗多少 Token,取决于你的 prompt 和输出长度,本文不做任何消耗量估算。
- 费用换算(如”200 秒 ≈ 180 元”)是按定价页列出的每秒单价做的算术换算,不代表任何实际账单。
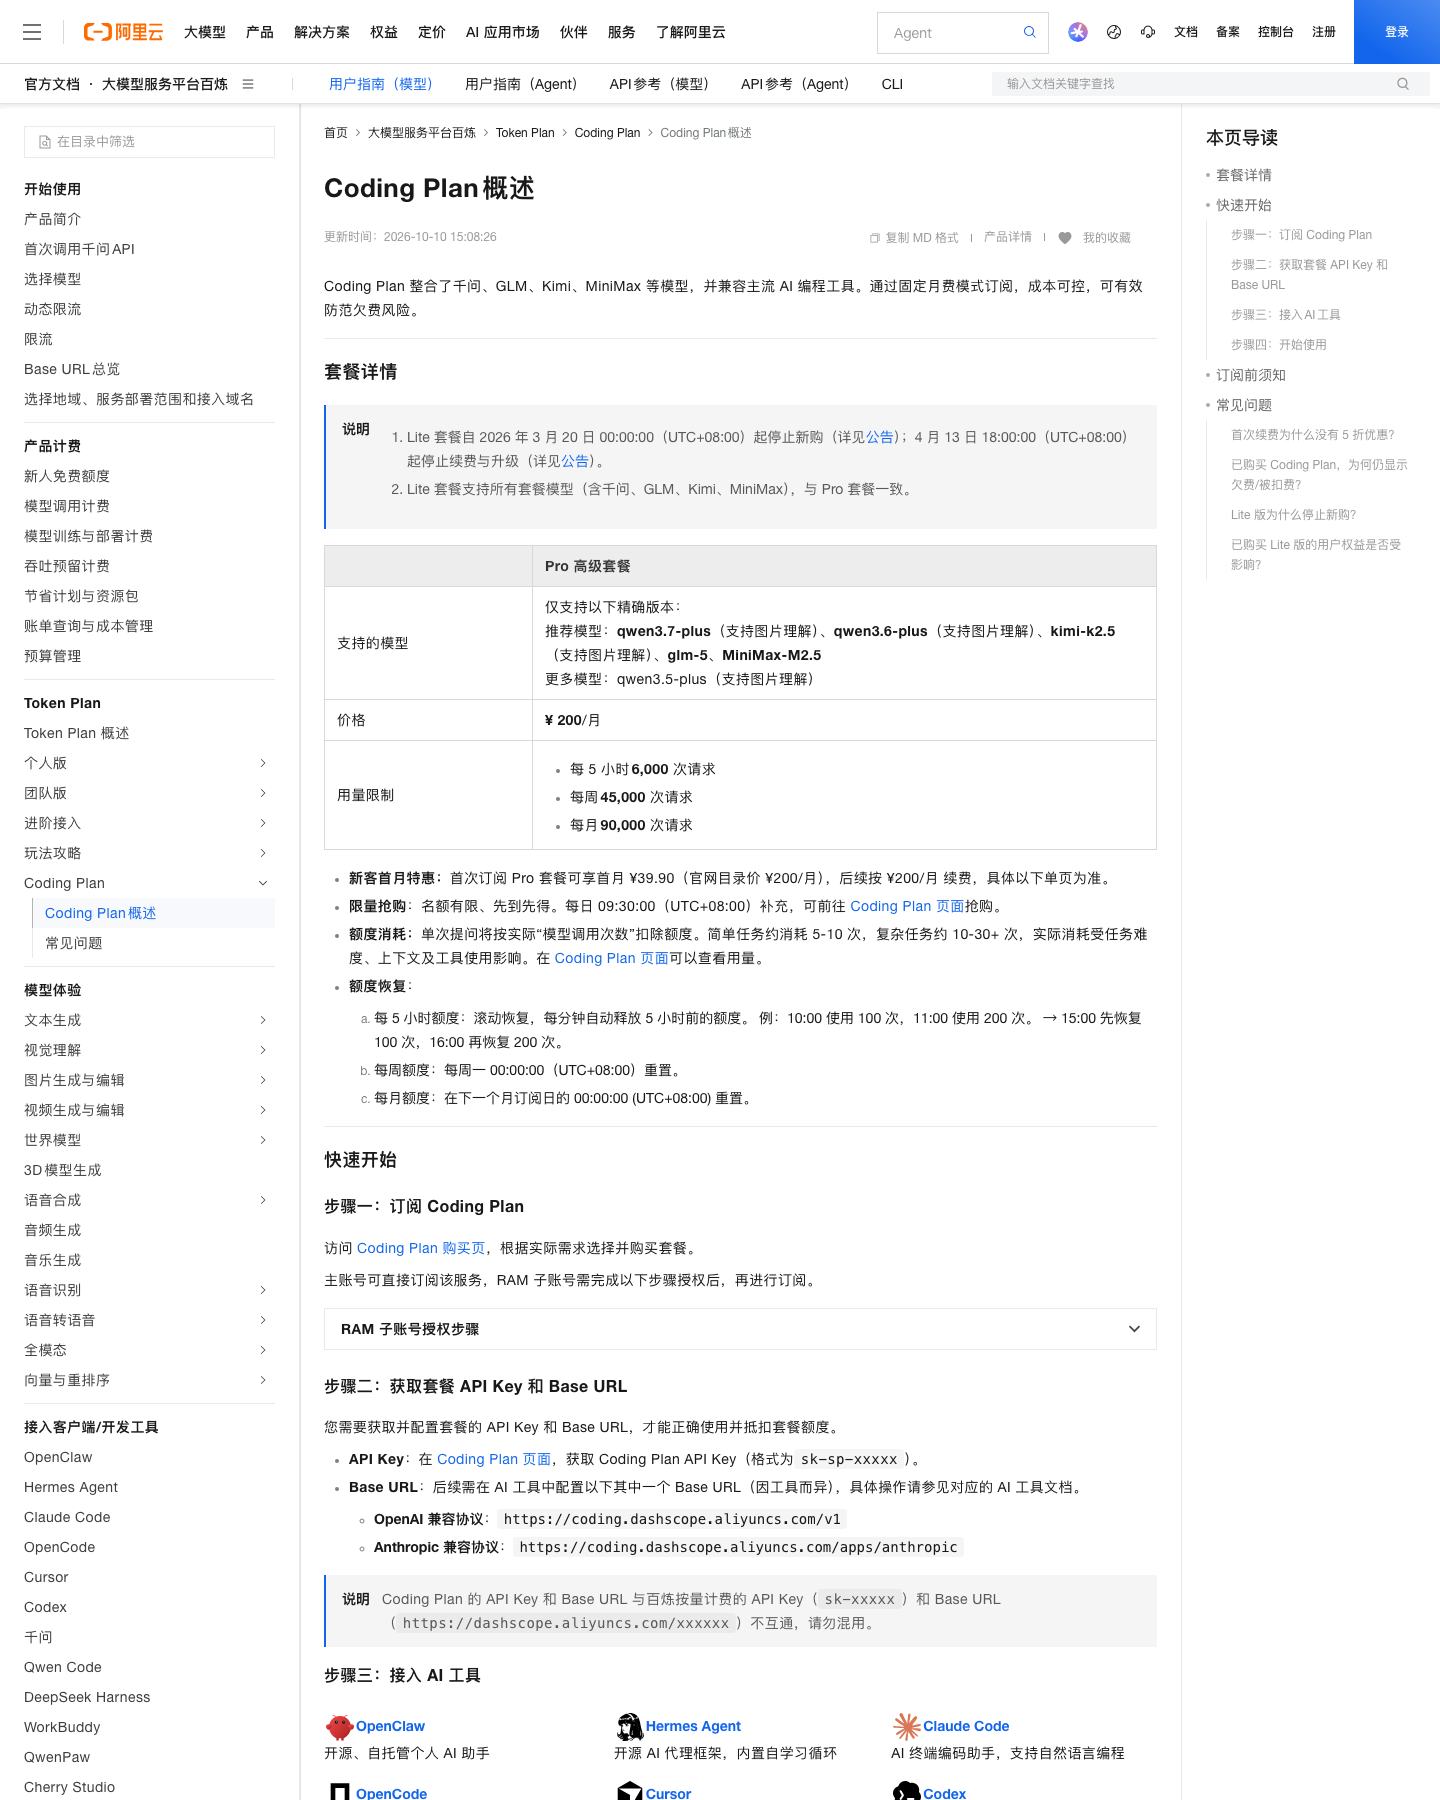
补充说明:Coding Plan 是 200 元/月的订阅制,与本文讨论的按量新人免费额度是两套彼此独立的计费体系:
十二、来源与可核验链接
- 阿里云百炼《新人免费额度获取及用完即停开关规则》(更新时间 2026-10-10 15:44:47)— https://help.aliyun.com/zh/model-studio/new-free-quota
- 阿里云百炼《模型调用价格》(更新时间 2026-10-13 15:44:40,本文 249 行额度数据来源)— https://help.aliyun.com/zh/model-studio/model-pricing
- 阿里云百炼《选择模型》(更新时间 2026-10-10 11:45:45,第三方模型上架清单)— https://help.aliyun.com/zh/model-studio/models
- 阿里云百炼《Coding Plan 概述》(更新时间 2026-10-10 15:08:26,200 元/月订阅制,与按量免费额度是两套体系)— https://help.aliyun.com/zh/model-studio/coding-plan
- 阿里云百炼《新人免费额度》入口文档 — https://help.aliyun.com/zh/model-studio/free-quota
- 阿里云百炼《模型列表 / 新模型发布》— https://help.aliyun.com/zh/model-studio/newly-released-models
- 本文图片:2026-10-14 12:0x(Asia/Shanghai)Chrome 无头浏览器实拍官方文档页
本文所有额度数字均解析自阿里云官方公开定价页面,仅代表 2026-10-13 官方更新时点的口径。免费额度政策可能随时调整,决策前请以官方文档实时内容为准。本文作者未登录阿里云控制台实测,文中涉及控制台操作的部分请以你自己的实测为准。