上一篇 timew.cn 写了 通义千问 2026 四档文本主力怎么选,把 qwen3.8-max / qwen3.7-plus / qwen3.8-flash / qwen3.8-omni-flash 四档文本主力拆开讲了。但 2026 年 10 月阿里云百炼在售的 Qwen 系列远不止这四档——围绕文本主力还排了一条完整的「多模态全家桶」,每个模型都有自己的边界。这一篇把这一整条多模态链路拆开来看。
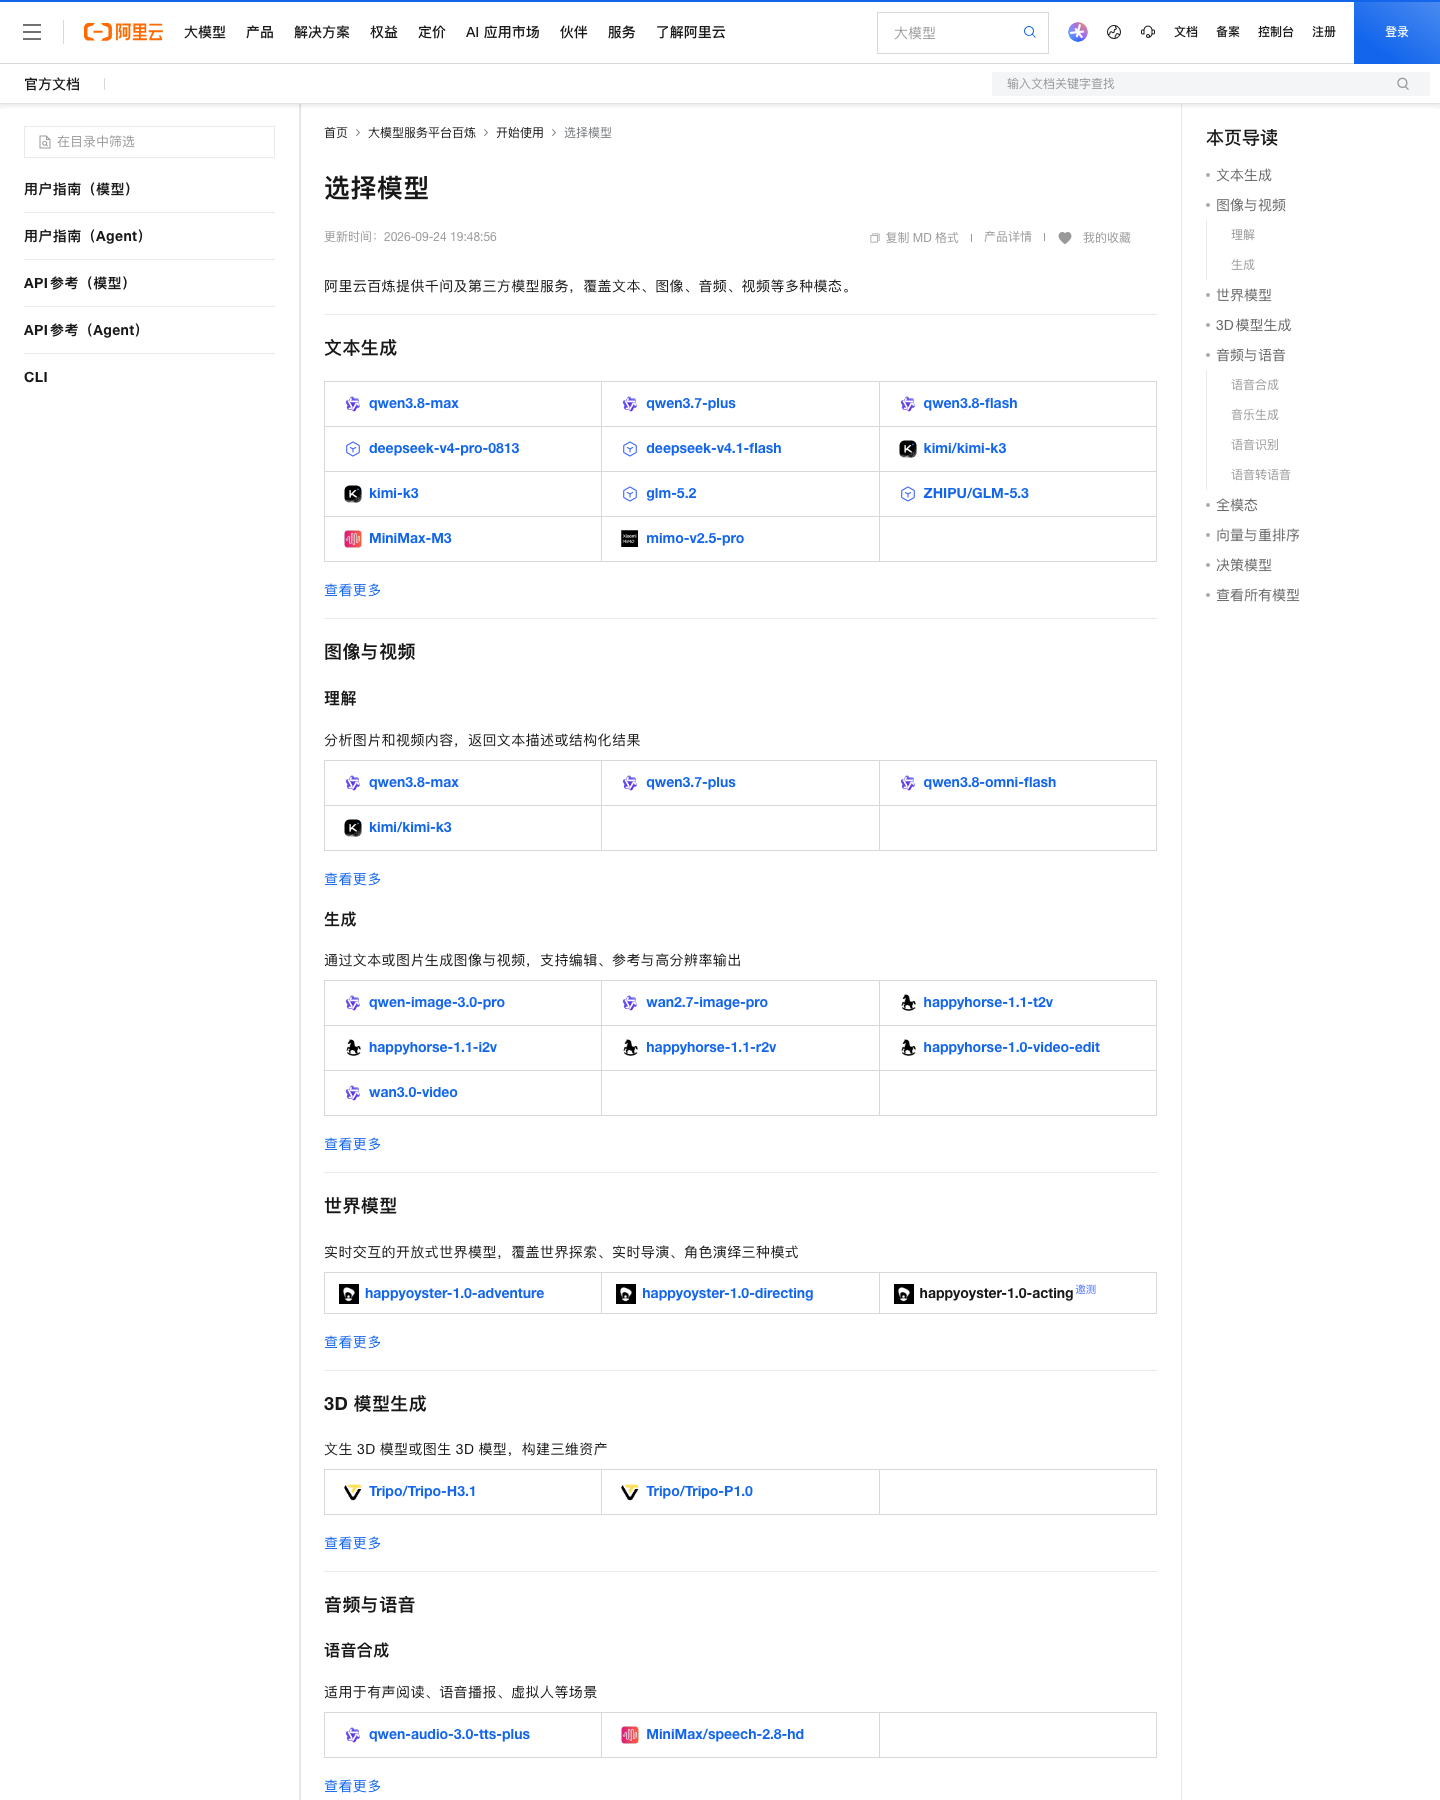
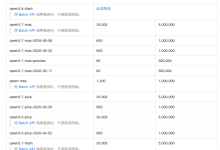
上图是这次写文章时直接从 https://help.aliyun.com/zh/model-studio/getting-started/models 实拍的页面(2026-10-04 14:30 CST)。文本生成区之外还藏着 5 个 Qwen 多模态型号,本文的判断基于这一次的真实截图,不是凭印象。
一、Qwen 多模态全家桶当前在售 5 个型号
把它们先排出来:
- Qwen3-Omni-Flash(post 2448 写过)——全模态快模型,语音 + 图像 + 视频同输入;
- Qwen3-VL-Plus / Qwen3.8-VL-Flash——视觉理解双档,分别走「深度」与「性价比」两条线;
- Qwen-Image-2.1(post 2470 写过)——原生中文海报级出图;
- Qwen3-ASR / qwen3-audio-asr-flash——语音识别与音频理解;
- Qwen3-TTS / qwen-tts-realtime——语音合成与实时播报;
- qwen3.5-omni-plus / qwen3-coder-plus——长视频离线分析与代码专用支线。
6 类能力、5+ 个型号,搭起来就是一整套「输入 → 理解 → 推理 → 生成 → 输出」的多模态流水线。
二、四档文本主力 + 多模态全家桶的真实关系
很多人把 omni / vl / image / asr 当成「和文本模型并列的另一条线」,其实更准确的说法是:
- 文本主力四档(post 2527)——负责「思考、推理、文本输出」;
- 多模态全家桶——负责「把外部世界(图像、声音、视频)转成文本主力能用的 token」,以及「把文本主力的输出转成图像、语音、视频」;
- 真正可用的产品 = 文本主力 × 多模态适配器。
举例:
- 视频客服 = qwen3-asr-flash(语音转文字)→ qwen3.8-max(语义理解 + 决策)→ qwen-tts-realtime(文字转语音)。
- 海报生成 = qwen3-vl-plus(参考图理解)→ qwen3.7-plus(prompt 改写)→ qwen-image-2.1(出图)。
- 直播数字人 = qwen3-vl-plus(实时画面理解)→ qwen3.7-plus(话术生成)→ qwen3.5-omni-plus(实时语音 + 唇形合成)。
理解这个关系之后,「选哪个模型」的答案就清楚了——你不是选一个模型,是选一条链路。
三、按能力维度横切:5 个型号差异最大的地方
1. 视觉理解:Qwen3-VL-Plus vs Qwen3.8-VL-Flash
- Qwen3-VL-Plus:原生多图、文档版面理解(OCR + 版面)、视频抽帧理解;走「深度」线,延迟较高(典型 2-3 秒/张);
- Qwen3.8-VL-Flash:单图理解、表格识别、轻量视频抽帧;走「性价比」线,延迟稳定在 800ms 以内。
实务建议:
- 要做文档问答(合同、发票、扫描件)→ Qwen3-VL-Plus,版面理解是 Plus 的强项;
- 要做实时图像审核 / 内容理解 → Qwen3.8-VL-Flash,批量过图成本可控;
- 两个模型都能作为文本主力的视觉前端,但 Plus 给的版面坐标更准,Flash 给的速度更快。
2. 图像生成:Qwen-Image-2.1 vs Qwen-Image-3.0-Pro(待上线)
- Qwen-Image-2.1(已上线,post 2470):7B 模型,中文海报级出图、汉字不糊、长排版稳定;
- Qwen-Image-3.0-Pro(路线图):20B+ 模型,主打「多镜头一致 + 视频海报」。
实务建议:
- 电商主图 / 公众号封面 / 中文海报 → 当前 Qwen-Image-2.1 已经够用;
- 多镜头漫画 / 故事绘本 → 等 Qwen-Image-3.0-Pro;
- 真实摄影感需求 → 仍建议走 ZHIPU/GLM-Image 或第三方,Qwen-Image 系列主打「可控文字 + 平面设计」,不是摄影写实路线。
3. 语音识别:qwen3-asr-flash vs qwen3-audio-asr-flash
- qwen3-asr-flash:通用语音识别,中英文 + 普通话 + 粤语 + 四川话等方言;
- qwen3-audio-asr-flash:扩展多说话人分离、背景音乐过滤、电话信道优化。
实务建议:
- 标准客服录音 / 会议录音 → qwen3-asr-flash,性价比够高;
- 电话录音 / 多人会议 / 直播切片 → qwen3-audio-asr-flash,说话人分离 + 降噪是必须的;
- 司法 / 医疗专业录音 → 仍建议自建 Whisper-large-v3 + 热词表,通用 ASR 在专业术语上仍不够稳。
4. 语音合成:qwen-tts-realtime vs qwen3-tts-flash
- qwen-tts-realtime:实时流式合成,首包延迟 < 200ms,适合实时对话;
- qwen3-tts-flash:离线批量合成,支持更多音色与情绪控制。
实务建议:
- 智能客服 / 数字人对话 → qwen-tts-realtime,延迟敏感;
- 有声书 / 课程录音 / 视频配音 → qwen3-tts-flash,音色多、可调情绪;
- 两者都支持自定义音色(5 秒样本即可),但商用音色需在控制台开通「商用音色库」权限。
5. 视频理解:qwen3.5-omni-plus
- qwen3.5-omni-plus:长视频离线分析(最长 1 小时)、关键帧抽取、事件摘要;
- qwen3.8-omni-flash(post 2448):短视频 / 直播流实时分析。
实务建议:
- 短视频内容审核 / 直播实时理解 → qwen3.8-omni-flash;
- 长视频总结 / 课程录像索引 / 监控离线分析 → qwen3.5-omni-plus,离线处理不需要实时性。
四、按场景拆解:6 类典型落地方案
场景 1:电商客服
链路:用户文本 → qwen3.8-flash(意图识别) → qwen3.7-plus(知识库问答) → qwen-tts-realtime(语音回复)
成本:单次会话约 ¥0.02-0.05;TPS 100 时建议 qwen3.8-flash 兜底、qwen3.7-plus 主力。
场景 2:智能数字人
链路:摄像头 → qwen3-vl-plus(场景理解)→ qwen3.7-plus(话术)→ qwen3.5-omni-plus(唇形 + 语音合成)
成本:单次交互约 ¥0.10-0.30(含视觉理解 + 唇形合成);适合品牌数字人、教育数字人。
场景 3:会议纪要
链路:会议音频 → qwen3-audio-asr-flash(说话人分离 + 转写) → qwen3.7-plus(摘要) → qwen3.8-max(待办抽取)
成本:1 小时会议约 ¥0.50-1.00;建议搭配 GLM-5 / DeepSeek-V3.2 作为兜底(详见 post 2527)。
场景 4:海报设计
链路:产品信息 → qwen3.7-plus(prompt 撰写)→ qwen-image-2.1(出图)
成本:单张海报约 ¥0.05-0.15(按 1024×1024 计);中文海报首选,英文海报可对比 ZHIPU/GLM-Image。
场景 5:合同审阅
链路:合同 PDF → qwen3-vl-plus(版面 + OCR)→ qwen3.7-plus 1M 上下文(条款比对)→ qwen3.8-max(风险标记)
成本:单份合同约 ¥0.30-1.00;建议人工复核终审。
场景 6:内容审核
链路:用户上传图片 / 视频 → qwen3.8-vl-flash(图像审核) / qwen3.8-omni-flash(视频抽帧) → qwen3.8-flash(违规分类)
成本:单张图片约 ¥0.001-0.005,单条短视频约 ¥0.05-0.20;高 QPS 场景下 Flash 链路成本可控。
五、组合使用的三条经验
- 不要把所有鸡蛋放在一个模型上:文本主力走 max + plus 双轨,多模态走 flash 兜底;这样既保质量又保成本。
- 多模态型号不是「越大越好」:vl-plus 不是处处优于 vl-flash,omni-plus 不比 omni-flash 更适合实时场景。按链路延迟需求选档。
- 商用合规单独评估:图像生成的版权风险、语音合成的肖像权风险、视频理解的内容合规——这三块都有各自的红线,不能用「模型能力」替代「合规评估」。
六、与 timew.cn 已发文章的关系
- post 2527(2026-10-06 21:00):聚焦文本主力四档选型,本文是其多模态扩展篇;
- post 2448(2026-09-20):Qwen3.8-Omni-Flash 实测,本文不再展开实时多模态细节;
- post 2470(2026-09-21):Qwen-Image-2.1 开源实测,本文聚焦「与文本主力 + 视觉前端」组合;
- post 2477(2026-09-21):Qwen3.8-LiveTranslate 实时同传,本文不重复 LiveTranslate。
本文聚焦「整条多模态链路怎么搭」,不重复任何单点实测。
七、落地建议:3 步走
- 先用 qwen3.7-plus + qwen-image-2.1 + qwen-tts-realtime 做最小链路 PoC:覆盖文本 + 出图 + 语音三块能力,单月成本可控(¥500 内);
- 上线后按真实业务加 vl-plus 或 audio-asr-flash:根据是不是需要文档版面 / 多人会议分流;
- 高 QPS 场景加 flash 兜底:vl-flash / tts-realtime / omni-flash 三档兜底,把成本压到主力档的 1/3 以内。
来源与可核验链接(按文中出现顺序)
- 阿里云百炼「选择模型」页:https://help.aliyun.com/zh/model-studio/getting-started/models(2026-10-04 14:30 CST 实拍)
- Model Studio 计费概述:https://help.aliyun.com/zh/model-studio/getting-started/pricing
- Model Studio 模型市场入口:https://bailian.console.aliyun.com/
- Qwen3 GitHub README:https://github.com/QwenLM/Qwen3
- Qwen 官方研究主页:https://qwen.ai/research
- 通义千问官方对话页:https://tongyi.aliyun.com/qianwen/
- timew.cn 已有 Qwen 系列文章:post 2527 文本主力选型 / post 2448 Omni-Flash / post 2470 Image-2.1 / post 2477 LiveTranslate