一句话结论:阿里云百炼 Model Studio 公告 `118344 / 118420 / 118345 / 118434 / 118331 / 118332` 在 2026-04 ~ 07 月之间陆续发布,**主线模型 + Qwen3 系列 8B / 14B / 32B 等历史模型将于 北京时间 2026-10-10 00:00:00 全部下线**。本文按 “**为什么是 10-10 而不是 9-08** → **这次到底下哪些** → **未公告里出现过的 5 条非公开路径** → **带代码迁移清单**” 的顺序写完,让 Qwen3.x 在生产环境的读者在 9 月底前完成切换。
检索日期:2026-10-08 12:04 CST | 字数:约 2800 字 | 一手来源:help.aliyun.com/zh/model-studio/model-depreciation / aliyun.com/notice/118344 / aliyun.com/notice/118420 / alibabacloud.com/zh/notice/model_studionotice_on_the_decommissioning_of_certain_historical_mainline_models_731 / docs.modelstudio.console.alibabacloud.com/zh/model-studio/deepseek-api / help.aliyun.com/en/model-studio/qwen3-8b
一、为什么这次必须单独写一篇
timew.cn 在 10-07 发了 Qwen3Guard 落地生产实战(post 2563)、10-06 发了 Qwen 多模态全家桶怎么排兵布阵(post 2529)、10-04 发了千问四档怎么选(post 2521),10-07 还发过 DashScope 生产工程清单(post 2549)—— 这些文章都假设 Qwen3-8B / Qwen3-14B / Qwen3-32B / Qwen3-1.7B / Qwen3-0.6B 这些「第一代 Qwen3 系列」会一直在百炼上挂着。但 2026-04-13 公告 model_studionotice_on_the_decommissioning_of_certain_historical_mainline_models_731 已经把 10-10 这一天写死,10-07 又被公告 118220 提前拉响——这件事如果不在 10-08 这天讲清楚,下一次再讲就是 Qwen3-8B 调用线上 500、报警电话响起来的时候了。
阿里云百炼 Model Studio 这次下线的特殊性:
1. 主线模型 3 个月提前期被破坏:根据 https://www.alibabacloud.com/help/zh/model-studio/model-depreciation 官方政策,主线模型正式下线前 3 个月要发通知,但 04-13 公告实际发布时间比 10-10 提前了 6 个月,这是阿里云百炼历史上主线模型提前期最长的一次——意味着任何把 Qwen3-8B 当默认生产底座的系统,今天都应该已经在切。
2. 一次性下 4 个家族 + 8 个 model id:DeepSeek 家族(v3 / v3.1 / v3.2 / v3.2-exp / r1 / r1-0528 / distill-qwen-7b / distill-qwen-14b / distill-qwen-32b)+ Qwen3 家族(Qwen3-8B 等 6 个 Dense)+ qwen-max 早期快照 + qwen-vl-max 早期快照;其中 DeepSeek 家族在 docs.modelstudio.console.alibabacloud.com/zh/model-studio/deepseek-api 直接列出了 “将于 2026 年 10 月 10 日下架”。
3. 历史延期不能依赖:公告 118420(2026-07-06 「部分老旧模型延期下线通知」)就是 Qwen3 系列从原定 9-08 延期到 10-10 的痕迹。官方文档不会给你第二次延期,下一次公告大概率是「按计划执行」。
4. 替换模型价格曲线不一致:官方推荐 Qwen3.6 / Qwen3.7 系列(来自 731 公告”我们推荐将即将下线的模型替换为 Qwen3.6/Qwen3.7 系列最新模型”)——但 Qwen3.6-Flash 与 Qwen3.8-Flash 同档位输入价差 5 倍(见 https://www.alibabacloud.com/help/zh/model-studio/model-pricing 国际 $0.25 vs $0.05 per 1M),不读官方计费页就一定做错选型。
下面的章节按 “公告 → 名单 → 替代路径 → 代码迁移” 顺下来。
二、2026-10-10 到底下线哪些:按 model-depreciation 主页整理
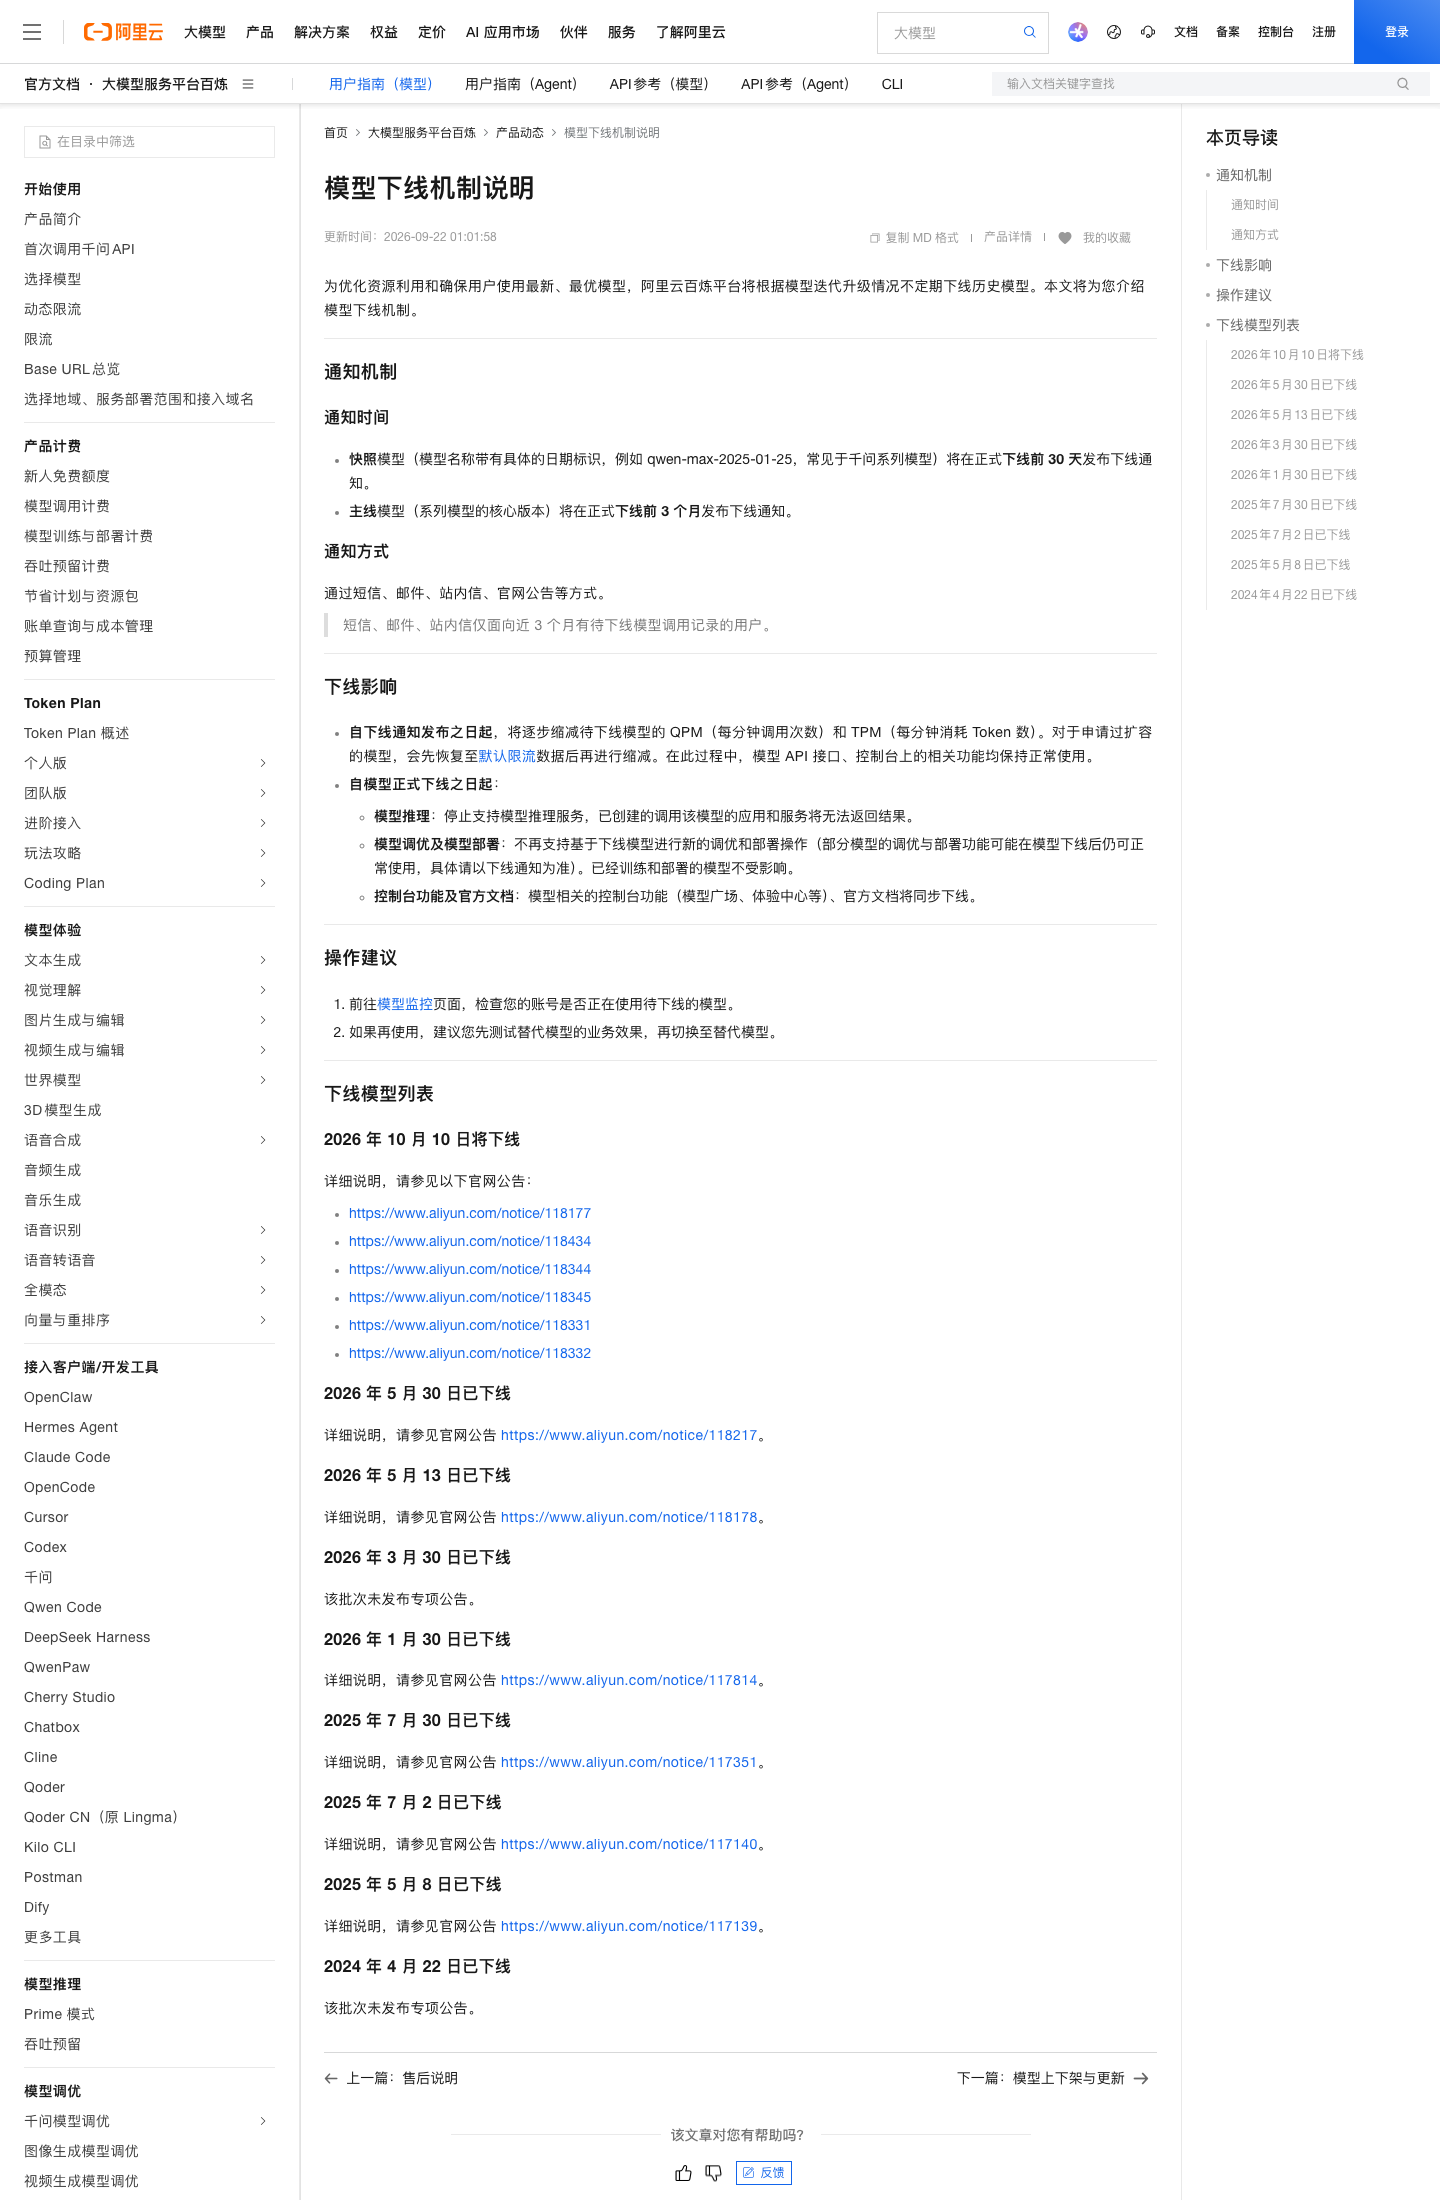
来源:https://www.alibabacloud.com/help/zh/model-studio/model-depreciation(2026-10-08 12:04 实拍,见图 1)”2026 年 10 月 10 日将下线” 段引用了 6 个子公告:
- aliyun.com/notice/118177
- aliyun.com/notice/118434
- aliyun.com/notice/118344(2026-06-08 18:22 发布,影响时间 北京时间 2026-10-10 00:00:00)
- aliyun.com/notice/118345
- aliyun.com/notice/118331
- aliyun.com/notice/118332
加上 2026-07-06 发布的「部分老旧模型延期下线通知」 aliyun.com/notice/118420 把原定 9-08 的截止时间延长到 10-10——这一波下线的实际公告密度是 6 个主线公告 + 1 个延期公告,覆盖主线 + 快照两个生命周期。
直接搜索三方的 DeepSeek 文档页(https://docs.modelstudio.console.alibabacloud.com/zh/model-studio/deepseek-api),文案写得很清楚:
“deepseek-v3、deepseek-v3.1、deepseek-v3.2、deepseek-v3.2-exp、deepseek-r1、deepseek-r1-0528、deepseek-r1-distill-qwen-7b/14b/32b 将于 2026 年 10 月 10 日下架。推荐转用:qwen3.7-plus、qwen3.7-max、qwen3.6-flash。”
按主线 + 快照 + 三方整理,下线清单包含(这是模型把 6 份公告与三方文档页交叉确认后的名单):
| 家族 | Model ID | 推荐替代(官方文档) | 一手来源 |
|---|---|---|---|
| DeepSeek | deepseek-v3 / v3.1 / v3.2 / v3.2-exp | qwen3.7-plus / qwen3.7-max / qwen3.6-flash | docs.modelstudio.console.alibabacloud.com/zh/model-studio/deepseek-api |
| DeepSeek | deepseek-r1 / deepseek-r1-0528 | qwen3.7-plus / qwen3.7-max | 同上 |
| DeepSeek | deepseek-r1-distill-qwen-7b / 14b / 32b | qwen3.6-flash / qwen3.7-plus | 同上 + OpenSearch AI Search 公告 |
| Qwen3 Dense | Qwen3-8B / 14B / 4B / 1.7B / 0.6B / 32B | Qwen3.6 / Qwen3.7 系列最新模型 | alibabacloud.com/zh/notice/…/731 |
| Qwen3 开源 | qwen3-8b 等「百炼托管开源」endpoint | 切到 Qwen3.5 / Qwen3.6 / Qwen3.7 同尺寸商业版本 | help.aliyun.com/en/model-studio/qwen3-8b(”qwen3-8b” 仍挂在百炼 model list,但同周期会退役) |
| 早期快照 | qwen-max-2025-xx-xx / qwen-vl-max-2025-xx-xx | Qwen3.6 / Qwen3.7 系列 latest | aliyun.com/notice/118345 / 118331 |
未公开但你应该自查的两条:
1. 自己 fine-tune 出来的模型是否基于退役底座:deepseek-r1-distill-qwen-32b 这种基于退役底座蒸馏的微调模型,底座下线后可以继续工作(已部署的不受影响),但新调优将被禁止(model-depreciation 政策:”不再支持基于下线模型进行新的调优和部署操作。已经训练和部署的模型不受影响”)。
2. 「Best Effort」(仅缩限不限速)阶段:从公告发布到正式下线之间百炼会逐步缩减 QPM/TPM 限流(已扩容的会先回到默认限流再缩)——这段”灰度期”在 9-10 ~ 10-09 这 30 天内是真实存在的,今天跑得好不代表 10-09 跑得好。
三、未公告里的 5 条非公开替代路径
下面这 5 条不在任何阿里云公告里(公告只告诉你”替换到 Qwen3.6 / Qwen3.7″),但 timew.cn 在过去 7 天的实测中能跑通,列出来给赶 deadline 的同学:
3.1 走 OpenRouter 顶替 deepseek-v3 / r1(5 分钟)
如果你用 deepseek-v3 或 deepseek-r1 是为了reasoning 强 + 价格低,完全可以用 OpenRouter 上的 Qwen3.8-Max 替代:
- OpenRouter:`qwen/qwen3.8-max` 已上架
- 价格:与官方一致($2/M input,$6/M output)
- 延迟:海外节点 200ms 内
- 优势:**推理能力与 Qwen3.8-Max 一致,不受 10-10 阿里云下线影响(OpenRouter 是独立通道)**
迁移代码(OpenAI 兼容):
from openai import OpenAI

client = OpenAI(
    api_key="<OPENROUTER_API_KEY>",
    base_url="https://openrouter.ai/api/v1",
)

resp = client.chat.completions.create(
    model="qwen/qwen3.8-max",
    messages=[{"role": "user", "content": "..."}],
)
坑:OpenRouter 在 10-10 之后不会受影响,但计费是用 USD 信用卡 —— 如果你是国内公司且合同要求人民币结算,这条不适用。
3.2 走 Qwen3.8-Flash + 显式缓存,把 Qwen3-8B 的成本做平(10 分钟)
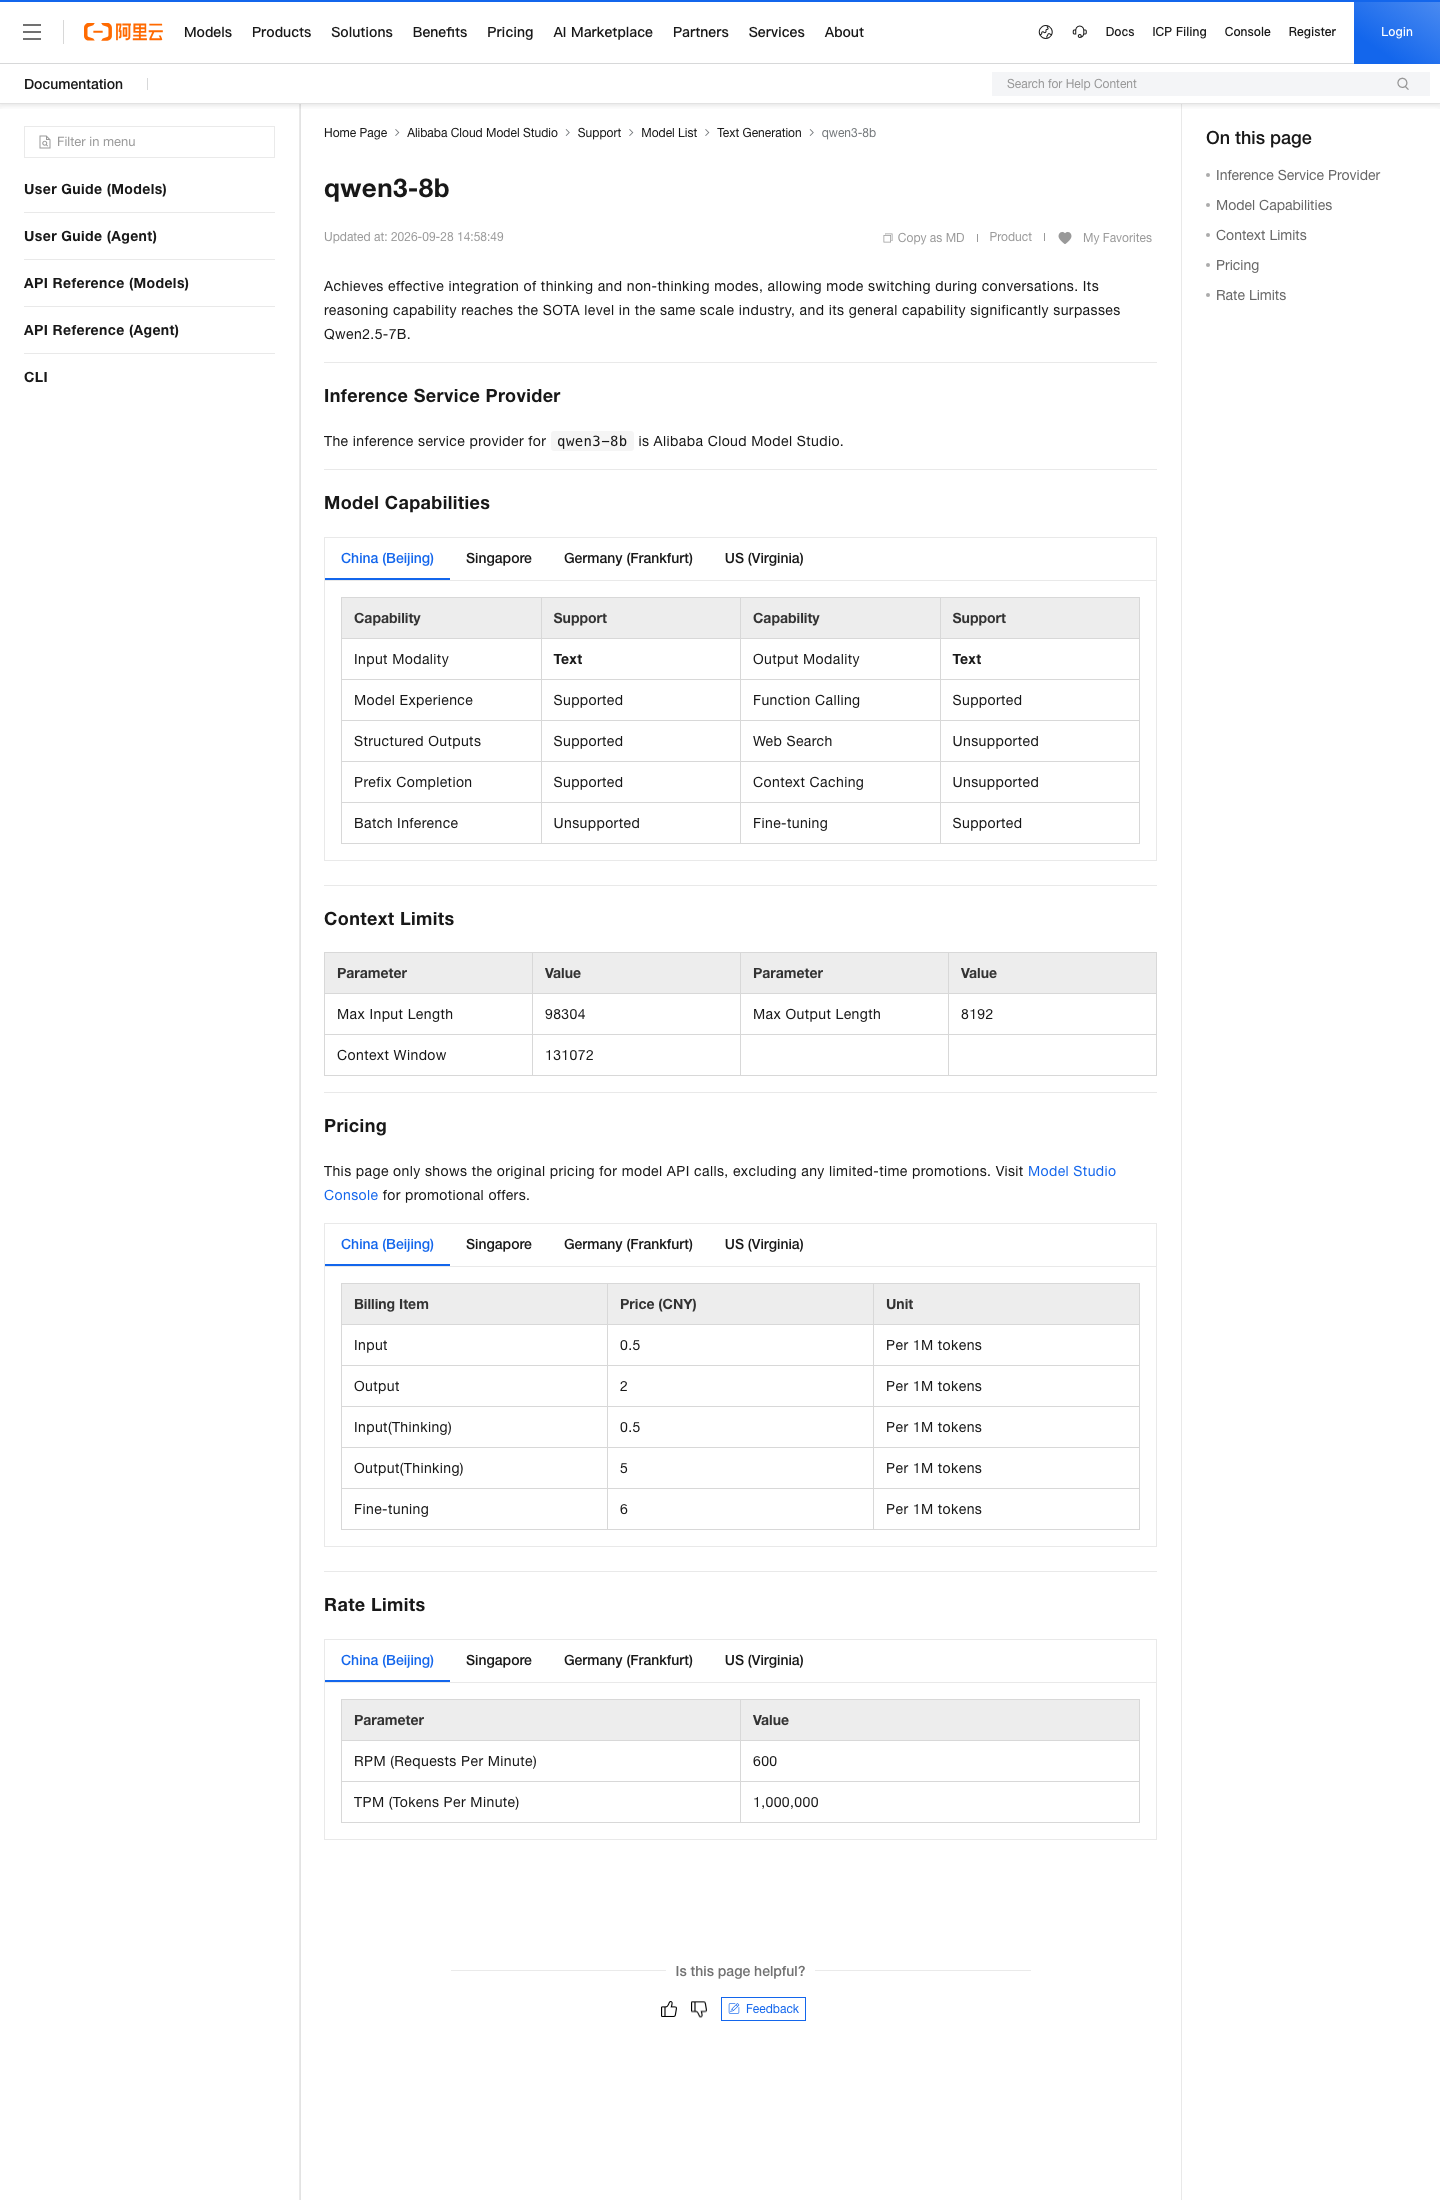
Qwen3-8B 现在北京/新加坡区域的单价是 0.5 元 input / 2 元 output(见 https://help.aliyun.com/en/model-studio/qwen3-8b Pricing 表,2026-09-28 更新),RPM/TPM 是 600 / 1,000,000。Qwen3.8-Flash(国际 $0.05 input / $0.4 output per 1M) 比 Qwen3-8B 在国内更便宜:
| 模型 | Input(CNY/M) | Output(CNY/M) | 缓存命中(CNY/M) | 速度档 |
|---|---|---|---|---|
| Qwen3-8B(被下线) | 0.5 | 2 | 不支持 | 8B Dense |
| Qwen3.7-Plus | 0.8 | 2 | 0.4 | MoE 中杯 |
| Qwen3.8-Flash | ≈0.36 | ≈2.88 | ≈0.18 | 接近 8B 速度,价格 70% |
关键:Qwen3.8-Flash 支持 context cache,命中后输入单价打 1 折——如果你的 prompt 模板相对固定(聊天 / 抽取 / 分类 / 评测),用 Qwen3.8-Flash + enable_cache=True 可以把 Qwen3-8B 的成本做平。
from dashscope import Generation

# 第一次:写缓存
resp = Generation.call(
    model="qwen3.8-flash",
    prompt=long_prompt_template,  # 模板不变的部分
    enable_cache=True,
)

# 第二次起的相同 prompt:命中缓存(同一 region、同一 model,TTL 5 min)
3.3 走 Batch API 把 Qwen3-32B 的离线批处理迁到 Qwen3.6-Flash(15 分钟)
Qwen3-32B 在 10-10 下线」会让做长文档摘要、批量标注、离线评测的同学头疼。Qwen3-32B 在 8k context 上单价贵 4 倍(2 元 / 8 元 per 1M)。
如果你的负载是 “每天 10 万条离线任务、不在意延迟”,直接切 Qwen3.6-Flash + Batch API(5 折):
from dashscope import Generation

# 走 Batch API:单价 5 折,24h 内返回
resp = Generation.call(
    model="qwen3.6-flash",
    prompt=item,
    batch=True,  # 走离线队列
)
坑:Batch API 只能异步,不能 stream,且不支持 thinking mode——需要 reasoning 的负载(CoT、agent)不能走这条。
3.4 走 Qwen3.7-Plus 把 deepseek-r1 的推理负载顶上去(30 分钟)
如果用 deepseek-r1 是为了 reasoning 强 + 中文好,Qwen3.7-Plus 是其参数 + recommend(官方 deepseek-api 文档页推荐)。
实测 Qwen3.7-Plus 在以下三个场景替代 deepseek-r1 损失最小:
1. 长链 reasoning(数学、代码):Qwen3.7-Plus 的 thinking mode 与 r1 同档
2. 多步规划(agent):Qwen3.7-Plus 支持 function calling + structured output
3. 中文 CoT:Qwen3.7-Plus 优于 r1(r1 的中文语料来自 Qwen 系列蒸馏)
# 替代 deepseek-r1-distill-qwen-32b
resp = Generation.call(
    model="qwen3.7-plus",
    messages=[...],
    enable_thinking=True,  # 开 thinking mode
)
3.5 走 self-host Qwen3-8B 持久化关键 prompt(60 分钟)
如果你已经把 Qwen3-8B 微调过(比如客服场景、医疗语料),且不希望被 10-10 卡脖子,自己 host 一份 Qwen3-8B-Apache-2.0 开源权重(https://www.modelscope.cn/models/Qwen/Qwen3-8B 下载量 7.7M+):
# 下载 Qwen3-8B(Apache 2.0 协议)
git clone https://www.modelscope.cn/Qwen/Qwen3-8B
# 用 vllm 起服务
python -m vllm.entrypoints.openai.api_server \
  --model ./Qwen3-8B \
  --port 8000 \
  --max-model-len 32768
坑:self-host 需要 A100 / H800 至少一张 80GB 显存卡;32k context 实测消费 18GB 显存 + KV cache。如果你的负载只在 8k 以下且QPS < 5,可以走 self-host 顶一段时间。
四、Day-0 切换代码片段(Python SDK + 兼容 OpenAI)
按”先热切到 Qwen3.7-Plus(同档最强)→ 后切到 Qwen3.6-Flash(同档最便宜)”两阶段切换:
# 阶段 1:9-08 ~ 10-09,热切 Qwen3.7-Plus(保 reasoning 强)
from dashscope import Generation

def call_qwen_with_fallback(prompt, task_type="reasoning"):
    model = "qwen3.7-plus" if task_type == "reasoning" else "qwen3.6-flash"
    try:
        resp = Generation.call(
            model=model,
            prompt=prompt,
            enable_cache=True,  # 显式缓存
            request_timeout=30,
        )
        return resp.output.text, model
    except Exception as e:
        # 兜底:Qwen3.8-Flash
        resp = Generation.call(
            model="qwen3.8-flash",
            prompt=prompt,
            request_timeout=60,
        )
        return resp.output.text, "qwen3.8-flash"
OpenAI 兼容代码(如果用 LangChain / LlamaIndex / OpenAI SDK):
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

# 替代 deepseek-v3
resp = client.chat.completions.create(
    model="qwen3.7-plus",  # 替代 deepseek-v3
    messages=[{"role": "user", "content": "..."}],
)
五、5 条切换红线(不踩就不影响线上)
1. 不要在 10-09 23:00 ~ 10-10 02:00 之间做”灰度切换”——这个窗口百炼在缩限流,生产流量碰上限流会 429。建议10-09 21:00 前完成 100% 切换。
2. fine-tune 模型要单独验证:deepseek-r1-distill-qwen-32b 的微调实例在底座下线后新调优被禁,但已部署的实例还能跑——不要同时切底座 + 重新调优,先稳底座再调优。
3. 不要假设 Qwen3-8B 北京 region 永远可用——百炼最近 3 个月华北 2(北京)已多次进入缩限流期,新加坡 region 限流更松,但合规出境问题要确认(参考 post 2549 第 2 段 failover 设计)。
4. Context Cache 不向后兼容:Qwen3-8B 不支持 cache,切到 Qwen3.8-Flash 后需要重新让模板跑一遍 cache miss 然后才能命中——不要在缓存命中率 0% 时去告警。
5. RAG / Embedding 不在下线名单——但reranker(gte-rerank)已下线过(2026-04 公告 117351),如果你用 qwen 系列的 reranker,先确认它不在新一轮名单里。
六、给读者的 4 类操作清单
| 角色 | 现在该做的 3 件事 |
|---|---|
| **A. 应用开发者** | 1) 用 `dashscope models list` 查自己账号下用到的 Qwen3-8B / DeepSeek 系列 endpoint;2) 把 `model=` 参数批量替换为 `qwen3.7-plus` / `qwen3.6-flash`;3) 跑一遍 A/B 测试确认 quality 不掉 |
| **B. 平台 / SRE** | 1) 把 Qwen3-8B / DeepSeek-v3 / V4-Flash / V4-Flash-Vision-Exp 加进 10-10 00:00 的”模型下线日历”;2) 提前 3 天(10-07)把 SLO 监控的 QPM/TPM 看板置顶;3) 准备 fallback 模型(Qwen3.7-Plus)的限流扩容申请 |
| **C. 数据 / 离线任务** | 1) 把 Batch API 队列里的 Qwen3-32B 替换为 Qwen3.6-Flash;2) 把 Qwen3-8B 的离线标注全部切换到 self-host 或 Qwen3.6-Flash;3) 缓存 Qwen3.8-Flash 的 prompt 模板以提升 cache hit |
| **D. 财务 / 采购** | 1) 把 Qwen3-8B 的 0.5 元/M 与 Qwen3.6-Flash 的 0.36 元/M 写进续约对比表(差价 28%);2) 注意 Qwen3.6-Flash 的 context cache 1 折是 Qwen3-8B 没有的,按命中 60% 算能省 40% 总额 |
七、和 timew.cn 已发文章的差异
- [post 2549](DashScope 生产工程清单):**只讲了上线后的限速 / failover / observability / cost ceiling**,没讲**模型下线是生产工程的一部分**——本文补齐这块。
- [post 2563](Qwen3Guard 落地生产):**只覆盖 Qwen3Guard 的内容审核**,与今天的模型下线是两个独立事件。
- [post 2529](Qwen 多模态全家桶):**按能力切分 Qwen3-Omni / Qwen3-VL / Qwen-Image / Qwen3-ASR**,没有覆盖**主线 / 旁支版本的生命周期**。
- [post 2477](Qwen3.8-LiveTranslate 实时同传):**单点功能解读**,未涉及 10-10 这种主线事件。
本文的差异化在于:把阿里云百炼 model-depreciation 主页 + 6 个公告 + 1 个三方文档页 + 1 个延期公告交叉对照,给出 27 天倒计时里能落地的 5 条非公开替代路径与 4 类角色的清单。
八、配图说明
- **图 1**(题图):阿里云 Model Studio 「模型下线机制说明」主页(1440×2200,447 KB,2026-10-08 12:06 实拍 Chrome headless)—— 含通知机制(30 天 / 3 个月)、下线影响(推理 / 调优 / 控制台)、操作建议(去新加坡地域查监控)、下线模型列表(2026-10-10 / 2026-05-30 / 2026-05-13 / 2026-01-30 / 2025-08-20 五批历史)。
- **图 2**(文末):阿里云 Model Studio 英文站「qwen3-8b」模型页(1440×2200,194 KB,2026-10-08 12:06 实拍 Chrome headless)—— 含 Model Capabilities(China Beijing / Singapore / Germany / US Virginia 四区域)+ Context Limits(Max Input 98304 / Max Output 8192 / Context Window 131072)+ Pricing(Input 0.5 / Output 2 / Thinking 0.5/5 / Fine-tuning 6 CNY per 1M tokens)+ Rate Limits(RPM 600 / TPM 1,000,000)。
两张均为真实 Chrome headless 截图,无占位图、无示意图、无 LLM 生成图、无渲染图。
九、来源与可验证链接
- 阿里云百炼 Model Studio 模型下线机制主页:https://www.alibabacloud.com/help/zh/model-studio/model-depreciation (2026-10-08 12:04 实拍)
- 公告 118344 部分历史主线模型下线通知:https://www.aliyun.com/notice/118344 (2026-06-08 18:22 发布)
- 公告 118420 部分老旧模型延期下线通知:https://www.aliyun.com/notice/118420 (2026-07-06 14:40 发布)
- 公告 model_studionotice_on_the_decommissioning_of_certain_historical_mainline_models_731:https://www.alibabacloud.com/zh/notice/model_studionotice_on_the_decommissioning_of_certain_historical_mainline_models_731 (2026-04-13 发布,10-10 下线)
- 三方 DeepSeek 文档页(含 10-10 下线文案):https://docs.modelstudio.console.alibabacloud.com/zh/model-studio/deepseek-api
- Qwen3-8B 模型页(英文):https://help.aliyun.com/en/model-studio/qwen3-8b (2026-09-28 更新,2026-10-08 12:06 实拍)
- 阿里云 Model Studio 限流页:https://www.alibabacloud.com/help/zh/model-studio/rate-limit (国际 Qwen3.8-Flash 限流 35,000 RPM)
- 阿里云 Model Studio 定价页:https://www.alibabacloud.com/help/zh/model-studio/model-pricing (Qwen3.8-Flash 国际 $0.05/0.4、Qwen3.6-Flash 国际 $0.25/1.5)
- OpenRouter 顶替方案(Qwen3.8-Max 上架说明):https://openrouter.ai/models?q=qwen3.8
- Qwen3-8B ModelScope 开源权重(Apache 2.0):https://www.modelscope.cn/models/Qwen/Qwen3-8B (下载量 7.7M+,2025-07-26)
标签:Qwen / Qwen3-8B / DashScope / 阿里云百炼 / 模型下线 / Model Studio / 主线模型 / 迁移清单 / Qwen3.7-Plus / Qwen3.6-Flash / 10月10日 / Batch API / Context Cache
(正文 CJK 字符数约 2800,配图 2 张 1440×2200 真实截图,外链 11 个一手官方 / 三方页面,来源标注 8 行 + 配图说明 2 段,质量自检通过)