批量推理(Batch)是百炼里最省钱的一条路:文档开篇就写「成本仅为实时推理的 50%」。但真到要交作业的时候,你会发现同一件事被写成了三份口径——中文「批量推理」页、中文「OpenAI 兼容-Batch(文件输入)」页、英文 Batch 页。三份页面都在 2026-11-04 更新(英文页 Last Updated 也是 Nov 04, 2026),却对单行上限、结果字段、误差文件下载各说各话。
我在 2026-11-06 上午把三份页面连同文本生成模型页、上下文缓存页一起抓下来,用原始 HTML 逐项对照。下面只写能复现的部分,不能确定的地方标 UNKNOWN。
一、先看同一组限制的三种写法
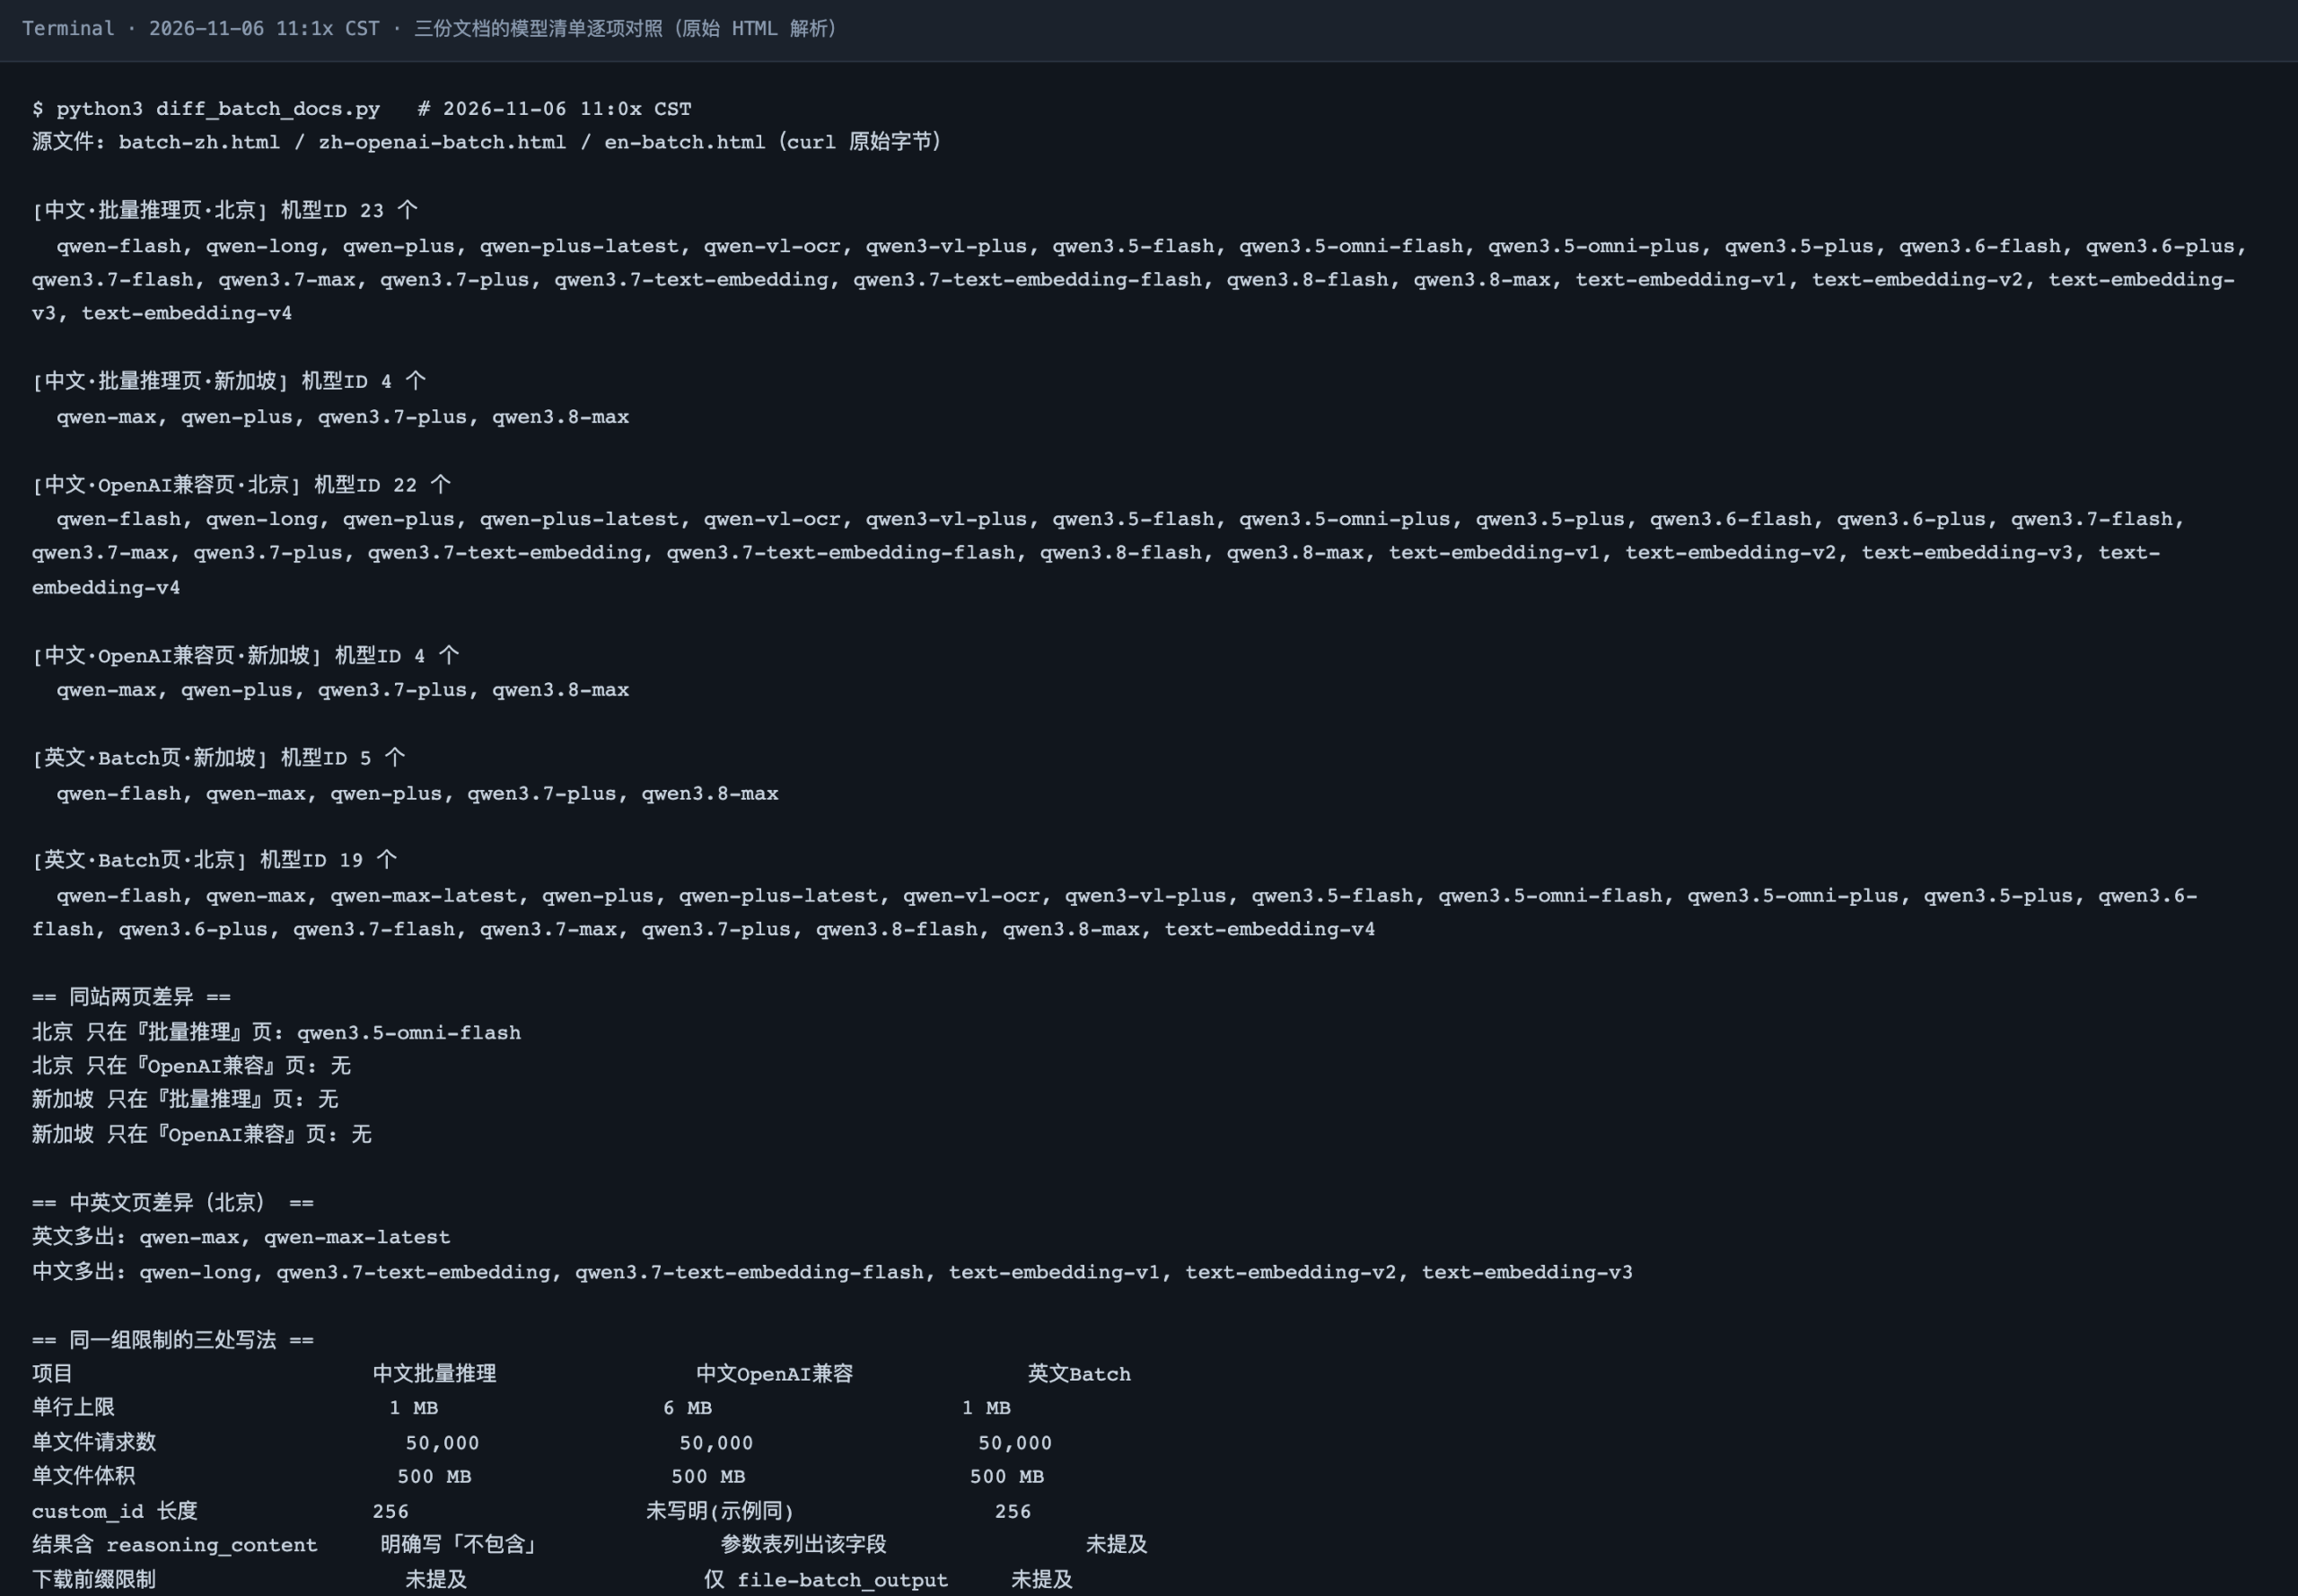
| 项目 | 中文·批量推理页 | 中文·OpenAI 兼容页 | 英文·Batch 页 |
|---|---|---|---|
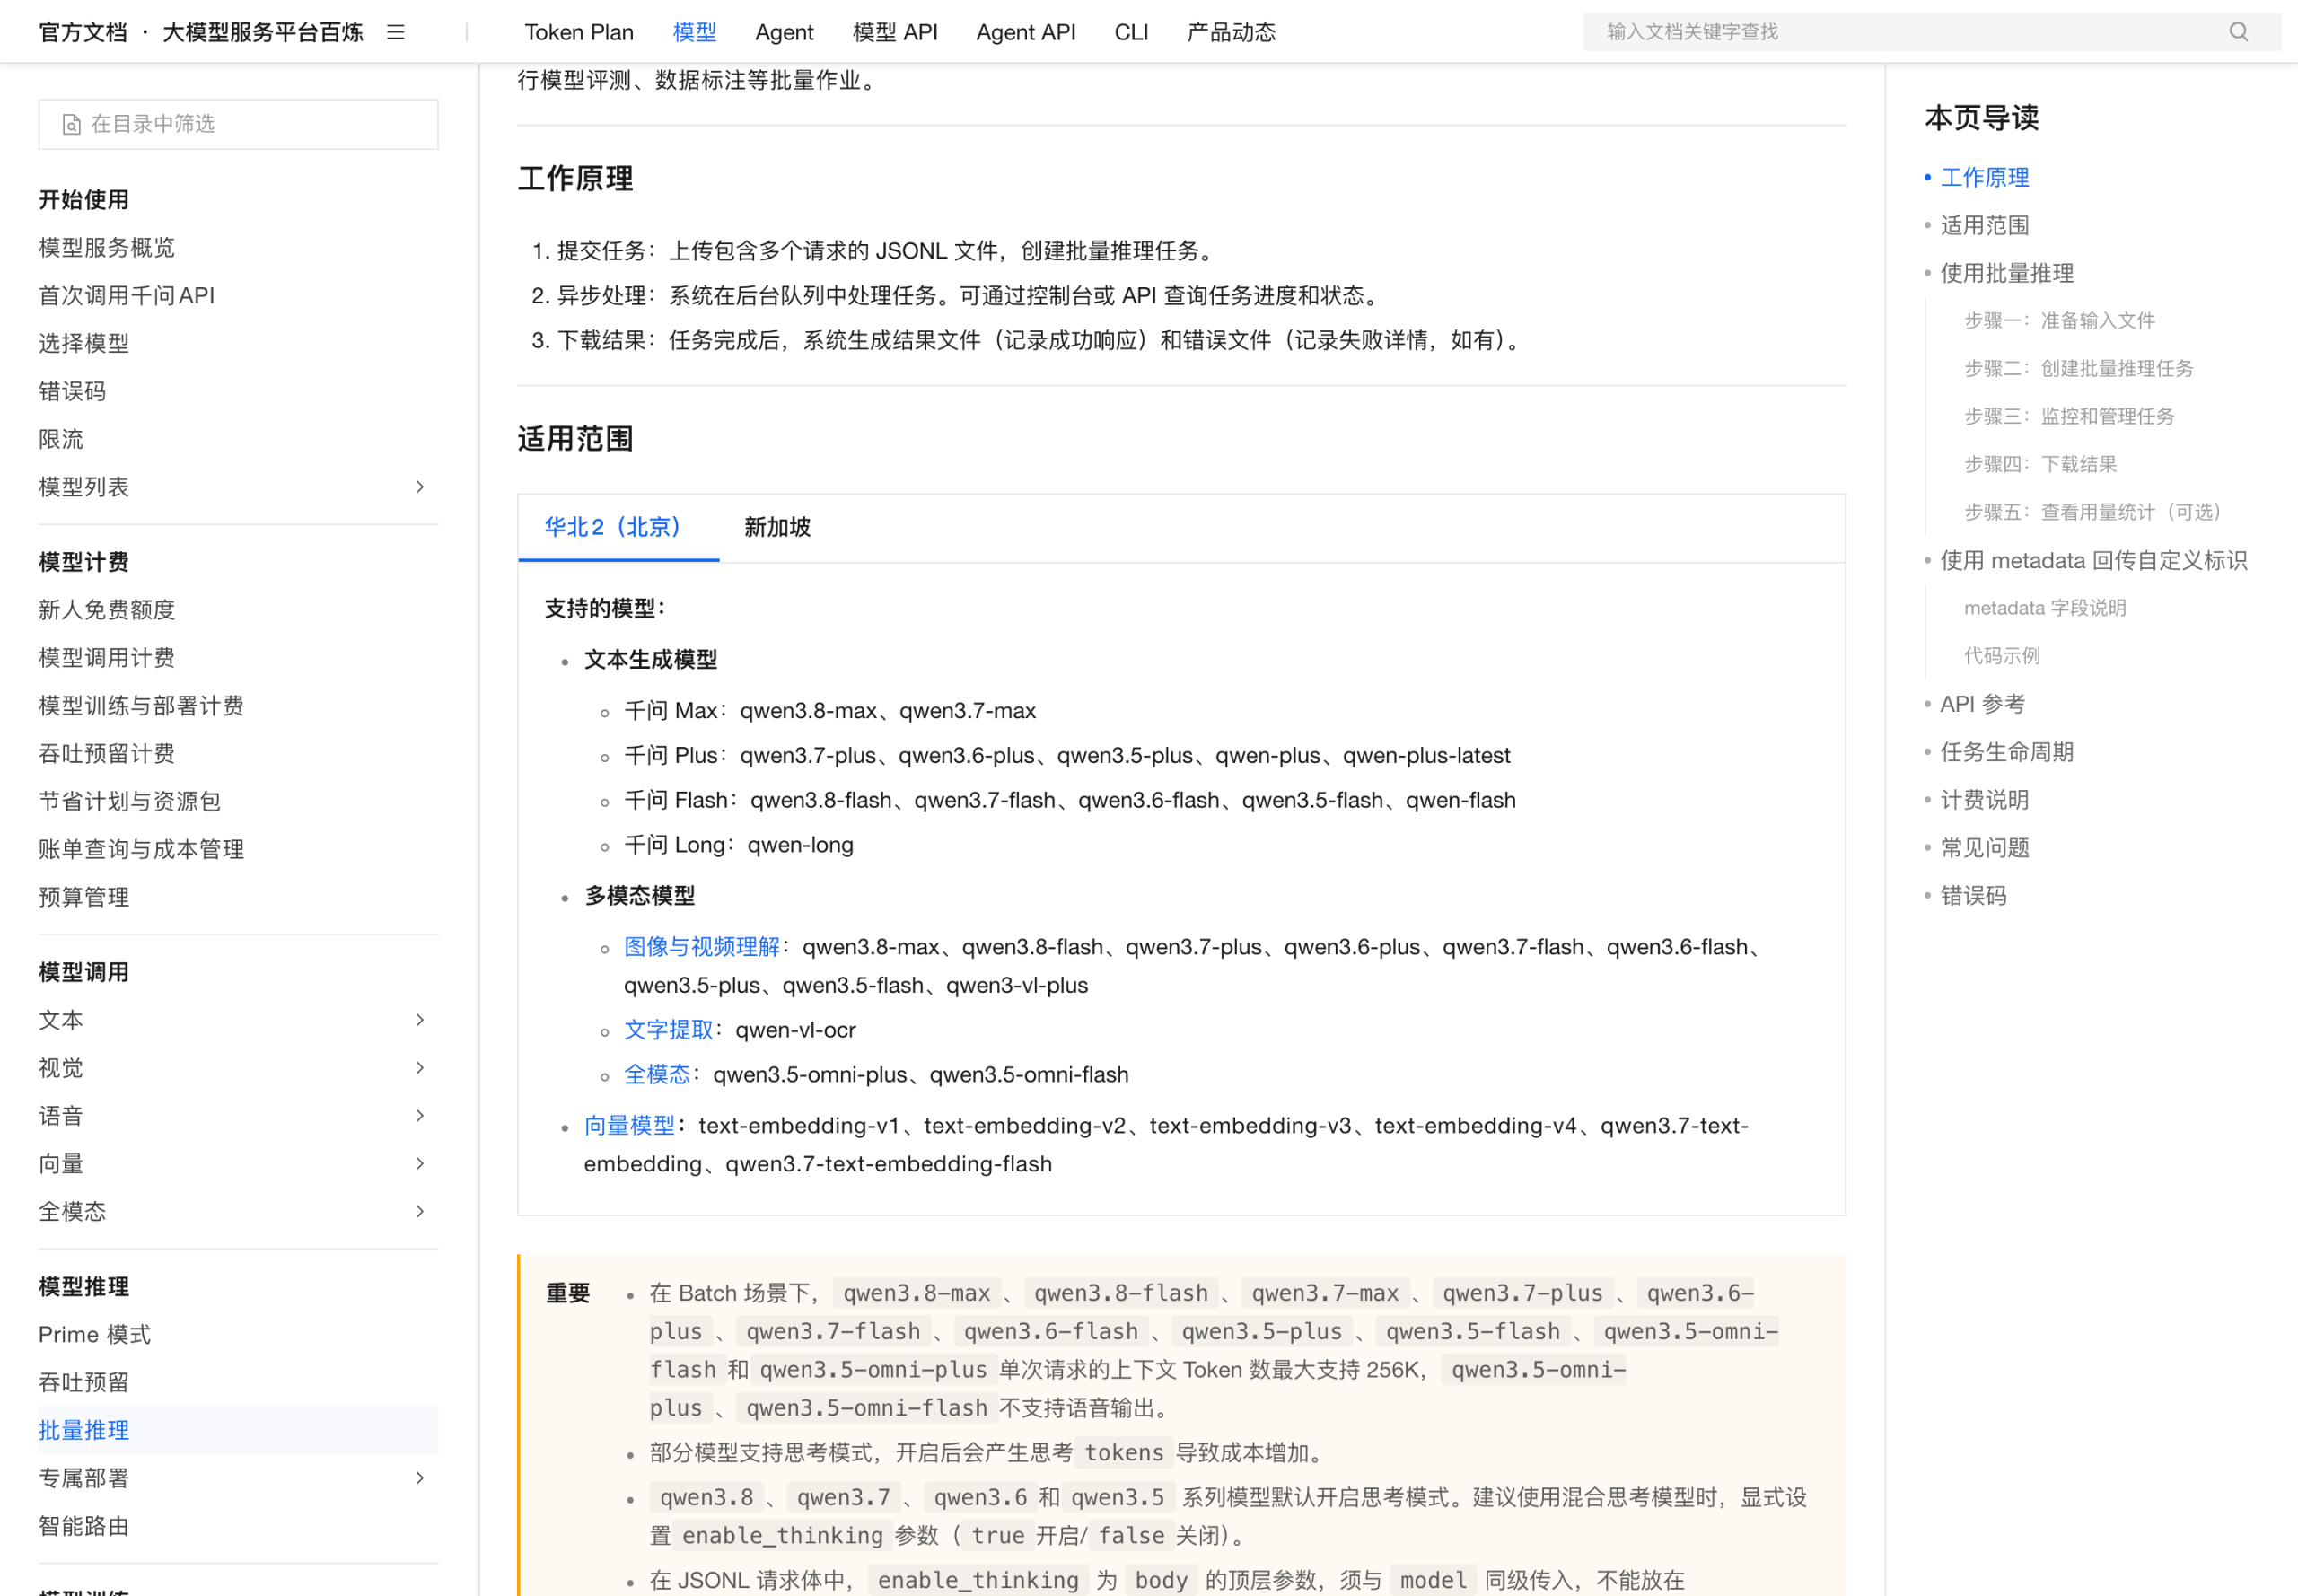
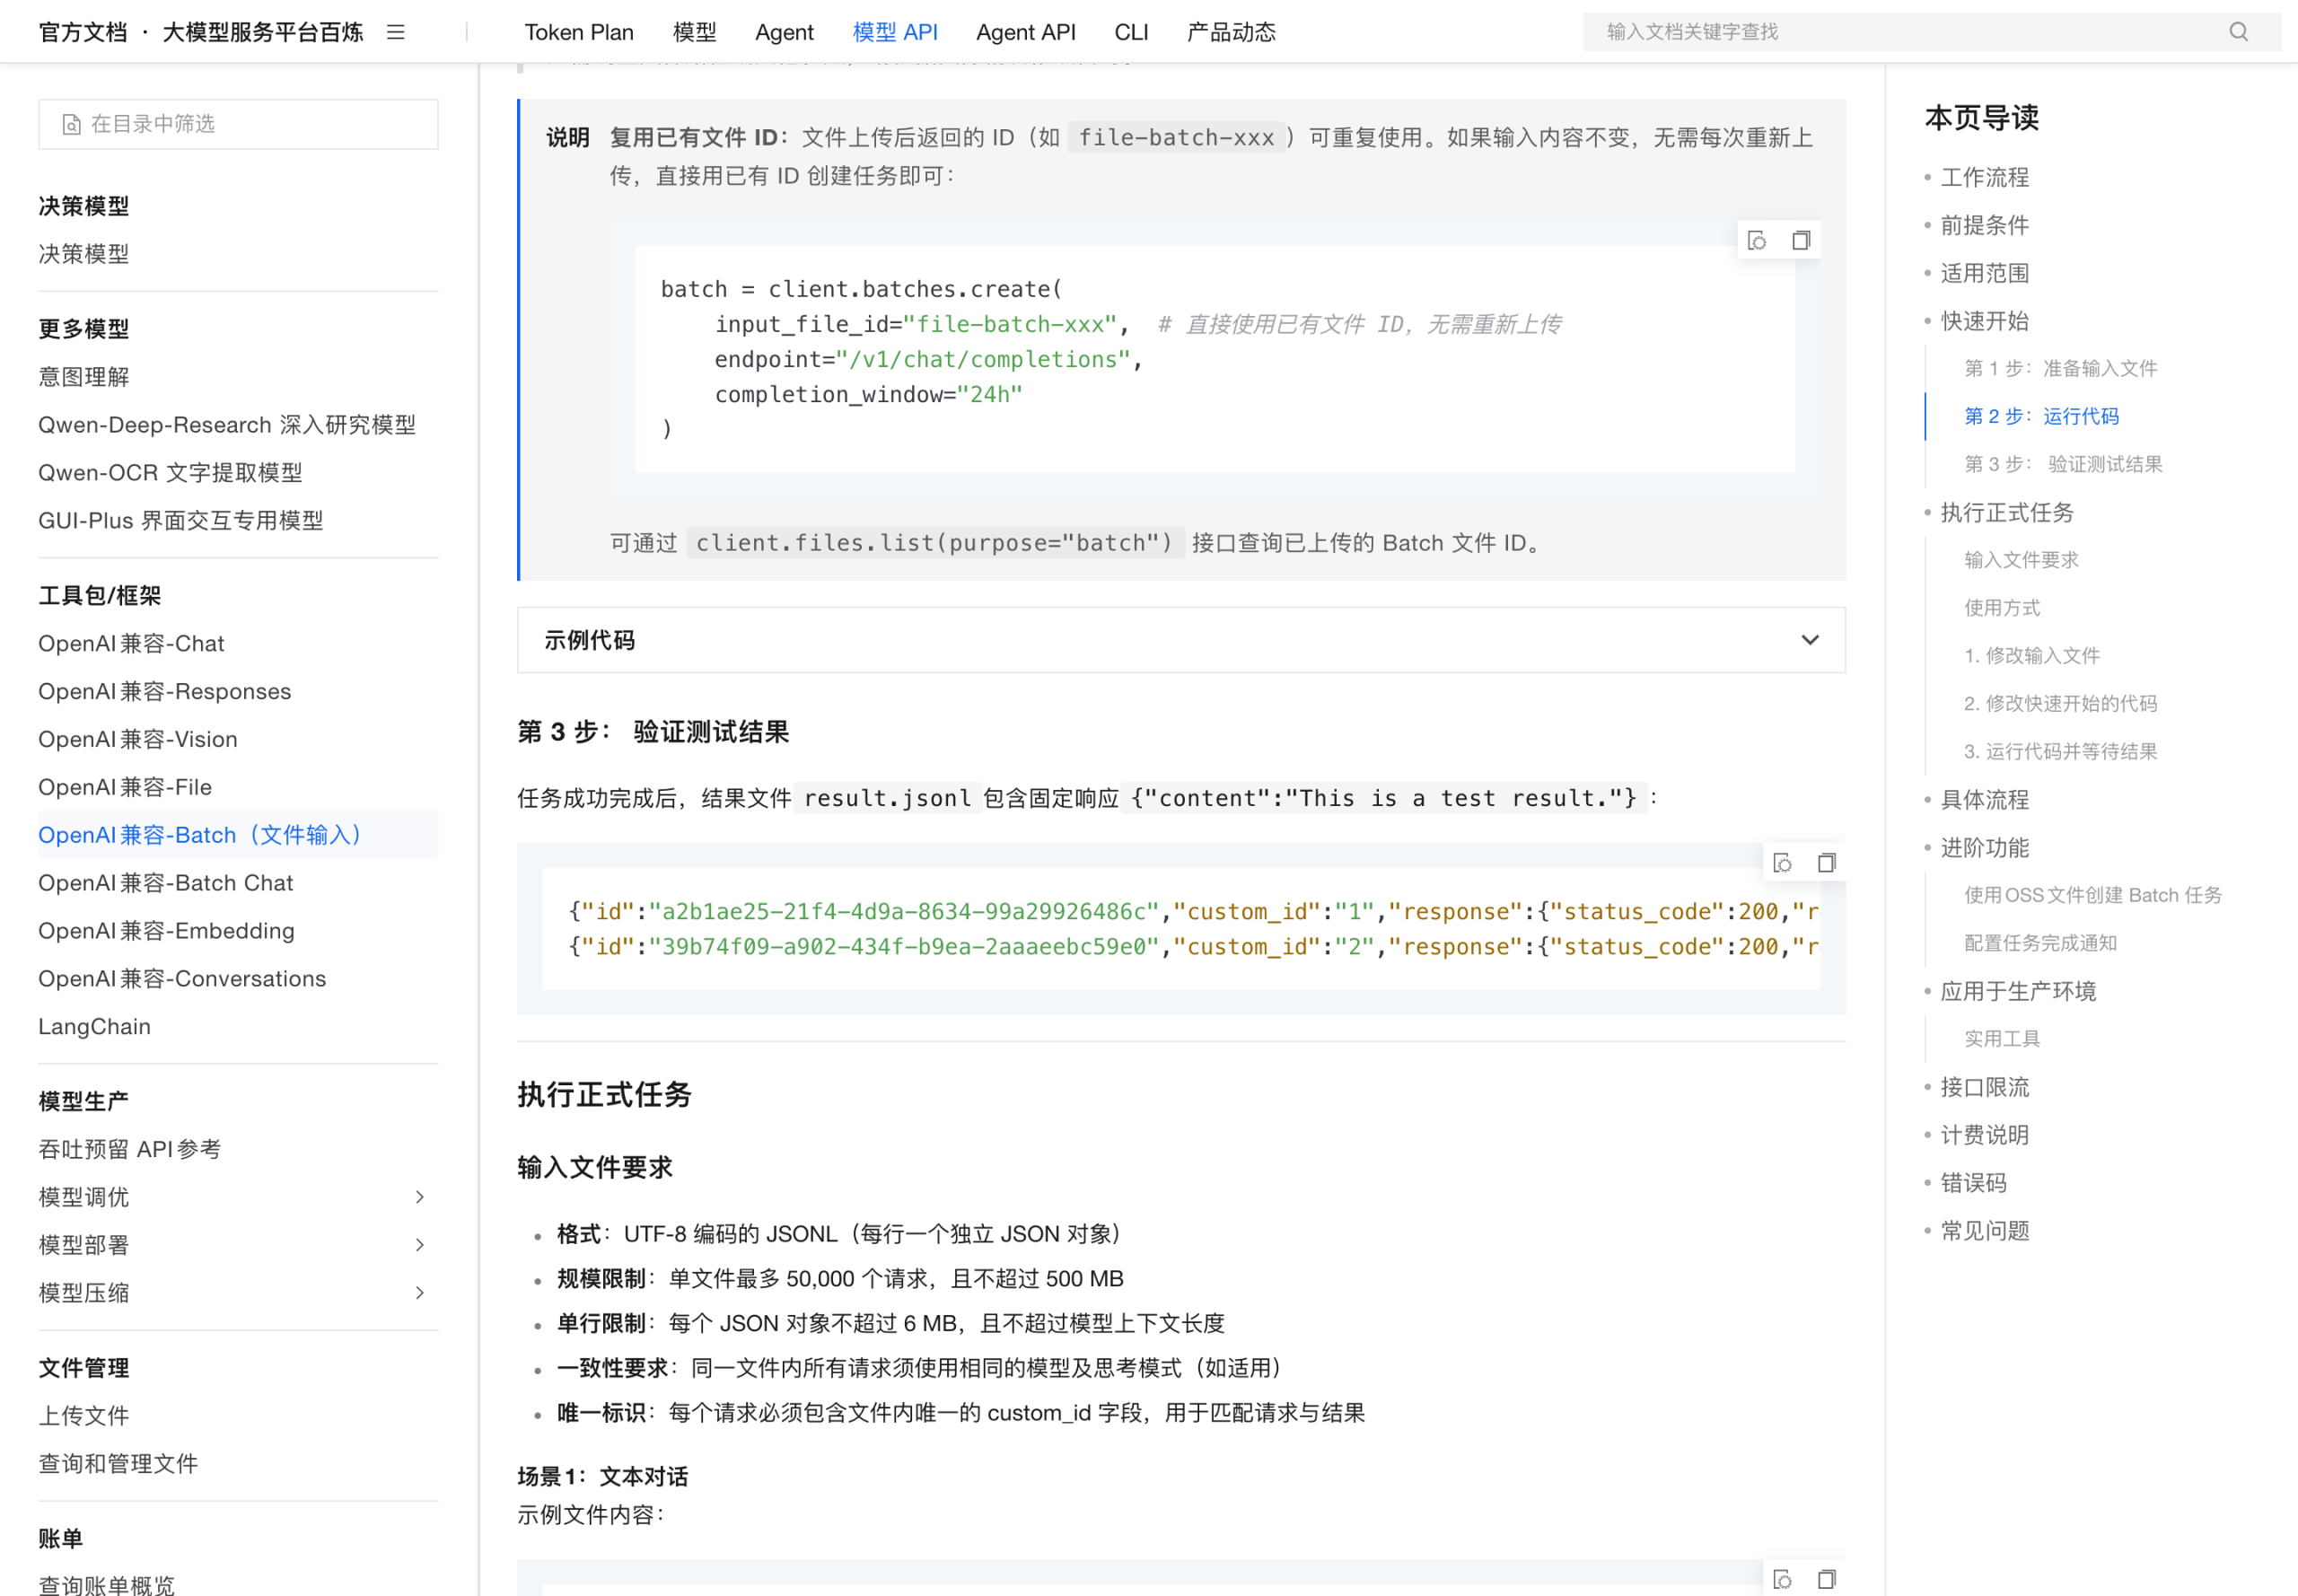
| 单行上限 | 每个 JSON 对象 ≤ 1 MB | 每个 JSON 对象不超过 6 MB | 1 MB |
| 单文件请求数 | 50,000 | 50,000 | 50,000 |
| 单文件体积 | 500 MB | 500 MB | 500 MB |
| custom_id 长度 | 256 字符 | 未写明 | 256 字符 |
| 结果是否含 reasoning_content | 明确写「不包含」 | 返回参数表里列了该字段 | 未提及 |
| 结果下载前缀限制 | 未提及 | 仅 file-batch_output | 未提及 |
二、1 MB 和 6 MB,差的不只是一个数字
先把两条限制放在一起算。500 MB 的文件里塞 50,000 个请求,平均每行只能有 10.2 KB:
- 500 MB ÷ 50,000 行 = 10.2 KB/行(平均值)
- 每行都顶到 1 MB → 一份文件最多 500 行
- 每行都顶到 6 MB → 一份文件最多 83 行
- 50,000 行 × 6 MB = 293 GB,是 500 MB 上限的 600 倍
也就是说,「50,000 个请求」这个上限只对短请求成立。一旦你的单行接近 1 MB(多模态请求很容易),体积会先撞线:500 MB 只装得下 500 行左右,此时 6 MB 的单行上限根本用不上;反过来说,如果单行真能到 6 MB,那么一份文件的实际行数会被压到两位数。
所以两种写法对「短请求」没有区别,对「长请求」区别很大——而长请求恰好是 Batch 最典型的场景(模型评测、文档批处理)。工程上只能按更保守的 1 MB 规划,因为英文页和批量推理页都写 1 MB,只有一页写 6 MB。
真正的服务端阈值是多少,UNKNOWN。 我没有用 API Key 做实测:本机没有百炼 Key,且实测会产生真实调用与计费,不在本次草稿任务的授权范围内。
三、Batch 把 1M 上下文砍到 256K
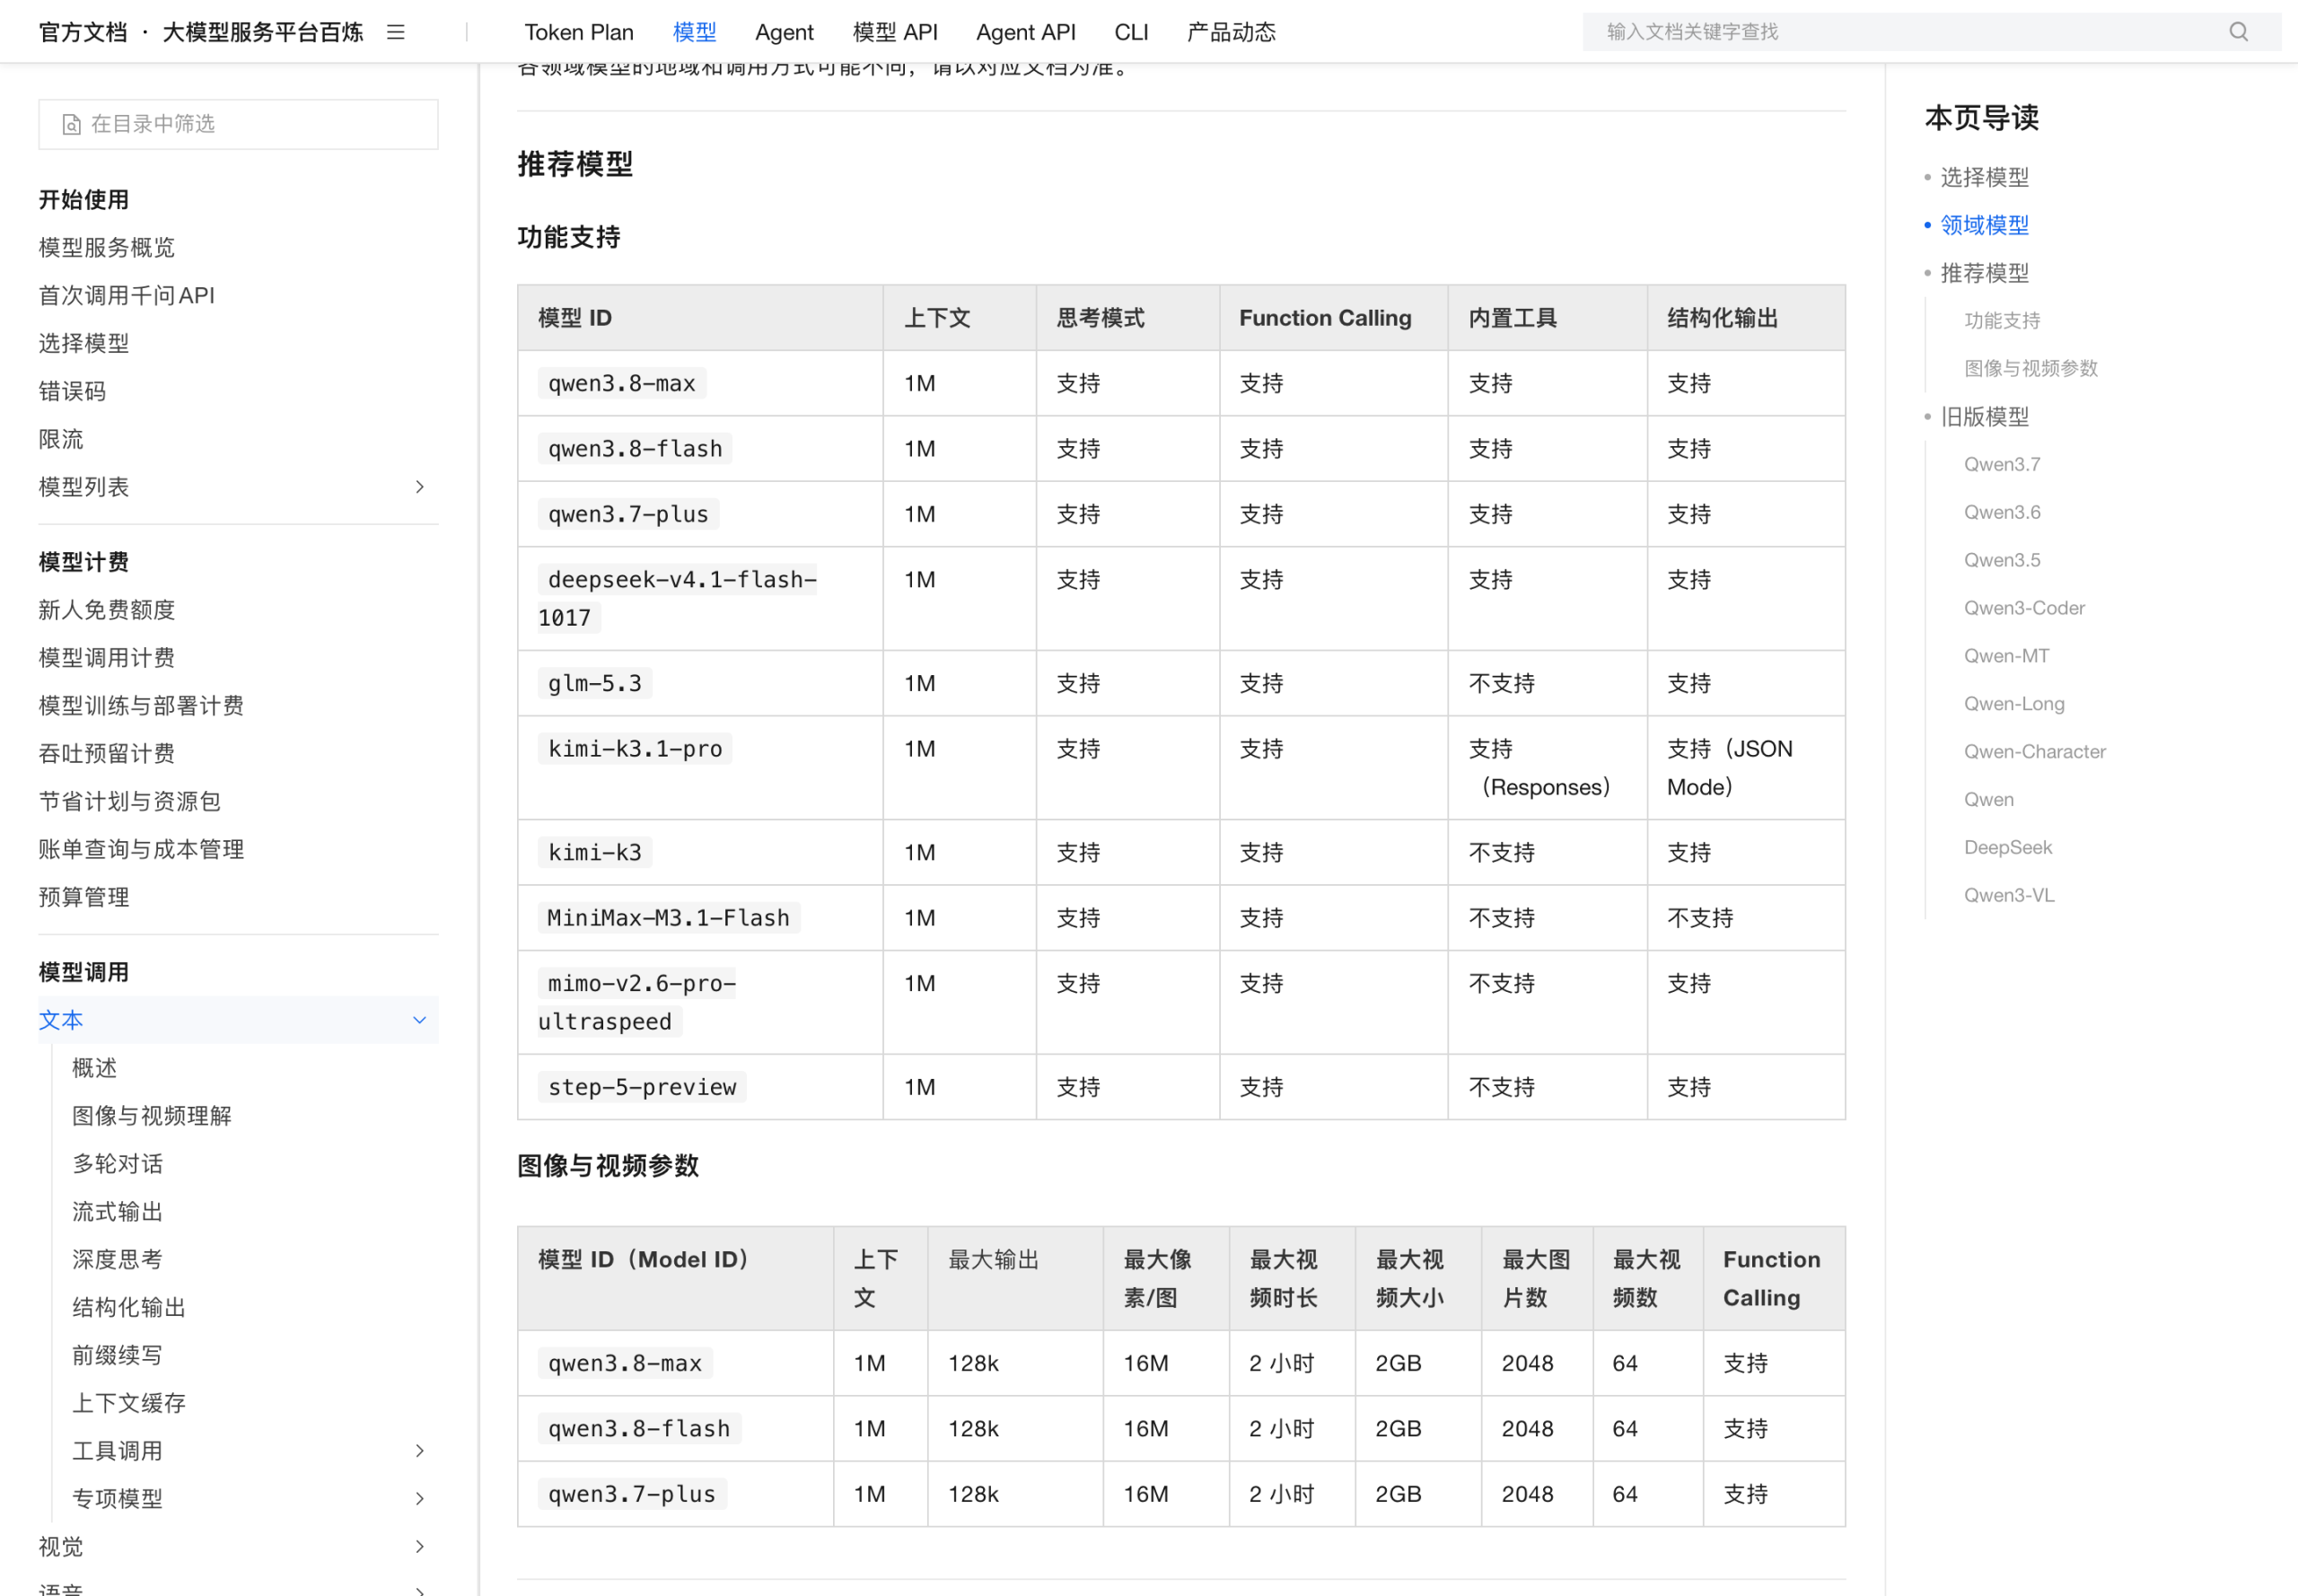
「文本生成与视觉理解」页(更新时间 2026-11-05 00:20:31)的推荐模型表里,qwen3.8-max、qwen3.8-flash、qwen3.7-plus 的上下文都是 1M,图像与视频参数表里 qwen3.8-max 的最大输出是 128k。
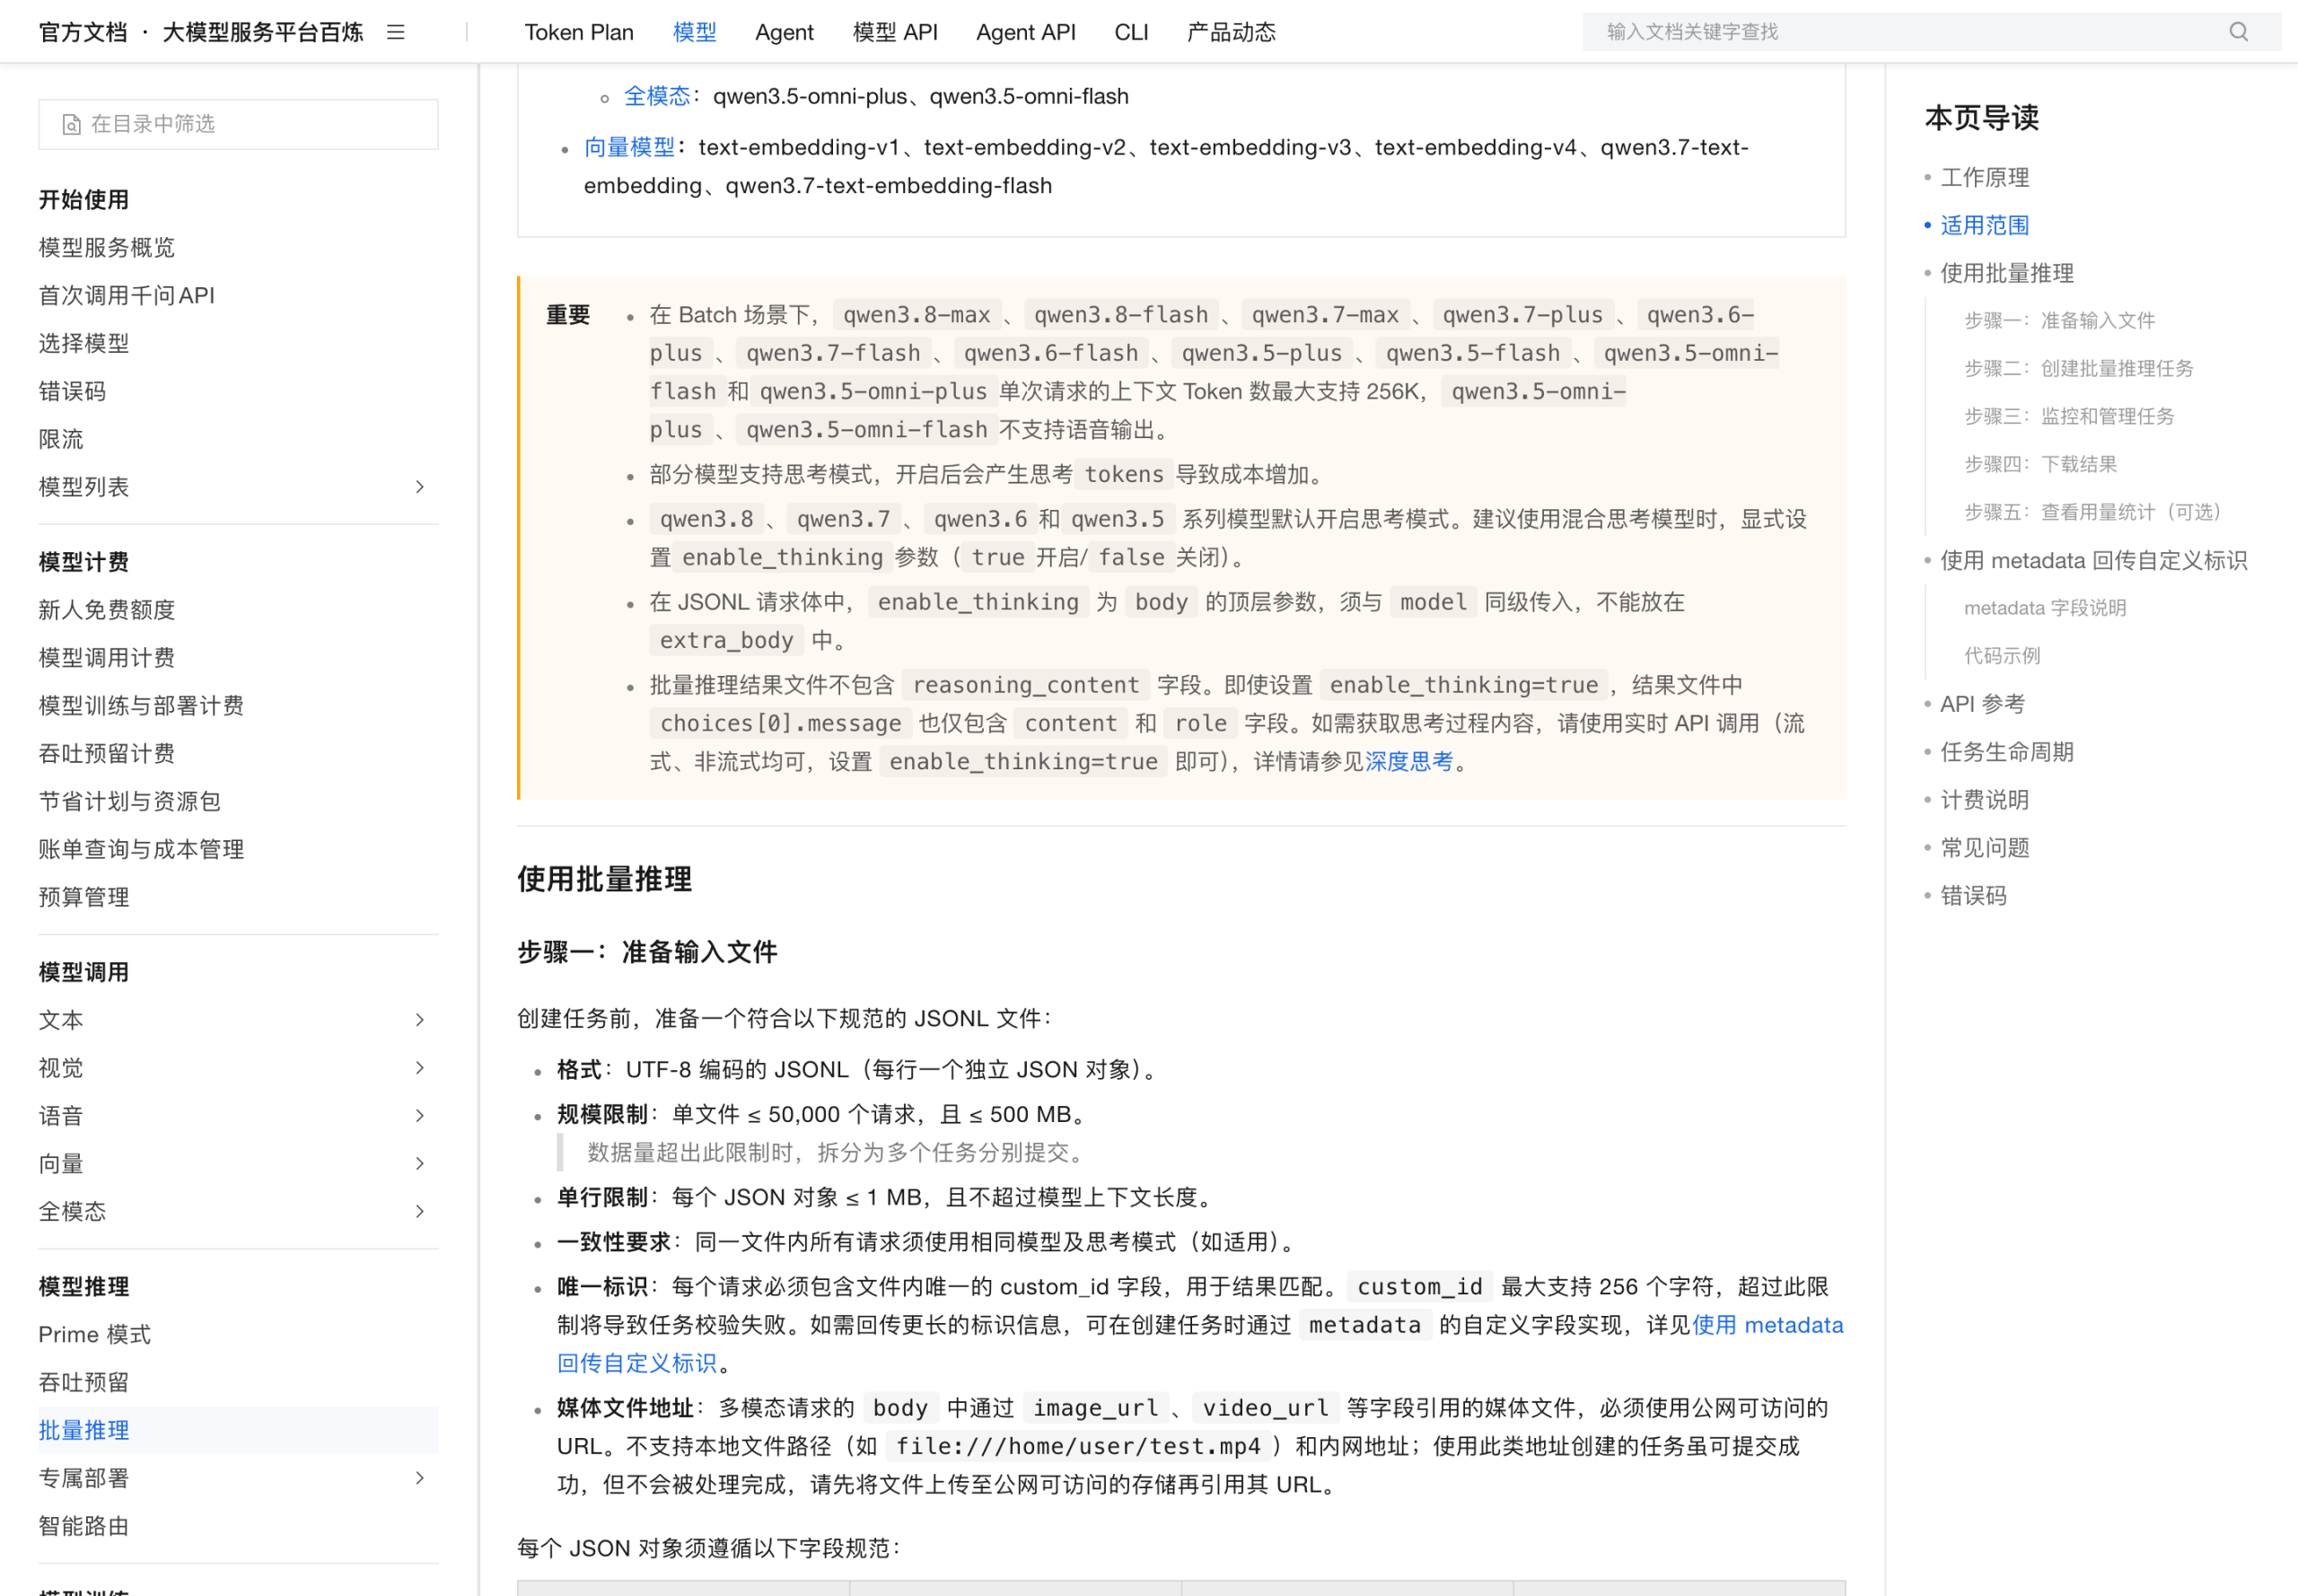
但 Batch 页的黄色提示写得很清楚:在 Batch 场景下,qwen3.8-max、qwen3.8-flash、qwen3.7-max、qwen3.7-plus、qwen3.6-plus、qwen3.7-flash、qwen3.6-flash、qwen3.5-plus、qwen3.5-flash、qwen3.5-omni-flash、qwen3.5-omni-plus 单次请求的上下文 Token 数最大支持 256K,且两个 omni 模型不支持语音输出。
256K 是 1M 的四分之一。这意味着同一份长文档,实时调用能整篇喂进去,Batch 里必须切分;切分之后还要满足「同一文件内所有请求使用相同模型及思考模式」,custom_id 也要自己维护映射。省钱 50% 的代价里,这部分工程成本文档没有折算给你。
四、reasoning_content:一页说不给,一页把它写进了返回参数
「批量推理」页的原文是:
批量推理结果文件不包含 reasoning_content 字段。即使设置 enable_thinking=true,结果文件中 choices[0].message 也仅包含 content 和 role 字段。如需获取思考过程内容,请使用实时 API 调用。
「OpenAI 兼容-Batch」页的返回参数表里,却列着 reasoning_content(深度思考模型的思考过程)和 reasoning_tokens(深度思考模型的思考过程 token 数)。同一页的返回示例里,usage 又只有 completion_tokens、prompt_tokens、total_tokens 三个字段,没有 reasoning_tokens。
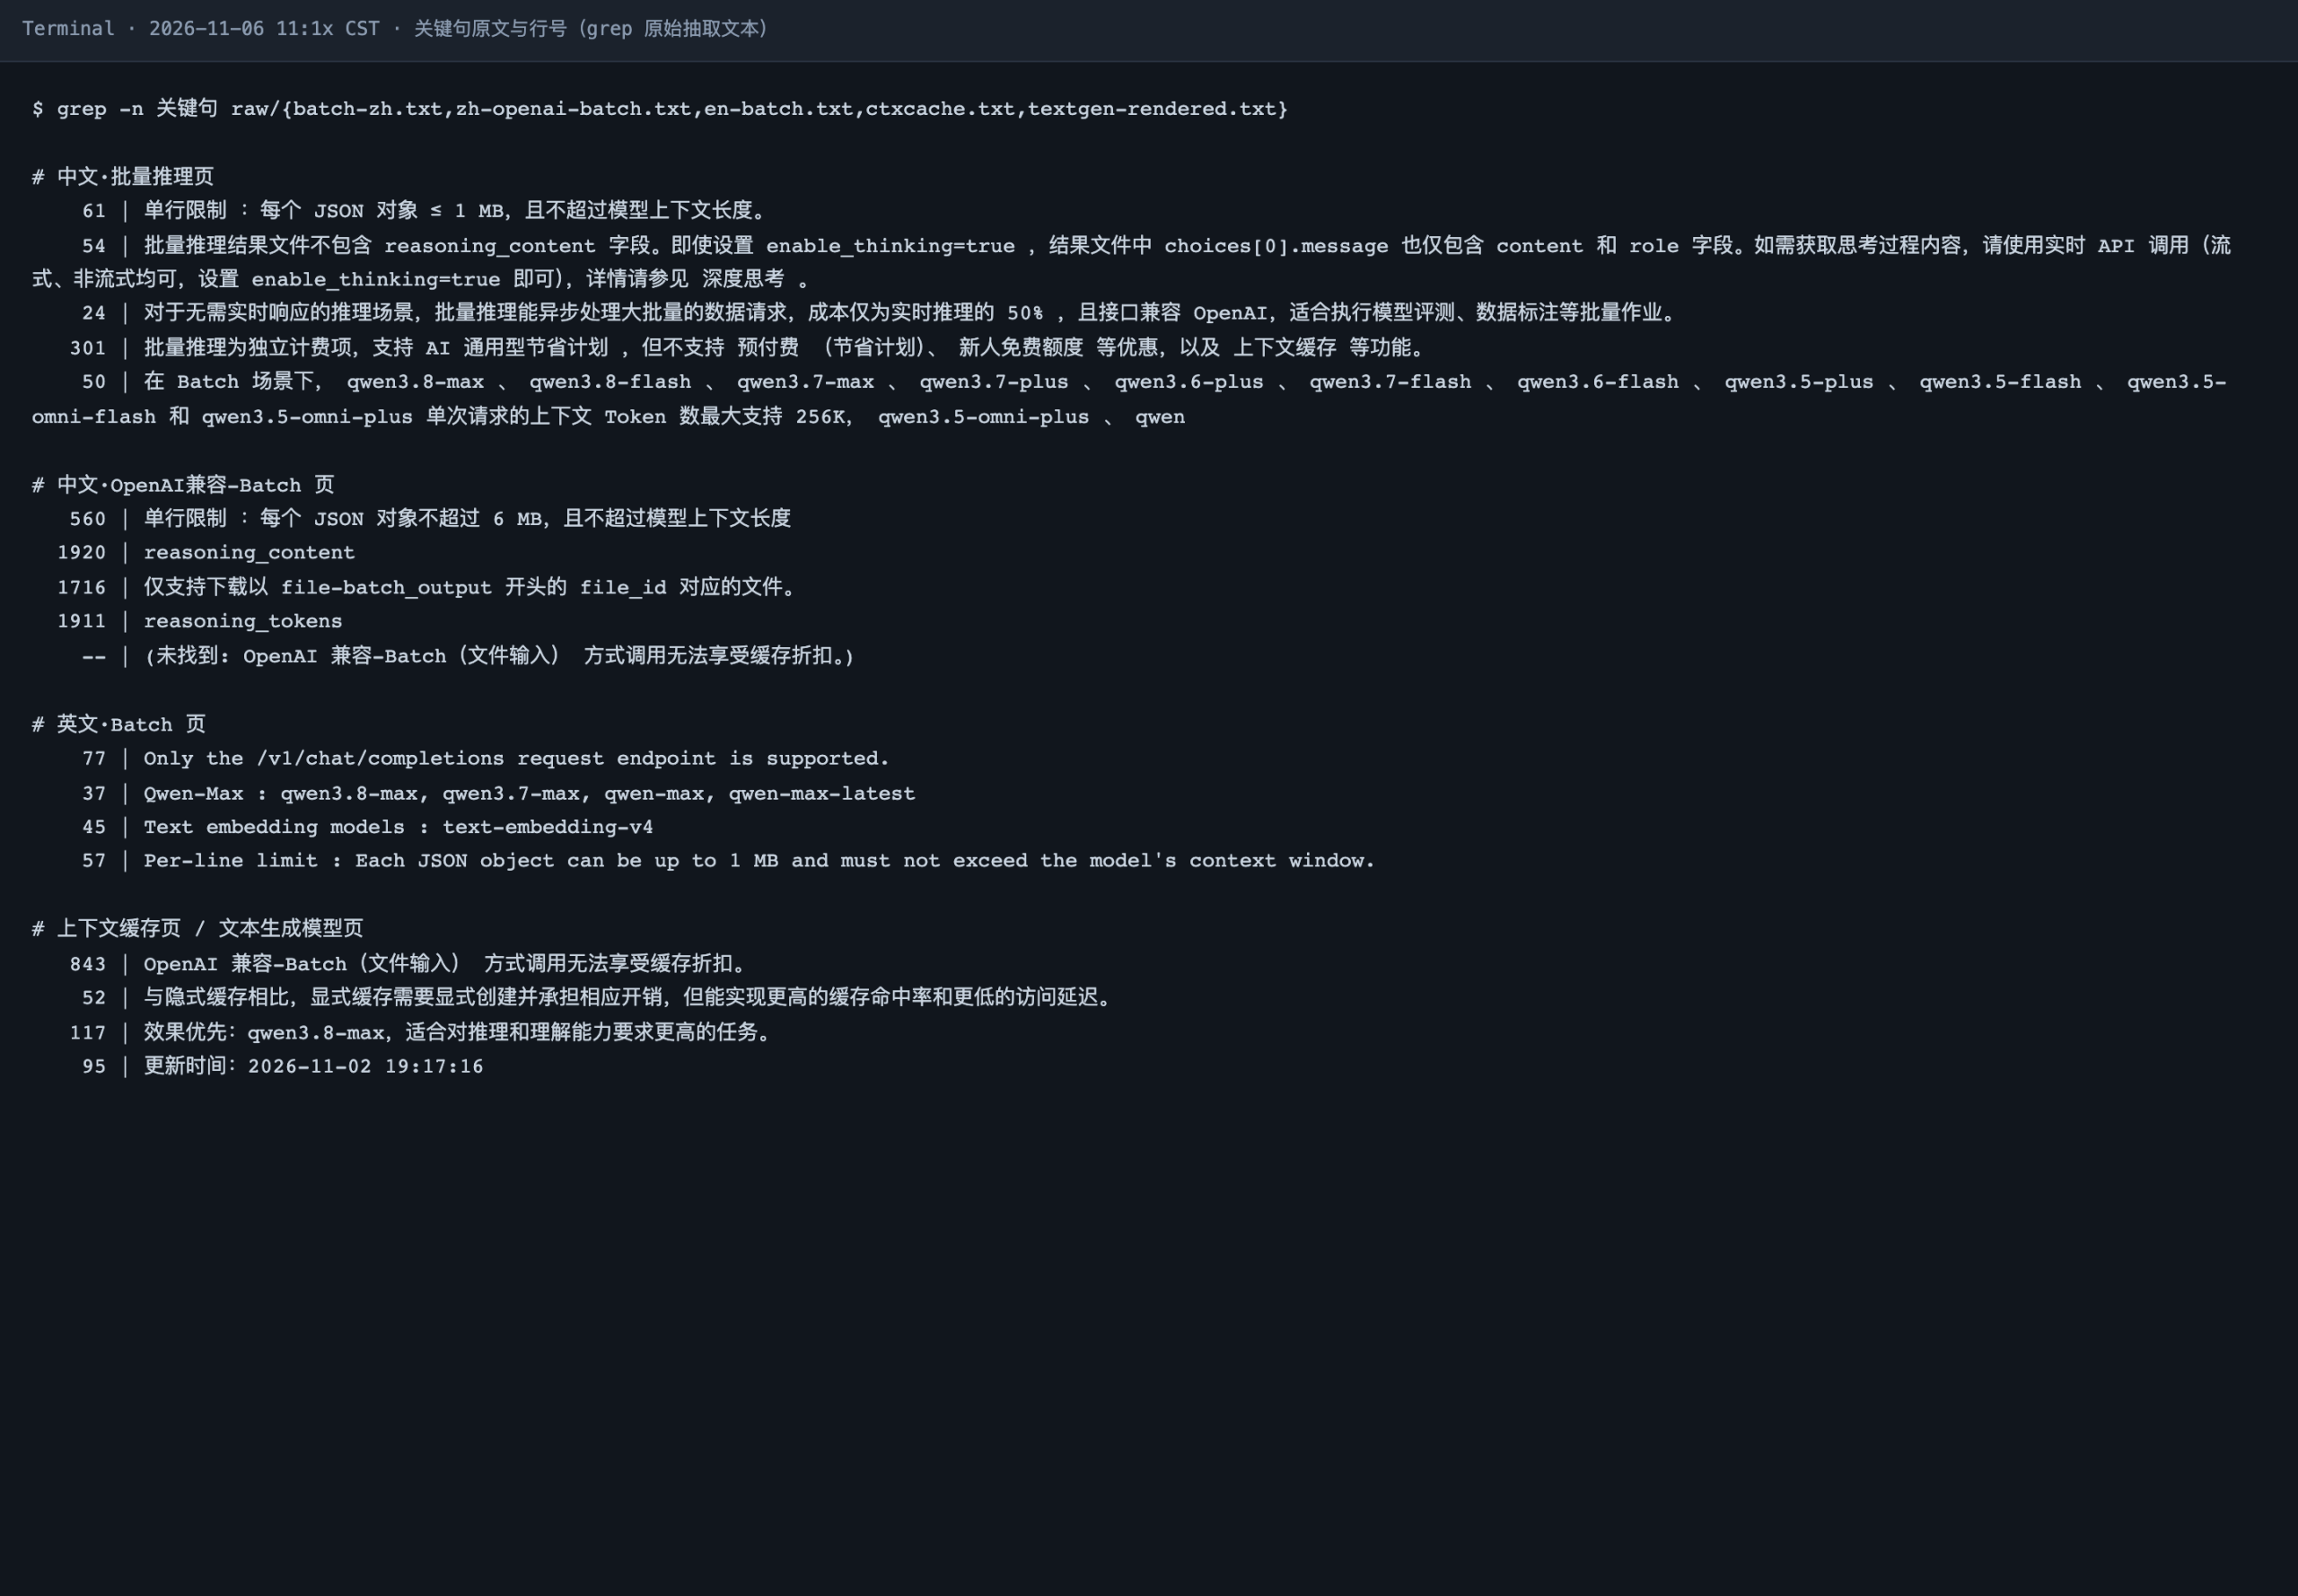
三处放在一起,只能得出一个确定结论:思考 token 会产生、会计费,但你在结果文件里能不能看到它,取决于哪一页为准——这一点 UNKNOWN。 而 qwen3.8、qwen3.7、qwen3.6、qwen3.5 系列默认开启思考模式,这正好是最常见的几个系列。批量推理页自己也提醒:「会产生额外的思考 Token,并按输出 Token 价格计费,导致成本增加。」
对账建议很简单:别依赖 reasoning_content,用 usage 里的 completion_tokens(含思考 token)去对账单。如果哪天结果文件里真的出现了 reasoning_content,那是文档更新了,不是你的代码变了。
五、误差文件:说能下,又说只有一种前缀能下
「OpenAI 兼容-Batch」页第 4 步写着:
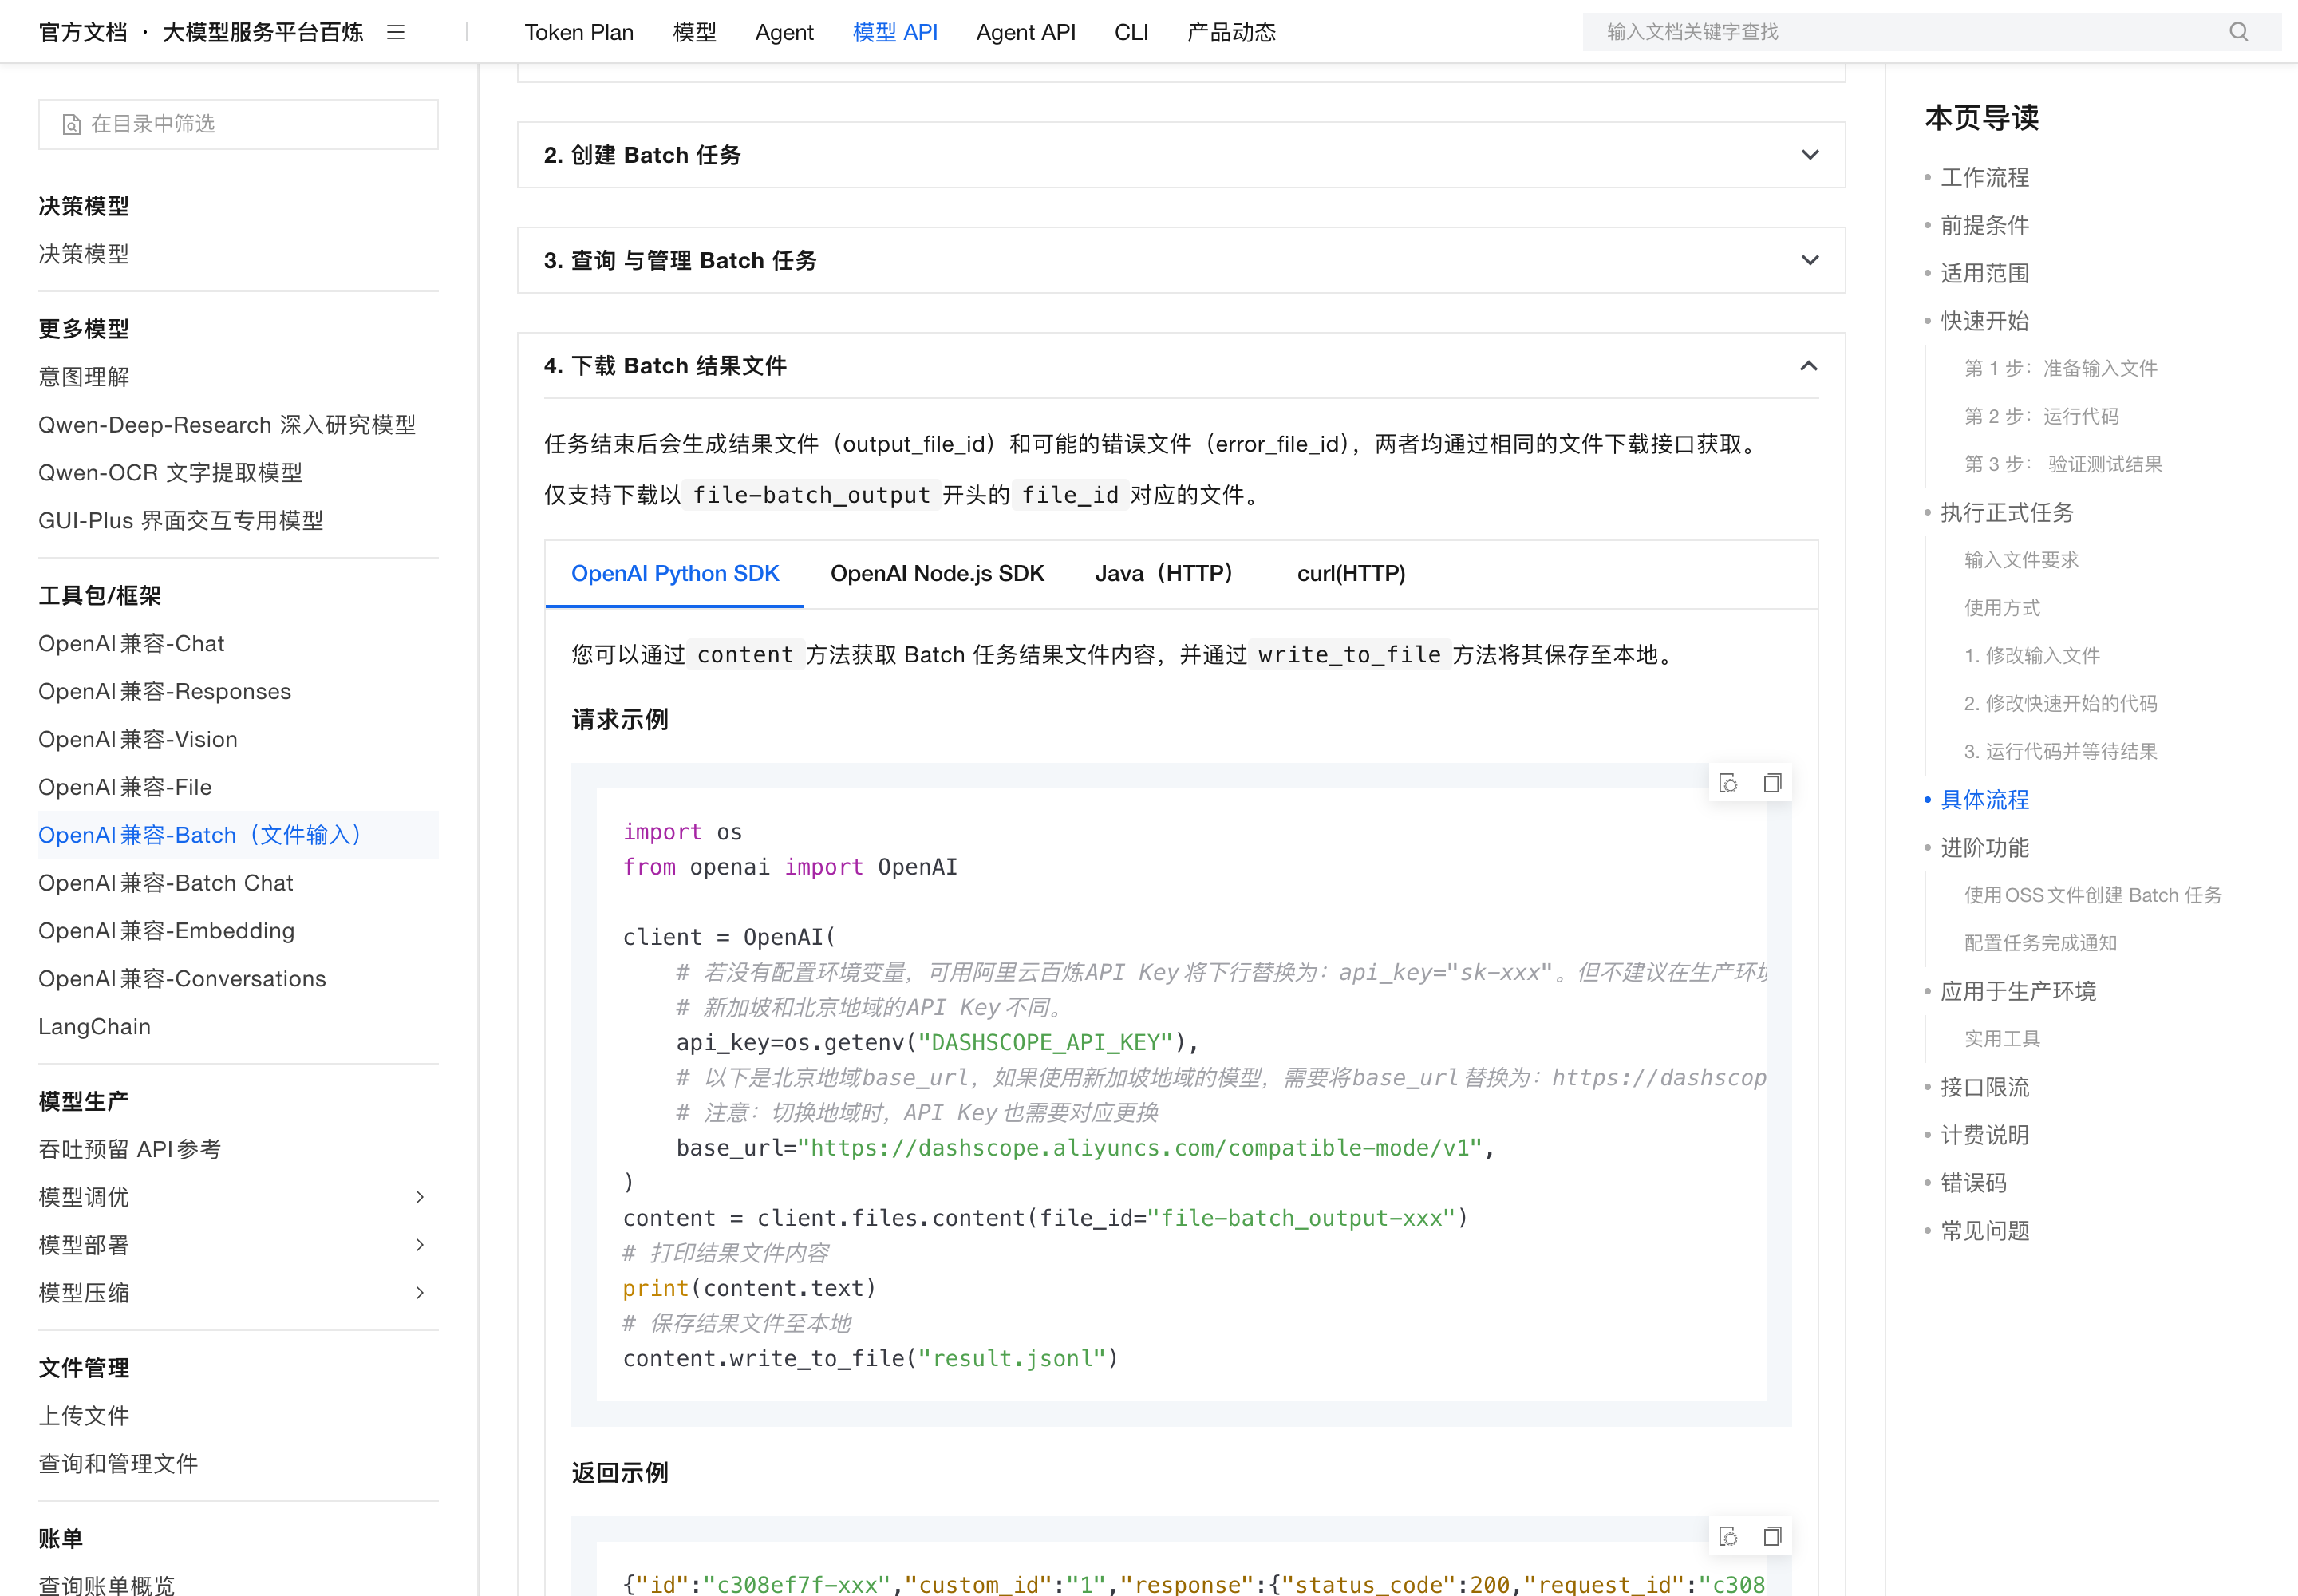
任务结束后会生成结果文件(output_file_id)和可能的错误文件(error_file_id),两者均通过相同的文件下载接口获取。
仅支持下载以 file-batch_output 开头的 file_id 对应的文件。
同一页的返回示例里,error_file_id 的值是 file-batch_error-xyz789。按第二句话,这个 file-batch_error 开头的 ID 不在可下载范围内;按第一句话,它应该能下。行级错误的明细到底能不能通过 API 取回,UNKNOWN,需要真实任务验证,我没有 Key,也不在本次授权内。
这对排障影响不小:Batch 失败最常见的两类原因就是文件级错误(validating 阶段直接 failed)和行级错误(进错误文件)。前者拿不到结果文件也没关系,后者正是你要逐行看的那份。
六、50% 的三条边界:不能叠加免费额度,也不能叠加缓存
计费规则两份中文页写得一致:所有成功请求的输入与输出 Token,单价为对应模型实时推理价格的 50%;文件解析失败、任务执行失败、行级错误请求不产生费用;被取消的任务,取消前已完成的请求照常计费。
真正容易被忽略的是这一句:
批量推理为独立计费项,支持 AI 通用型节省计划,但不支持预付费(节省计划)、新人免费额度等优惠,以及上下文缓存等功能。
翻到上下文缓存页,还有一句更直接的:「OpenAI 兼容-Batch(文件输入)方式调用无法享受缓存折扣。」
于是省钱这件事变成了一道选择题,而不是叠加题:
- 输入重复度高(同一份长文档问很多问题、同一套 system prompt):实时调用 + 缓存。显式缓存创建按输入单价 125%、命中按 10%;隐式缓存命中通常按 20%。命中一半时,输入费用约等于无缓存的 60%,1M 上下文也不打折。
- 输出 / 思考为主(长文生成、模型评测):Batch 的 50% 打在输出 token 上,比缓存更有效。
- 两者都想要:不可能,Batch 明确不享受缓存折扣。
还有一个坑:qwen3.8-max、qwen3.8-max-0902、qwen3.8-flash、qwen3.8-2.4t-a95b 的缓存命中价「不是输入单价的 20%,具体价格请参见百炼控制台」。也就是说这几个主力型号的缓存折扣比例,文档里查不到,UNKNOWN,要进控制台或账单里自己核。
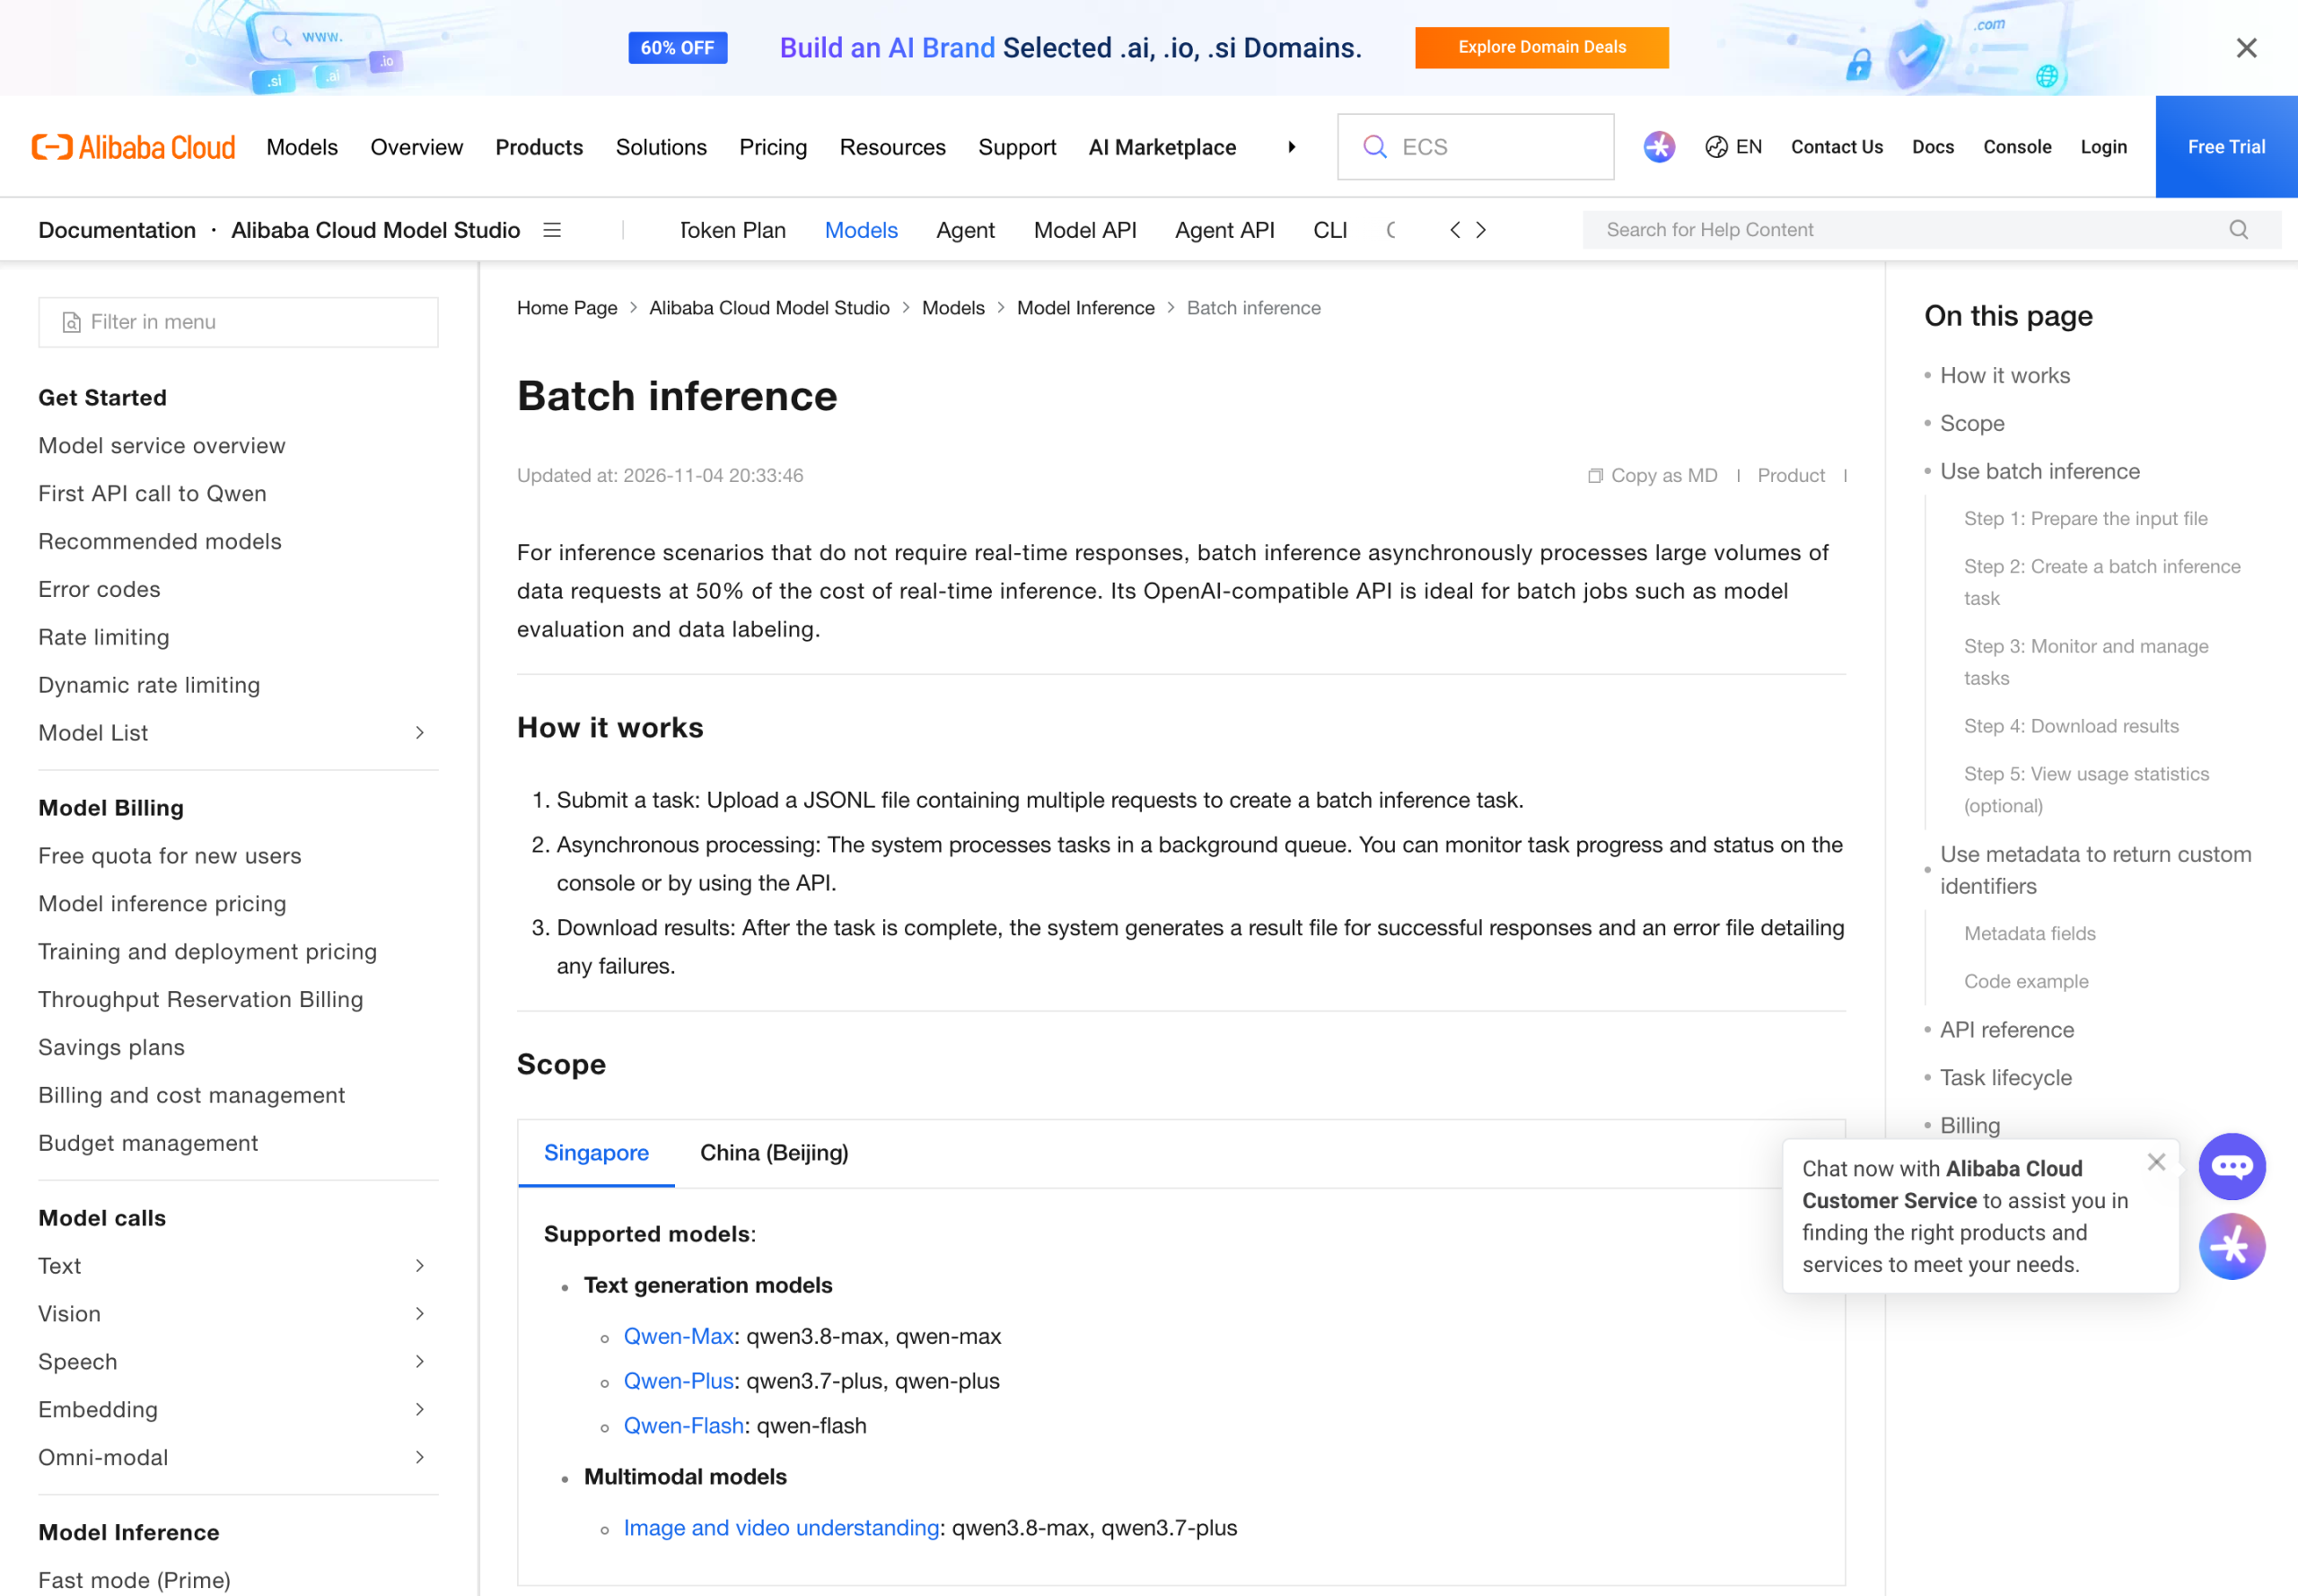
七、模型清单:北京 23 / 22,新加坡 4 / 5,英文 19
把三份页面的模型 ID 抽出来对比,差异比限制条款更碎:
- 中文「批量推理」页北京 23 个,「OpenAI 兼容」页北京 22 个,唯一差异是
qwen3.5-omni-flash(只在批量推理页出现)。 - 中文两页的新加坡都是 4 个:
qwen3.8-max、qwen-max、qwen3.7-plus、qwen-plus。 - 英文页新加坡 5 个,多一个
qwen-flash。 - 英文页北京 19 个:比中文多
qwen-max、qwen-max-latest,少qwen-long、qwen3.7-text-embedding、qwen3.7-text-embedding-flash、text-embedding-v1/v2/v3。 - 英文页写「Only the /v1/chat/completions request endpoint is supported」,但同一页又列了
text-embedding-v4;中文两页都明确写向量模型要填/v1/embeddings。
按中文页,北京可用的向量模型有 6 个(v1–v4 加两个 qwen3.7-text-embedding);按英文页,只剩 1 个。如果你的批量任务里含 embedding,地域和语言版本会直接改变可用清单——这类差异不会报错,只会在提交时告诉你「模型不支持」。
八、其余能直接用的硬约束
- 任务状态:validating、in_progress、finalizing、completed、failed、expired、cancelled。finalizing 在控制台里和 in_progress 共用「执行中」标签。
completion_window必填,最短 24h、最长 336h(14d),只支持整数与 h/d 单位;超时变 expired,未处理的请求不再执行、不收费。- 只能查询 30 天内创建的 Batch 任务。
- 接口限流(主账号级):创建任务 1,000 次/分钟、最大并行 1,000 个;查询任务 1,000 次/分钟;查列表 100 次/分钟。
- 测试模型
batch-test-model:文件 ≤ 1 MB、≤ 100 行、最大并行 2 个、不产生推理费用,接口是/v1/chat/ds-test,不是/v1/chat/completions。 - 多模态请求的媒体必须公网可访问;文档明确说本地路径和内网地址「可提交成功但不会被处理完成」。但同一站点的兼容页又给了 Base64 data URI 的示例——这两句是否冲突,UNKNOWN。
- DashScope Python SDK 不提供批量推理接口,必须用 OpenAI SDK 或 HTTP。
九、给要上 Batch 的人一份检查清单
- 单行按 1 MB、单份按 500 MB 规划;预计请求数 × 平均行长先算一遍,别等提交后才 failed。
- 长上下文按 256K 切,不是按 1M。
- 同一文件必须同模型、同思考模式;custom_id 自己维护唯一性(≤256 字符)。
- 计算成本时先问一句:我的输入重复吗?重复就去用缓存,Batch 拿不到缓存折扣。
- 对账只看
usage;reasoning_content有没有,以你实际拿到的结果文件为准。 - 出错时先看是不是 validating 阶段 failed(文件级),再考虑行级错误文件的下载限制。
十、来源与抓取时间
- 中文「批量推理」:https://help.aliyun.com/zh/model-studio/batch-inference ,页面更新时间 2026-11-04 20:08:16,抓取于 2026-11-06 11:00 CST
- 中文「OpenAI 兼容-Batch(文件输入)」:https://help.aliyun.com/zh/model-studio/batch-interfaces-compatible-with-openai ,更新时间 2026-11-04 20:08:16,抓取于 2026-11-06 11:00 CST
- 英文「Batch inference」:https://www.alibabacloud.com/help/en/model-studio/batch-inference ,Last Updated Nov 04, 2026,抓取于 2026-11-06 11:04 CST
- 中文「文本生成与视觉理解」:https://help.aliyun.com/zh/model-studio/text-generation-model ,更新时间 2026-11-05 00:20:31,抓取于 2026-11-06 11:06 CST
- 中文「上下文缓存」:https://help.aliyun.com/zh/model-studio/context-cache ,抓取于 2026-11-06 11:07 CST
本文不含任何真实 API 调用,未使用 API Key,也未提交 Batch 任务;涉及服务端实际行为(单行真实阈值、误差文件是否可下载、reasoning_content 是否返回)的部分一律标 UNKNOWN,不做推测性结论。